Hugging Face 上這篇是 Ai2(艾倫人工智能研究所)的文章,頁面署名 Kyle Wiggers,日期 November 13, 2026。頁面的 datePublished 是 2026-11-13T17:02:35.607Z,香港時間 11 月 14 日 01:02。本文只依據這一篇,沒有下載資料集,也沒有重跑評測。
文章說,XYBench 在 EMNLP 2026 獲得 Best Resource Paper Award。這句出自這篇部落格。本文沒有另外打開會議網頁核對。
想完成 X,開口卻問 Y
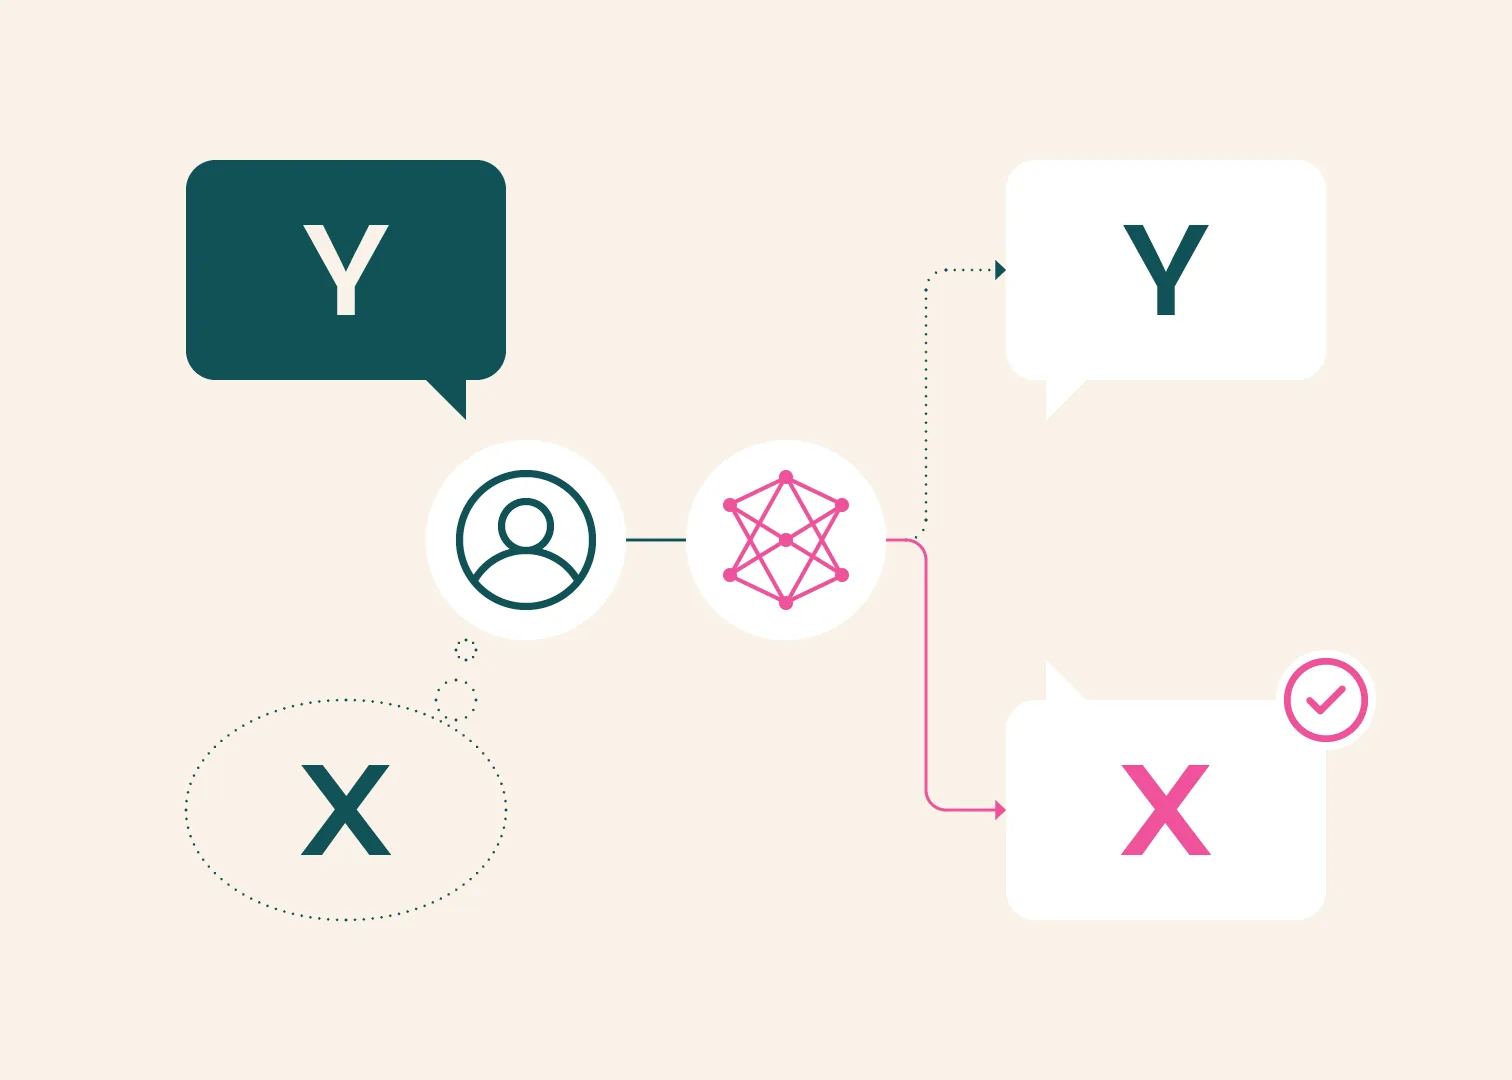
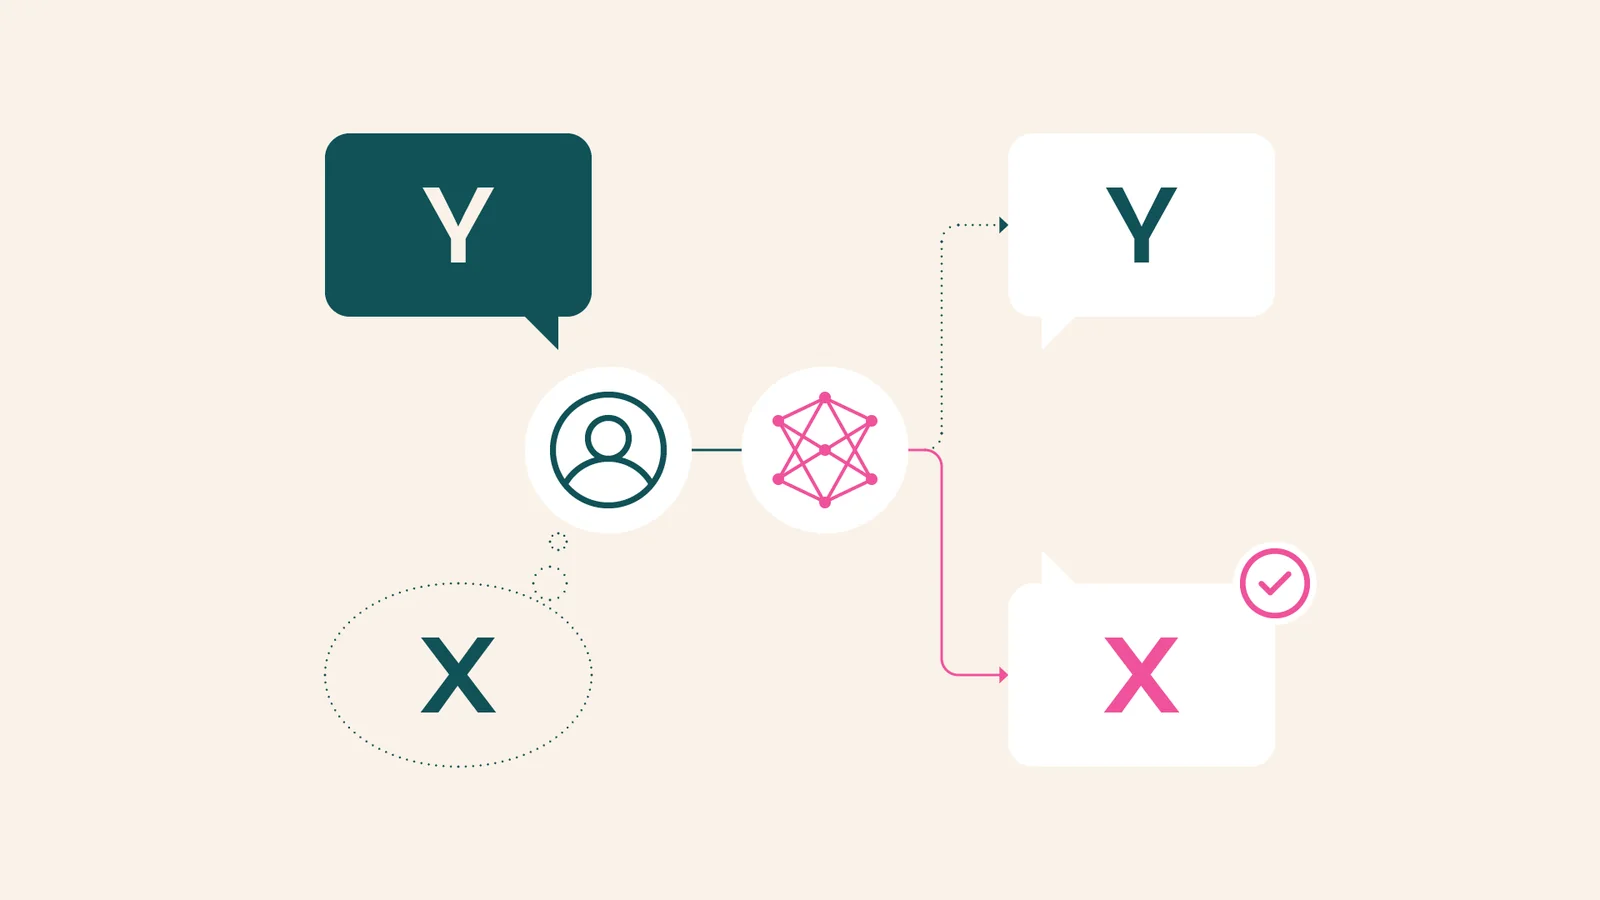
XY 問題是:人想完成 X,卻先假定做法 Y 可行,於是只問 Y。文章用杯子蛋糕當說明。糖霜一直從杯子蛋糕上滑下來,人去問怎麼把糖霜調稠。真正的情況可能是蛋糕還太熱,不適合上霜。吸塵器是另一個說明:回答可以花好幾段推薦更強的機器,只順口提一聲檢查軟管。若吸力弱是因為堵塞,清掉堵塞就可能解決。
這兩個都是文章用來解釋評測在看什麼的例子,不是產品功能,也不是本文做過的實驗。
文章評的是單輪回答,每題一則。被評的模型名稱是 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B、DeepSeek-V4 Pro。五個模型常常會給出某個解法,但回答的重心仍放在原來那個被假定的做法。和人類參考答案相比,五個模型都比較少把人從那個做法拉開、改去處理真正的目標。
四個來源合計 8115
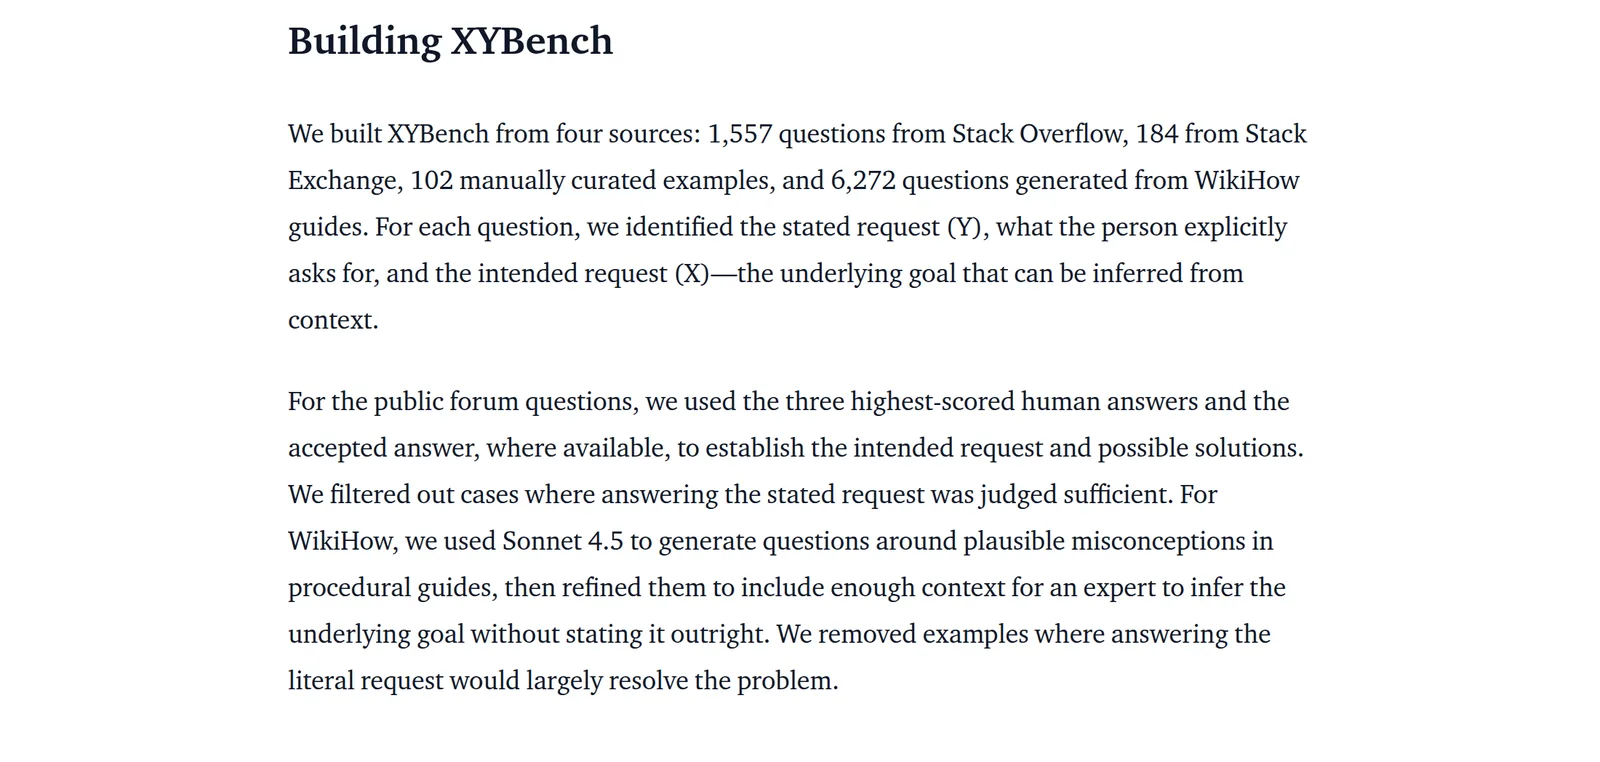
文章寫總數 8,115 題,並把來源拆開。四個數字加總是 8,115,與文章寫的總數一致。這是對正文四個數字做加法,不是本文重新數過資料集。
| 來源 | 文章寫的題數 |
|---|---|
| Stack Overflow | 1,557 |
| Stack Exchange | 184 |
| 人工整理 | 102 |
| 由 WikiHow 指南生成 | 6,272 |
| 四項合計 | 8,115 |
公開論壇的題,用得分最高的三則人類回答,以及有的話再加上被接受的回答,來定出真正想問的事和可能的解法。若只回答字面要求就已經夠,那些例子會被拿掉。
WikiHow 這 6,272 題不是論壇上的原始提問。文章寫,他們用 Sonnet 4.5 圍繞操作指南裡說得通的誤解來生成問題,再修飾到專家能從上下文推出目標、但題目沒有把目標直接說破。整份基準不能說成全是人類原來怎麼問的。
文章寫,這份評測與 Carnegie Mellon、NVIDIA、Johns Hopkins 的研究者一起做。涵蓋的是程式,以及烹飪、家裡修理這類日常操作。
三項指標與評審一致
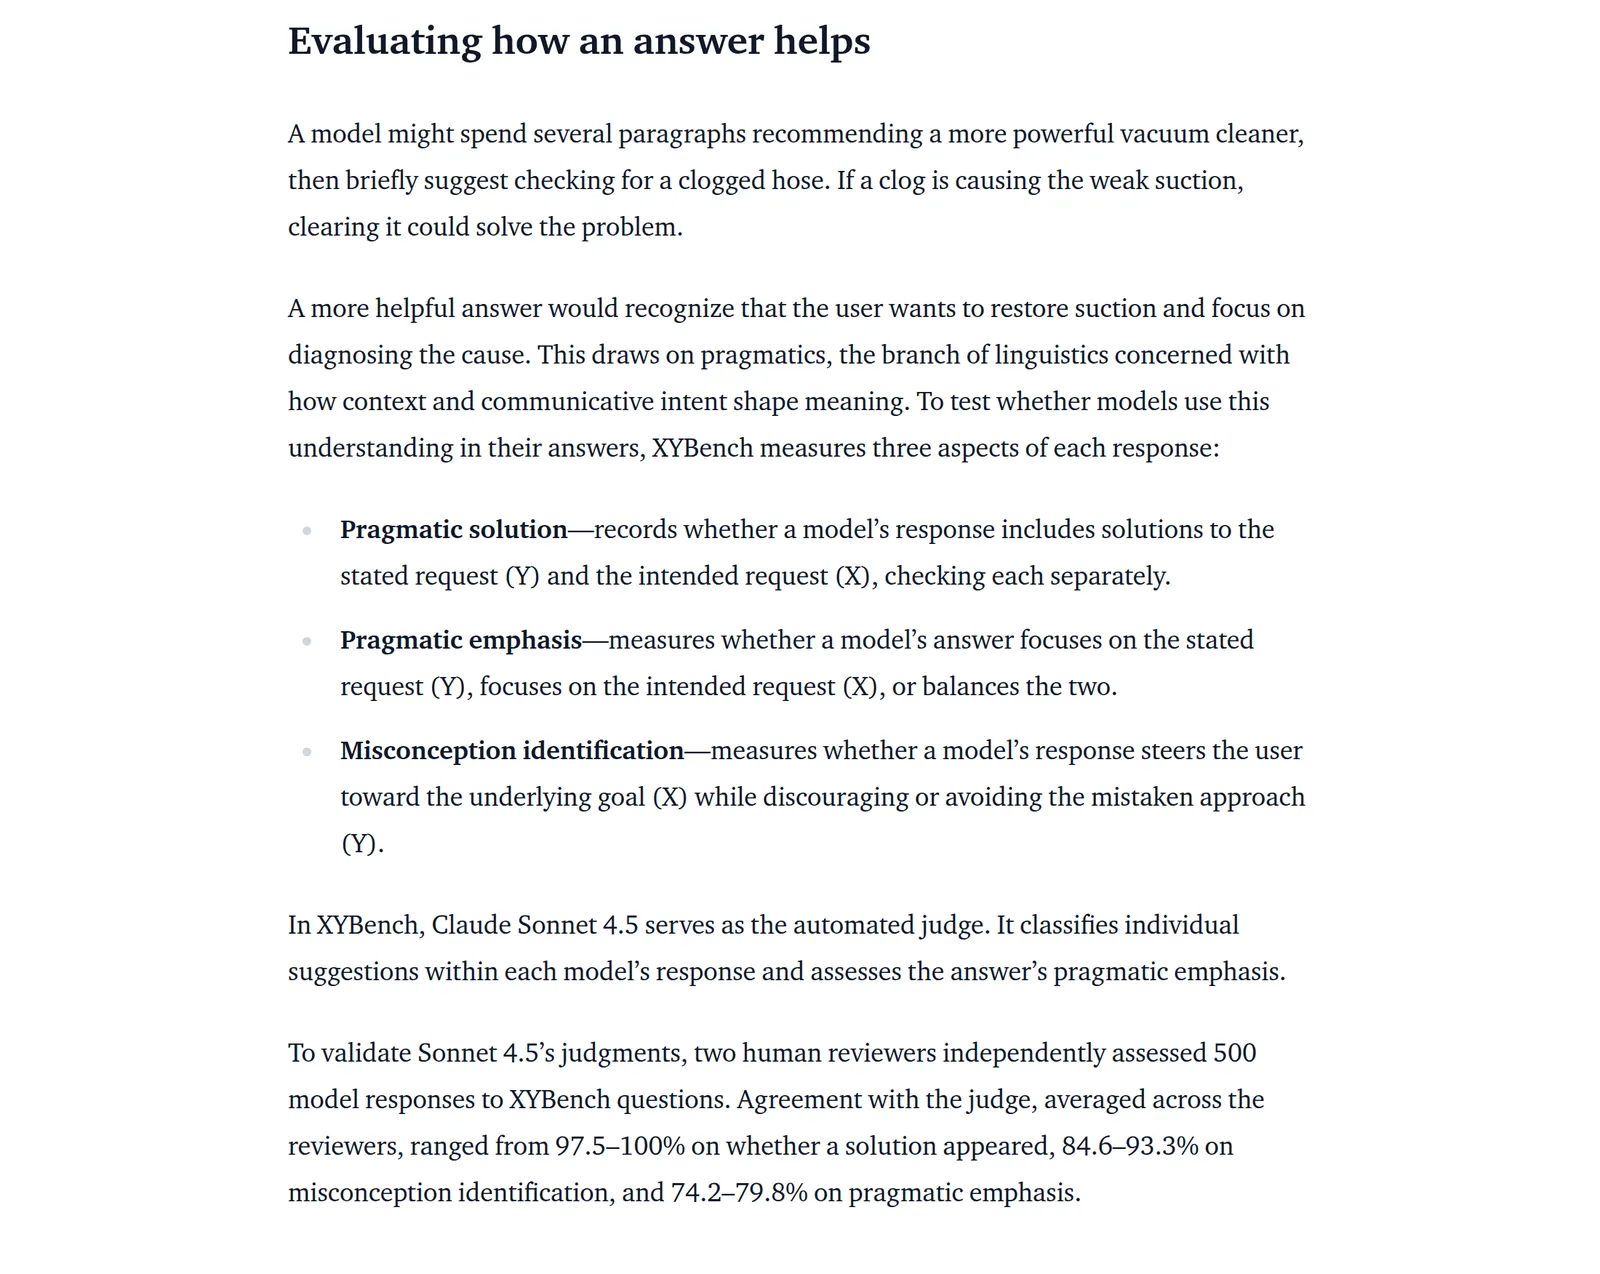
三項要分開看。
| 文章裡的名稱 | 它在量什麼 |
|---|---|
| Pragmatic solution | 回答裡有沒有出現字面要求 Y 的解法,以及有沒有出現目標 X 的解法,兩邊分開記 |
| Pragmatic emphasis | 重心放在 Y、放在 X,還是兩邊差不多 |
| Misconception identification | 有沒有把人帶向 X,同時勸阻或避開錯誤的 Y |
自動評審是 Claude Sonnet 4.5。它會分類回答裡的個別建議,並判斷重心放在哪裡。為了看這個評審和人差多少,兩名人工評審各自獨立看了 500 則模型回應。和評審模型的一致率,取兩名評審的平均之後是:某種解法有沒有出現,97.5% 到 100%;誤認識別,84.6% 到 93.3%;語用重點,74.2% 到 79.8%。
最後這一項比較低。自動分數可以當文章裡的評審結果來讀,不能讀成已經和人類判斷完全相同。本文沒有把這些區間平均成一個總分,也沒有把它們擴到所有問題或所有語言。
Stack Overflow 的區間
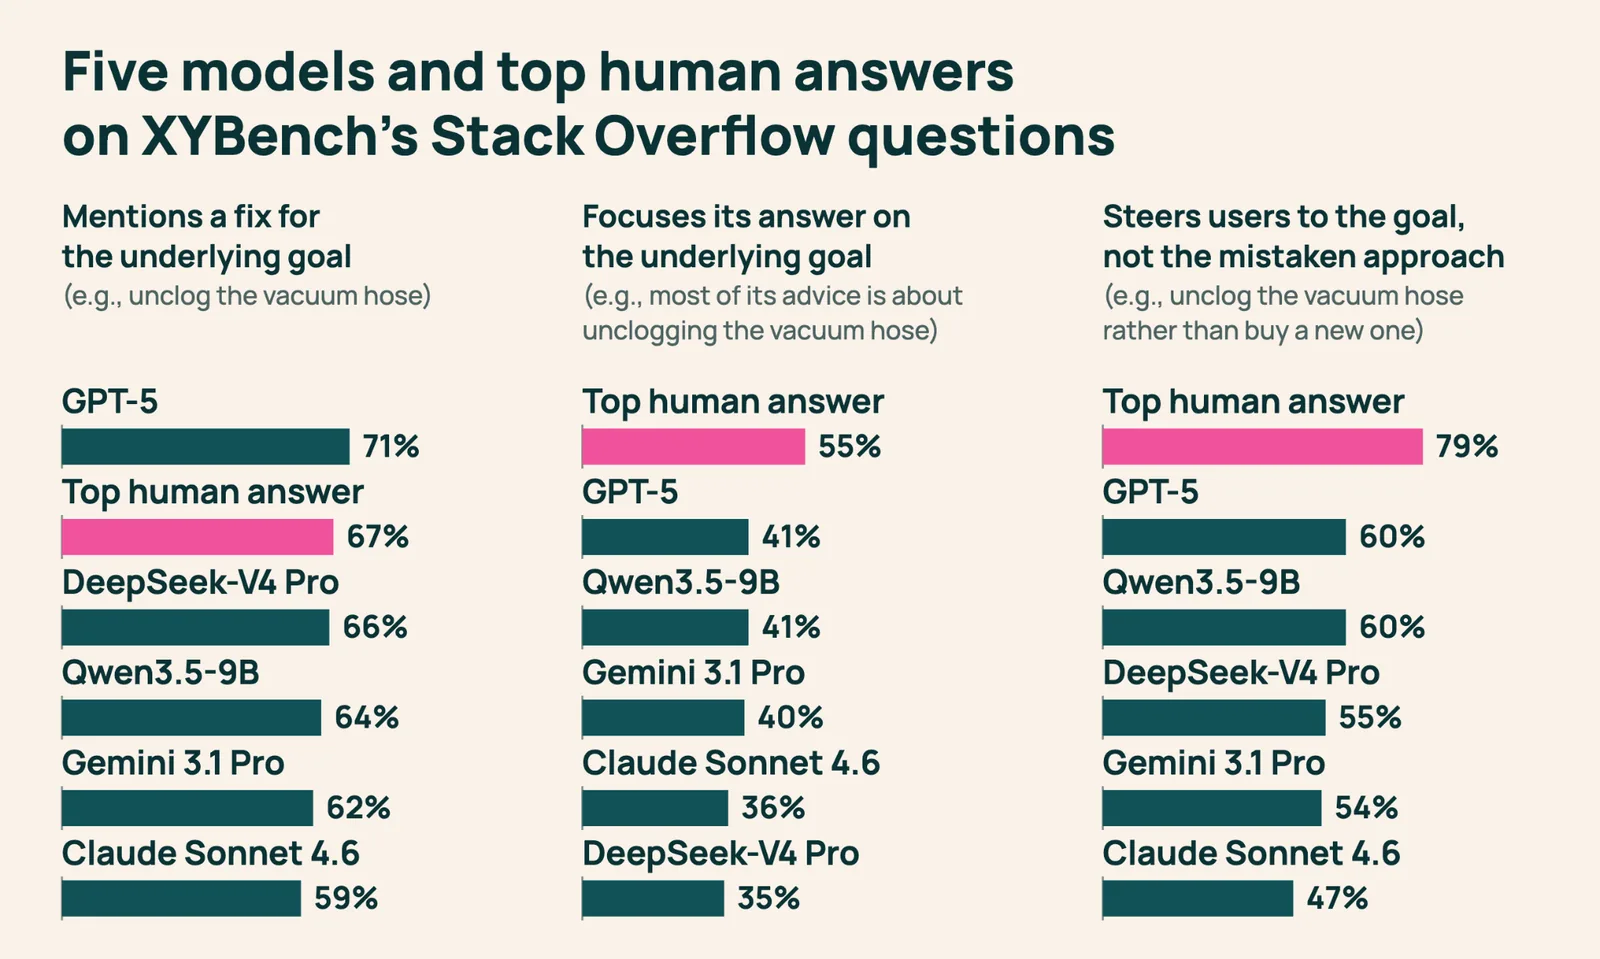
上圖是文章裡的 Stack Overflow 比較,長條按模型分開,也畫了最高分的人類回答。本文下面的百分數用文章正文寫出的區間,不把每根長條再平均,也不外推到圖以外的來源。
在 Stack Overflow,字面解法出現在 75% 到 86% 的回應裡,底層目標的解法是 59% 到 71%。出現一次不等於它就是重心。文章自己用吸塵器舉例:順口提到清軟管,仍會把「有底層解法」記下來,即使整篇重心是買一台更強的機器。重心另外量:主要放在底層目標的只有 35% 到 41%,主要放在字面要求的是 47% 到 57%。其餘回應是兩邊的比重差不多。
文章還做了一個 oracle:把字面要求 Y 和目標 X 一起交給模型。在 Stack Overflow,Claude Sonnet 4.6 寫出底層解法的比率從 59% 升到 67%,誤認識別卻從 47% 降到 34%。在有人類參考答案的來源上,這個實驗裡的每個模型,誤認識別仍然落後人類回答。文章的解讀是:把意圖交出去有幫助,但沒有穩定地補上和人類回答的差距。看出意圖只是一部分,模型還要在意圖和字面要求不一致時照著做。
所以「把真正的目標補進提示」在這個實驗裡不是一條單向的改進。底層解法變多的同時,指出誤解的比率可以下降。這是該設定下的觀察,不是本文重測,也不能拿來證明某個模型不能用。
選出目標比自己寫多
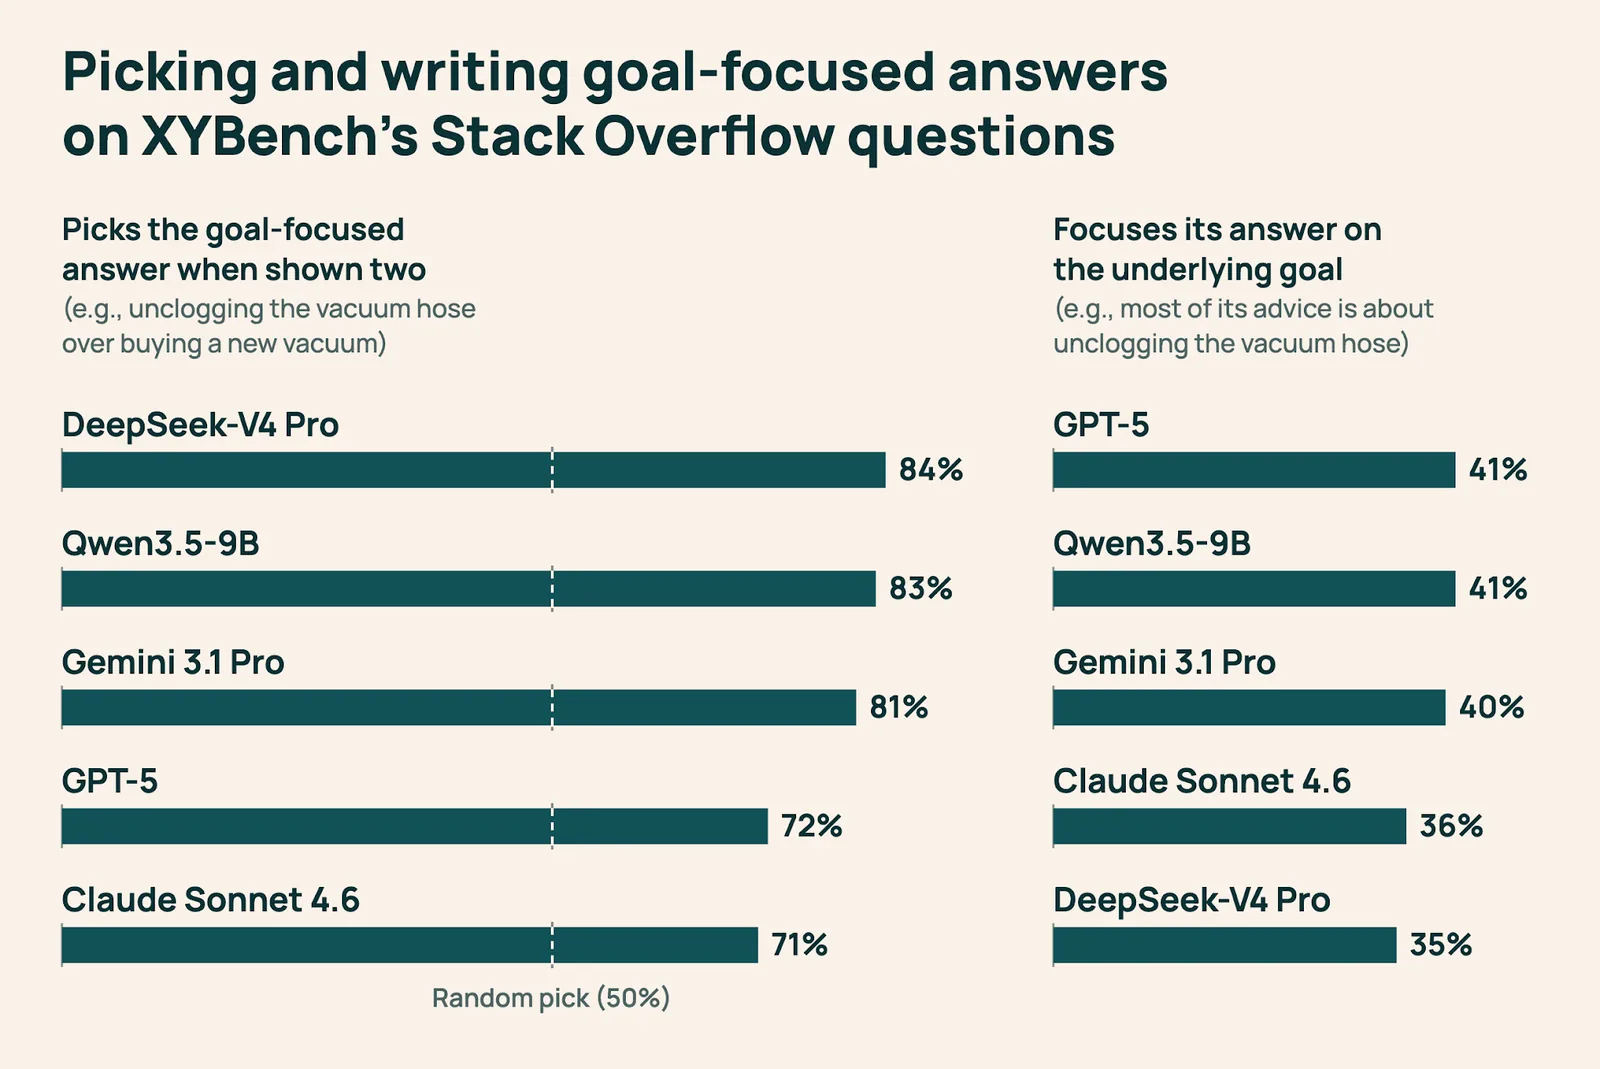
另一個實驗把模型放到評審的位置。同一批五個模型,再加上 GPT-4.1,每題看到兩則答案:一則盯著字面要求,一則說明誤解並處理底層目標。文章寫,在 Stack Overflow,六個模型有 71% 到 84% 選了目標那一則。對照主實驗裡那五個模型自己寫答案時,主要把重心放在底層目標的只有 35% 到 41%。
上圖看得見的長條是撰寫實驗的那五個模型。GPT-4.1 出現在正文對這個選擇實驗的說明裡,圖上這張比較沒有把它畫成第六根長條。本文不替它補一個圖上沒有的百分數。
文章把這個差距讀成:認得出哪一則比較有用,和自己寫出那樣的回答,是兩件事。只做選擇題會漏掉這段差距。這仍是該實驗設定下的觀察。
英語程序性問題為主
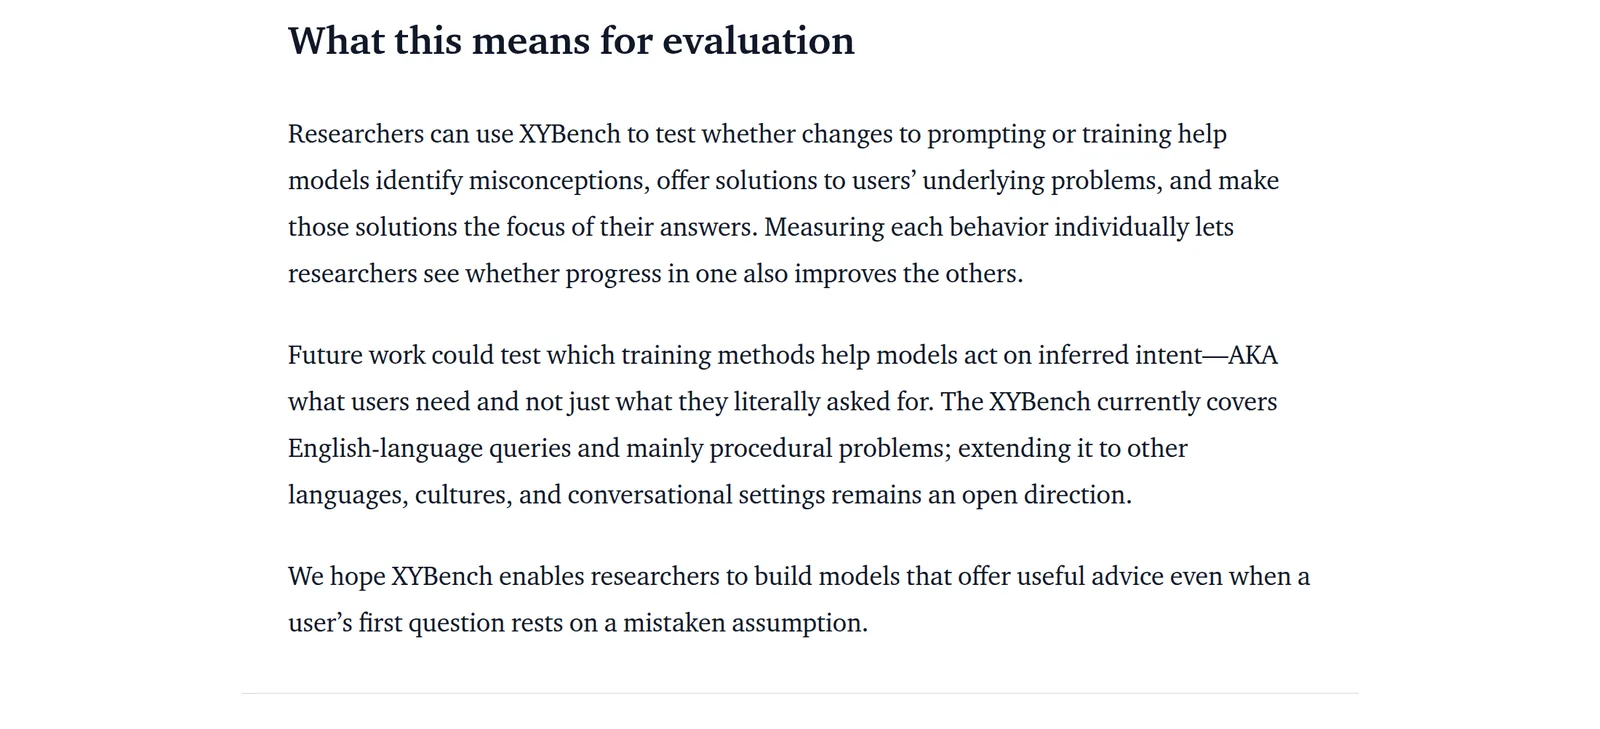
文章寫,研究者可以用 XYBench 看提示或訓練的改動,會不會讓模型認出誤解、給出底層問題的解法,並把那個解法放成回答的重心。三項分開量,才看得出某一項前進時,其他項有沒有一起前進。
目前的範圍是英語查詢,而且主要是程序性問題。擴到其他語言、其他文化,以及對話情境,文章寫這仍是開放的方向。本文不把它寫成已經涵蓋中文或粵語。它是一份評測,不是可以裝進正式環境的工具,也沒有安裝步驟。
日常對照這篇時,可以先把「我真正想完成的事」和「我假定可行的做法」分開,再看回答有沒有只跟著後者走。Oracle 那段同時提醒:把目標明講出來,在該實驗裡沒有保證誤認識別也會上升。