筆電複現「猜遊戲」實驗
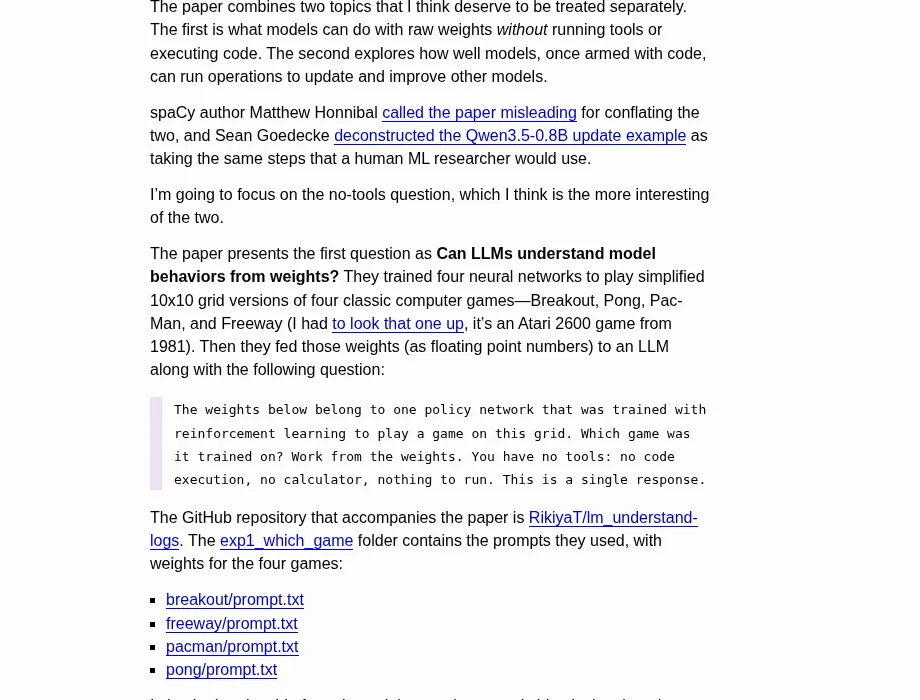
Simon Willison 於 2026 年 11 月 3 日寫道:MIT CSAIL 的 Weight-Space Programming 貼文很熱,他拿論文 exp1(四個小遊戲策略網路:Breakout、Pong、Pac-Man、Freeway)的公開 prompt,在自己筆電上試。
【事實|Willison】 模型是本地 Qwen 3.8 27B(作者說約 17GB,經 LM Studio + llm 工具),不是論文裡被 Astra 改權重的 Qwen3.5-0.8B。Prompt 要求:只看 raw 浮點權重、無工具、不跑程式、單一回應,猜這組權重是為哪個遊戲訓練的。
站內昨日摘要見 LLM 能直接讀寫神經網路權重;Honnibal 的敘事批判見 Astra 權重實驗被指敘事誤導。
三款遊戲辨識成功
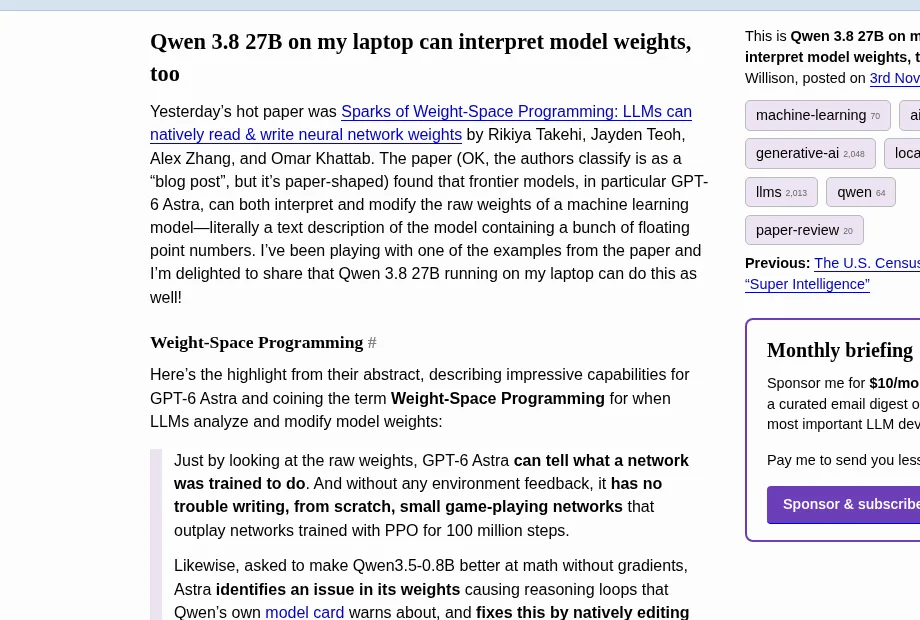
【事實|Willison 實測數字】
| 遊戲 | 結果 | 費時 | 推理 token(作者記錄) | 信心 |
|---|---|---|---|---|
| Pac-Man | 正確(Pac-Man 風格格子世界) | 46m 12s | 43,506 | 72% |
| Pong | 正確(右側直拍/球) | 1h 4m 54s | (未寫) | 75% |
| Breakout | 正確(Arkanoid 類) | 52m 25s | (未寫) | 88% |
| Freeway | 失敗(誤判成類 Pac-Man) | (未寫) | (未寫) | (未寫) |
作者註:預設 8192 context 會出錯,需加長上下文;並把 LMSTUDIO_TIMEOUT 調高。他也用雲端 Kimi K3.1 Pro 跑過 Breakout(約 9m 41s、19,493 reasoning tokens)作為對照。
無工具讀權重比較有趣
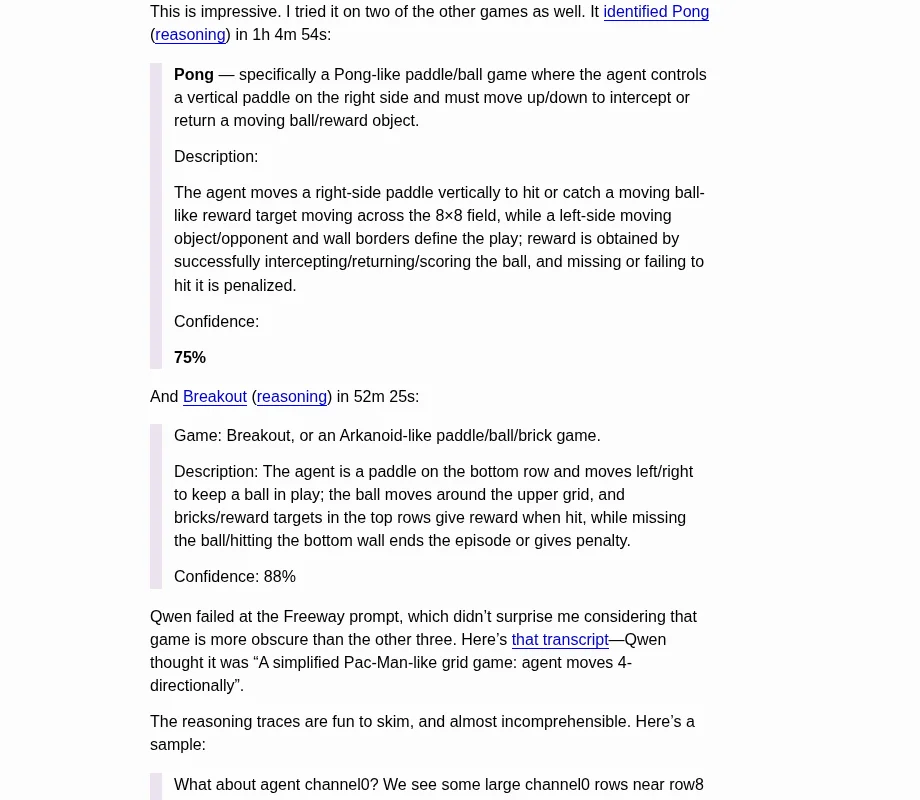
Willison 同意 Honnibal:原貼把兩件事捆在一起:
- 無工具讀 raw weights(他複現的這條)
- 有程式碼時如何改/提升另一個模型(Qwen 數學 headline 屬這條)
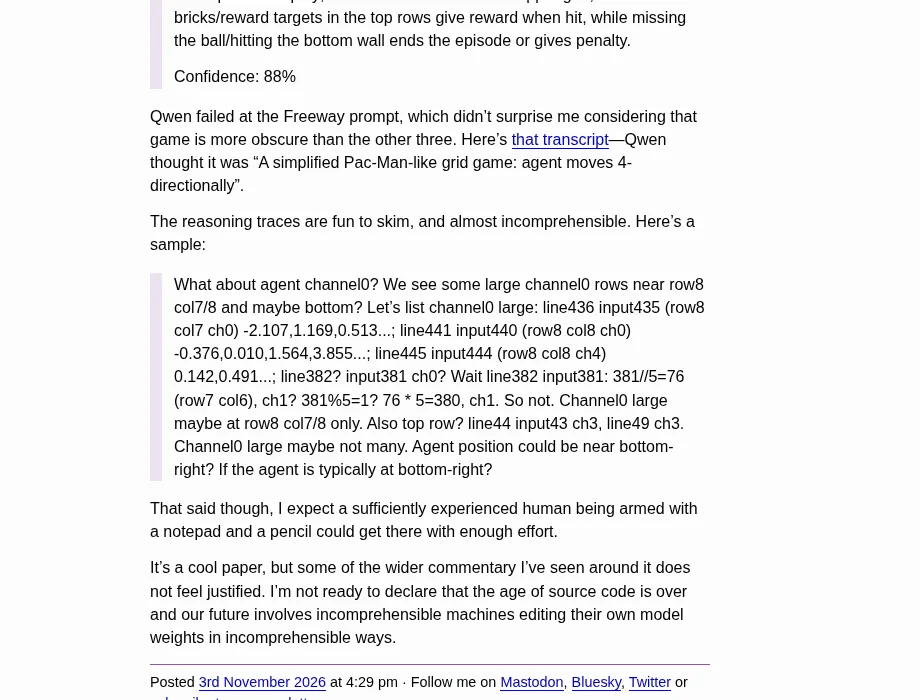
他選擇只深挖第 1 題,並寫:推理軌跡幾乎難以讀懂,但「一個夠有經驗、拿筆記本的人 theoretically 也走得到」;他還不願宣稱「原始碼時代結束、未來是機器用不懂的方式改自己的權重」。
自己試要注意什麼
若你想跟做:
- 用論文 repo
RikiyaT/lm_understand-logs裡exp1_which_game的 prompt(各遊戲除權重外相同) - 本地載入 Qwen 3.8 27B,預留長 context 與足夠逾時
- 把結果標成「無工具、小策略網路」,不要和「Astra 改 Qwen3.5-0.8B 數學」混成同一結論
這證明的是:在作者的硬體與設定下,開源 27B 級模型也能做極小網路的權重解讀;不是說筆電模型已能隨便改寫數十億參數的商用 LLM。