電視下方的模型伺服器
最近在 Hacker News 引起討論的開源專案 PS5LM,標語是:「你的 PS5 跑語言模型,網路上的每台裝置都能用它。」
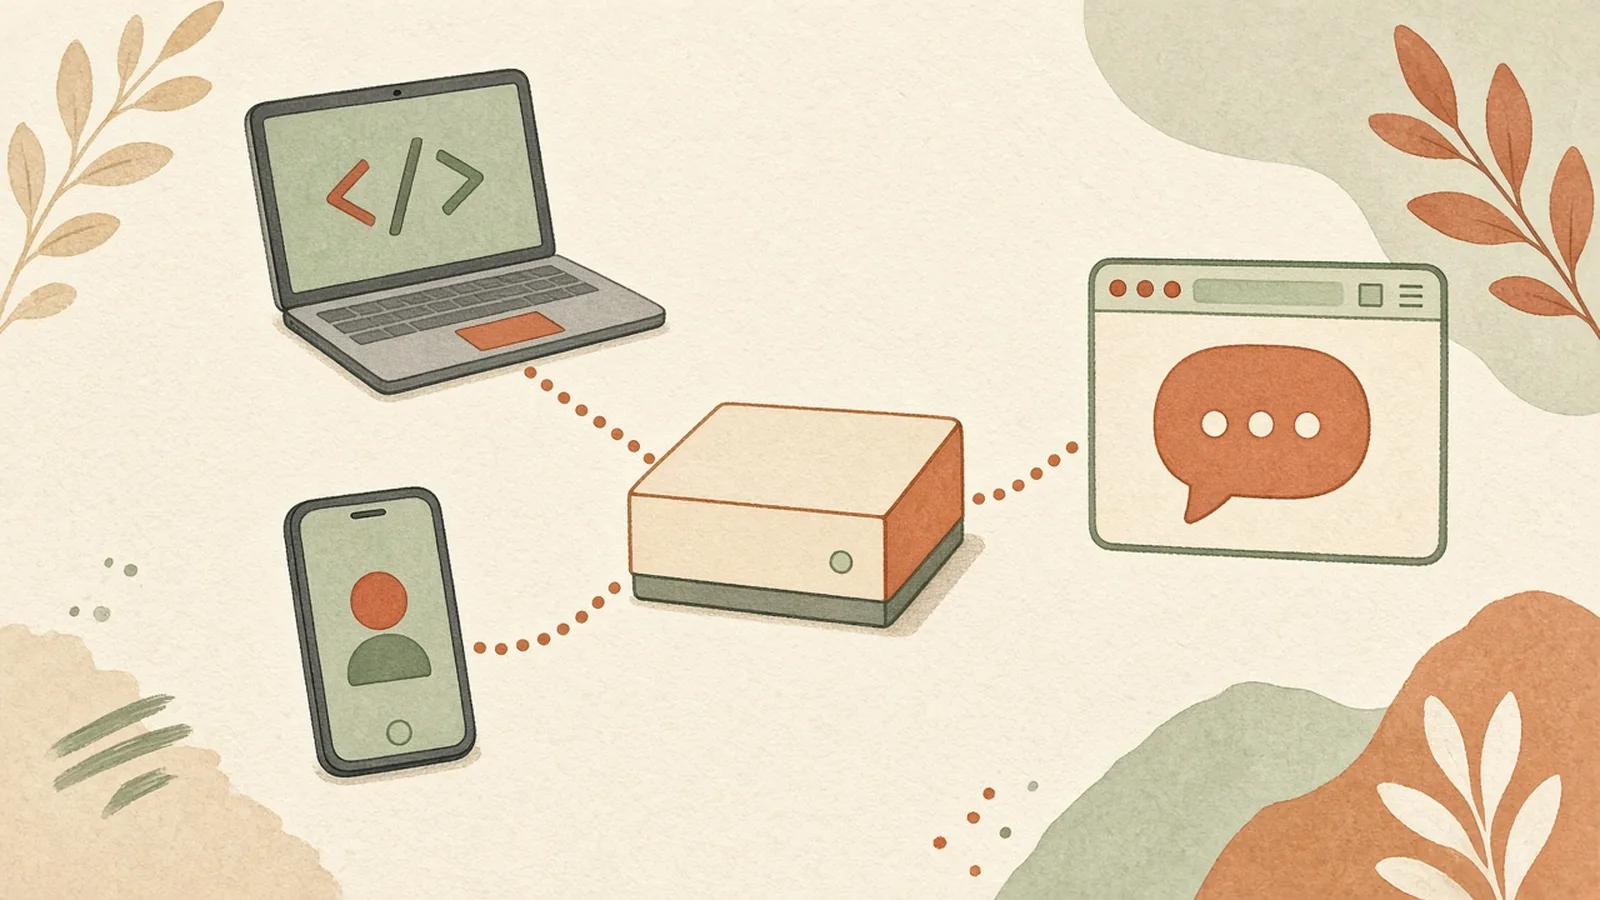
依專案 README,PS5LM 是給已破解 PS5 的使用者、想在家裡架私人模型伺服器的人用的。它把 GGUF 模型載入主機的 GPU,再提供給筆電、手機和寫程式工具使用;運作時不需要電腦、雲端或帳號。
- 跑在 GPU 上:使用 llama.cpp 的 Vulkan 後端,在主機的 RDNA 2 GPU 上執行,共享記憶體中有 11.4 GB 可放模型與上下文。
- 相容常見 API:提供 OpenAI 的
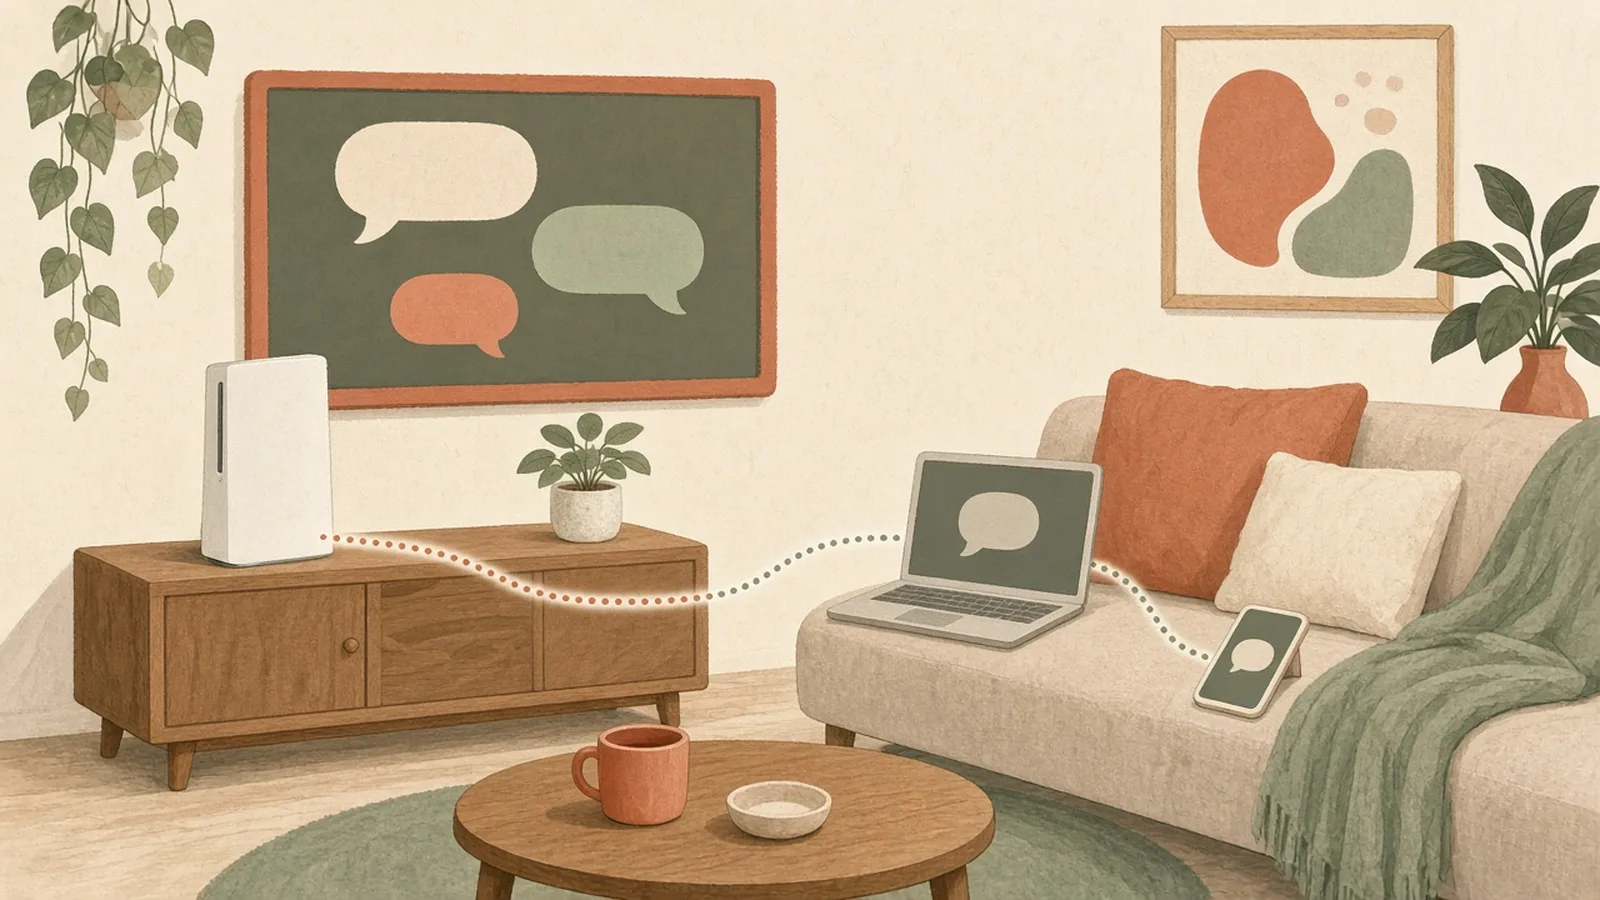
/v1/chat/completions與 Anthropic 的/v1/messages,README 註明 Claude Code 可以接上,也有瀏覽器聊天頁。 - 在電視上顯示過程:每個請求都會以聊天形式出現在電視上,看得到是哪台裝置問了什麼、回答如何逐字寫出。
- 監看主機狀態:Console 頁面會畫出溫度、功耗、GPU 與 CPU 負載。
- 自動挑選設定:規劃器會讀取每個 GGUF,依剩餘記憶體給出最長的上下文與最佳快取設定,也能直接從 Hugging Face 下載模型。
PS5 Slim 實測速度
README 列出作者在 PS5 Slim 上的數字(非本站實測):
| 模型 | 大小 | PS5 Slim 上的表現 |
|---|---|---|
| Qwen 3.5 0.8B,Q4_K_M | 0.5 GB | 每秒 207 個 token |
| Qwen 3.5 9B,Q4_K_M | 5.3 GB | 每秒 55 個 token |
| Qwen 3.8 27B,UD-Q2_K_XL | 9.2 GB | 約每秒 20 個 token,64k 上下文 |
| d1 Omni 600M(決策模型) | 1.1 GB | 3 個問題 0.3 秒;一張 720p 圖片加 7 個問題 2.9 秒 |
除了一般語言模型,專案也支援「決策模型」:讀入一段狀態後,一次前向運算就回答有型別的問題(例如選擇題或是非題),不產生文字。
授權與法律界線
PS5LM 採 GPL-3.0-or-later 授權。README 特別聲明:程式庫中沒有 Sony 的 SDK 檔案、金鑰、韌體或模型權重;專案與 Sony Interactive Entertainment 沒有關係,「PlayStation」與「PS5」是 Sony 的商標。README 也致謝了 llama.cpp、ggml 等開源專案。
使用 PS5LM 的前提是主機已經破解。本站不提供任何破解步驟;破解遊戲主機可能違反使用條款、影響保固,各地法律規定也不同,請自行評估。
本站觀點(非來源內容):這個專案有趣的地方,在於它說明了只要有一顆 GPU 和足夠的記憶體,很多閒置的家用設備都可能變成小型 AI 伺服器。如果只是想在家跑本地模型,用一般電腦或 Mac 會是更單純、風險也更低的選擇。