只回傳機率的模型
Perplexity 文件把 pplx-decider-v1.2 與 pplx-decider-flash-v1.2 稱為「決策模型」:它像多模態語言模型一樣讀文字與圖片,但不寫回覆、不產生程式碼、也不解釋推理,而是回傳帶機率的結構化答案,由你的程式依數字做判斷。
你把內容放在 state(可以是文字、JSON 或圖片),附上一個或多個具名問題,每題得到一個答案:
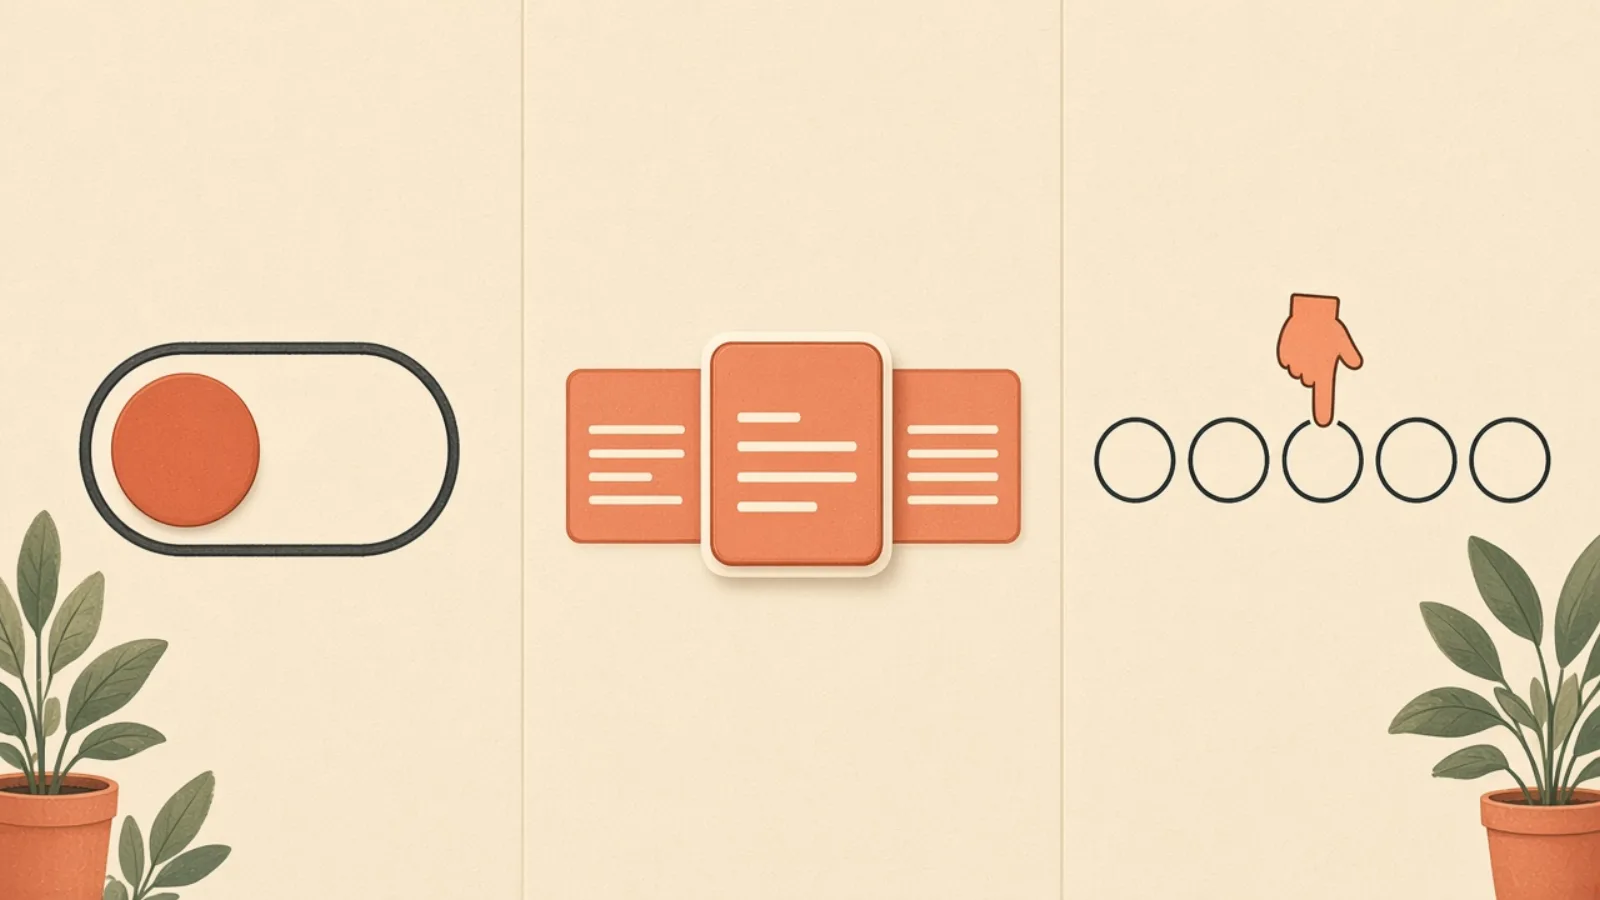
| 題型 | 你問什麼 | 你拿到什麼 |
|---|---|---|
| noul | 是非題,或要檢查的陳述 | 「是」的機率,0 至 1 |
| choice | 從你定義的選項中選一個 | 每個選項的機率,加上最可能的選項 |
| score | 依有序評分表打分 | 每個等級的機率,加上期望分數 |
價格與模型規格
官方文件寫明,Decisions API 依百萬輸入 token 計費:pplx-decider-v1.2 為 0.02 美元,pplx-decider-flash-v1.2 為 0.01 美元,輸出 token 免費。文件範例中,一次問三題的回應只用了 3 個輸出 token。
Hugging Face 模型卡顯示,v1.2 以 Qwen3.8-27B 為基礎微調,約 260 億參數。這個模型庫是公開的,權重可以免授權直接下載,授權為 Apache-2.0(模型卡內文仍寫著需要存取權,但 Hugging Face 頁面資訊顯示為公開、未設下載門檻)。不過本機執行需要 CUDA GPU,模型卡註明光是 BF16 權重就約需 52 GiB 記憶體,還要加上運算所需的空間;權重檔合計約 52 GB。對一般人來說,本文建議直接透過 Perplexity API 呼叫,比較實際。
把判斷題拆出來
官方建議的使用時機,是那些你原本會請聊天模型「給個標籤」再解析回覆的地方:分類、路由、依評分表打分,或任何想設門檻的決定。好處是拿到可以和門檻比較的數字、不必解析輸出,而且同一份內容可以一次問多題。
我們整理幾個適合拆出來的情境:
- 客服或表單分流:先用是非題判斷「是否在回報產品瑕疵」,機率超過你設定的門檻才轉給專人。
- 內容審核:用 choice 題判斷類別,接近 0.5 的不確定案例留給人工看。
- 品質評分:用 score 題依評分表打分,聊天模型只負責真正需要寫字的回覆。
本文建議:我們的看法是,先從一個每天大量重複的判斷工作開始試,記錄模型機率和人工判斷的差異,再決定門檻。