NVIDIA 擴充 Nemotron 線
NVIDIA 在 2026 年 10 月 15 日 釋出 Nemotron 3.5 Super VL:開源的 1200 億參數(120B)多模態模型,採 mixture-of-experts(MoE),每個 token 啟用約 120 億參數(12B)。同日還推出邊緣向的 Nemotron 3.5 Bolt 74B-A9B 24GB;更小的 Bolt E4B 4GB 官方寫道將於 10 月 23 日 推出。
官方定位是:從大型企業伺服器一路到本機/邊緣硬體,都有對應的開源、可客製代理模型,不必在「能力」與「能不能部署」之間二選一。Super VL 與 Bolt 加入既有的 Lightning(高吞吐)與 Ultra(最難推理)家族線。
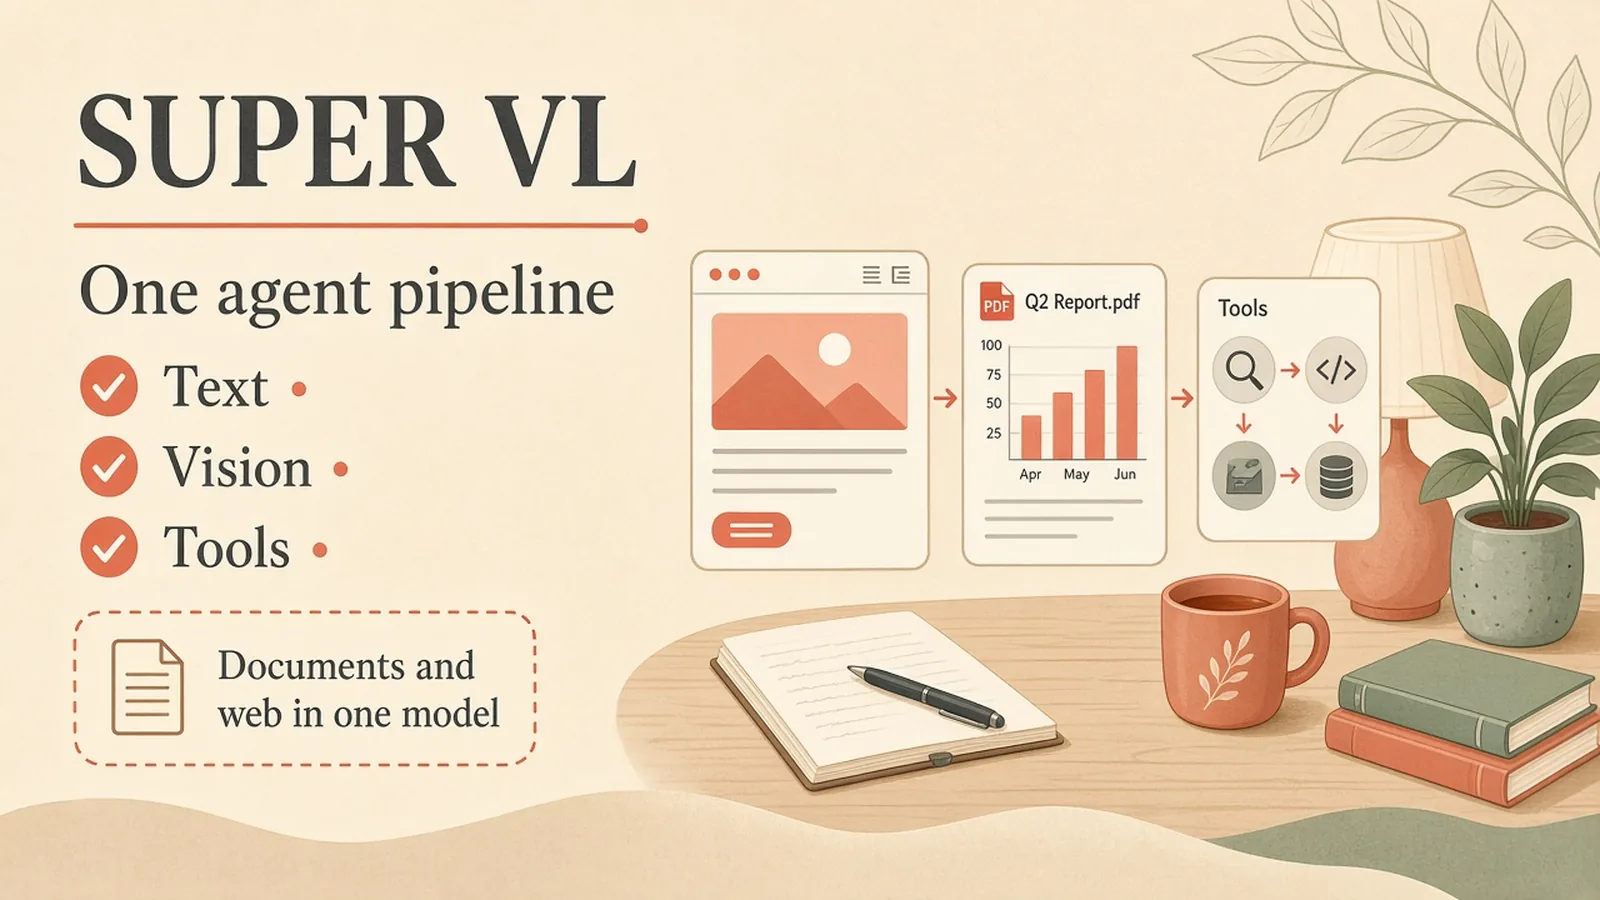
Super VL:120B 多模態代理
開發者部落格寫道,Super VL 把推理、指令遵循、工具呼叫,以及文字、影像、文件與影片理解收進同一模型,減少「文字模型+另一套視覺模型」之間反覆傳上下文的成本。目標工作流包含寫碼除錯、網頁研究、文件智慧(表格/圖表/版面)、資安分流,以及影片理解。
官方稱它是同類開源代理模型中最快者,代理任務吞吐可達同級下一名的約 5 倍;並在 Artificial Analysis Intelligence Index 的 agentic 任務上,於 Baseten endpoint 展示超過 600 TPS(見開發者文圖)。與封閉前沿模型不同,組織可在自有資料上後訓練、部署在自有基礎設施,並掌握建置內容。
視覺能力聚焦代理實務:OCR、表格、圖表與結構化文件;可處理網頁、抽出文字、讀圖表,並對 PDF 等常見文件採取行動。
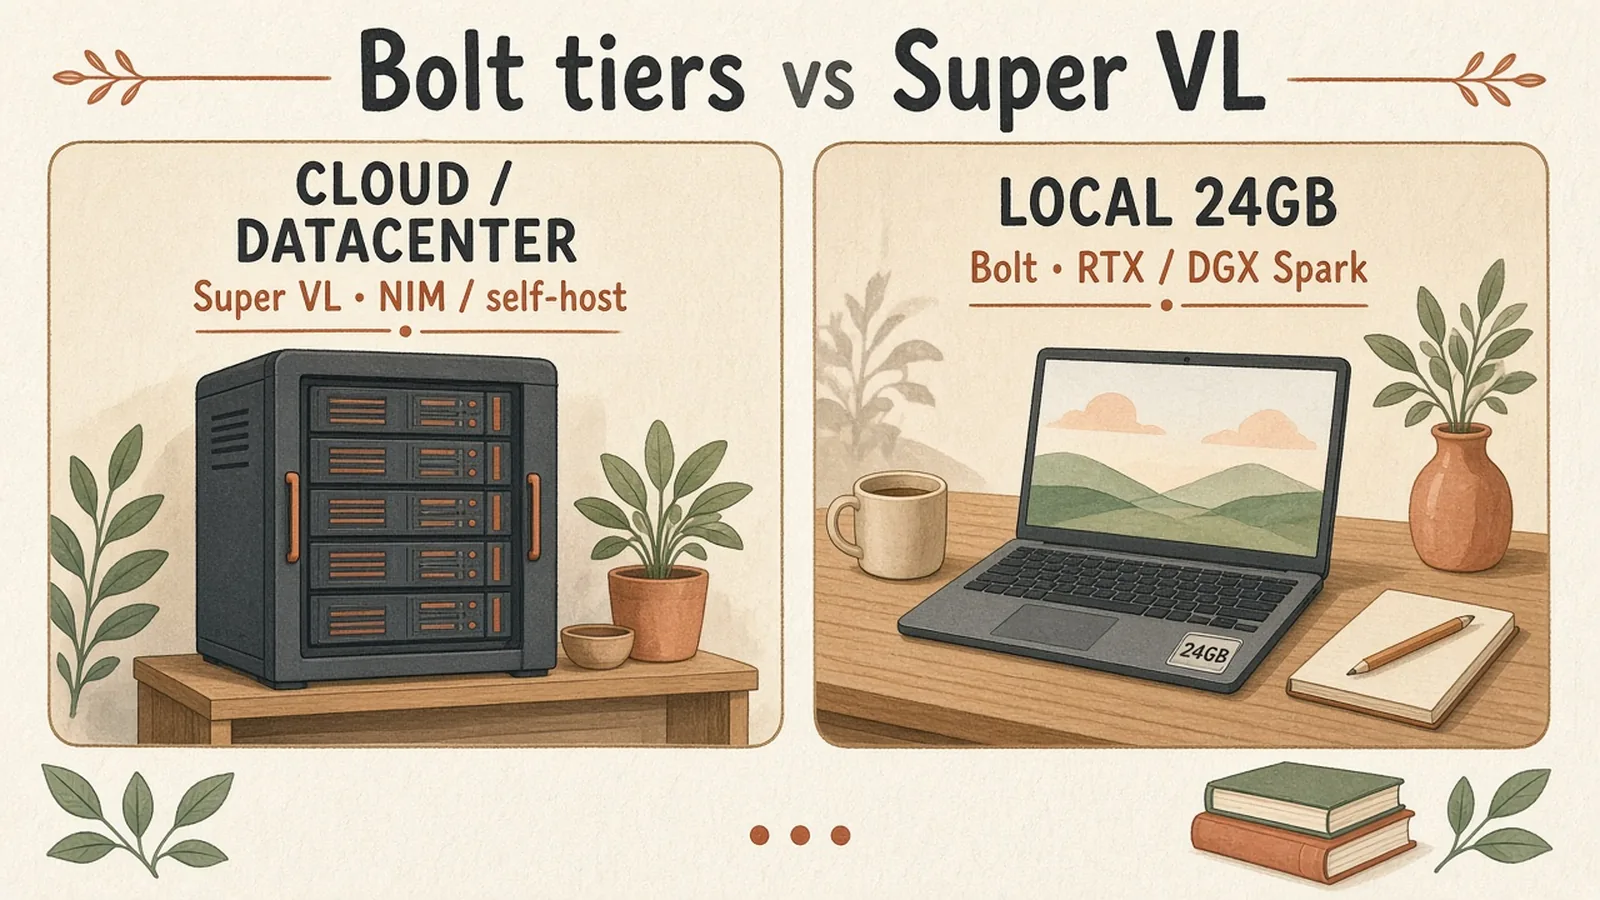
Bolt:24GB/4GB 本機分層
Bolt 74B-A9B 24GB 採原生 2-bit 量化,官方寫道可塞進 24GB 記憶體,在 NVIDIA RTX/DGX Spark 上與其他應用並跑,把日常代理(上網研究、寫作、除錯)留在本機,不必把工作負載送上雲端。相對同記憶體足跡的其他模型,官方強調「夠聰明、又比最聰明那檔快」。官方另稱它是同類 PinchBench 開源第一、BrowseComp 開源第二。
Bolt E4B 4GB 對準 GeForce RTX、Jetson 與 RTX/DGX Spark 上的實體與對話代理:結合自然對話與多輪代理能力,服務本機語音助理、互動角色與嵌入式介面;上市日為 10 月 23 日。
| 模型 | 定位 | 記憶體/部署 | 可用性(官方) |
|---|---|---|---|
| Nemotron 3.5 Super VL | 資料中心/企業代理;多模態 | 120B MoE(每 token 啟用 12B);NIM/自架 | 即日起 |
| Bolt 74B-A9B 24GB | 本機日常代理 | 原生 2-bit;約 24GB;RTX/DGX Spark | 即日起 |
| Bolt E4B 4GB | 對話/嵌入式代理 | 約 4GB;RTX/Jetson/Spark | 2026-10-23 |
Hugging Face 檢查點示例:nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16、nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB。
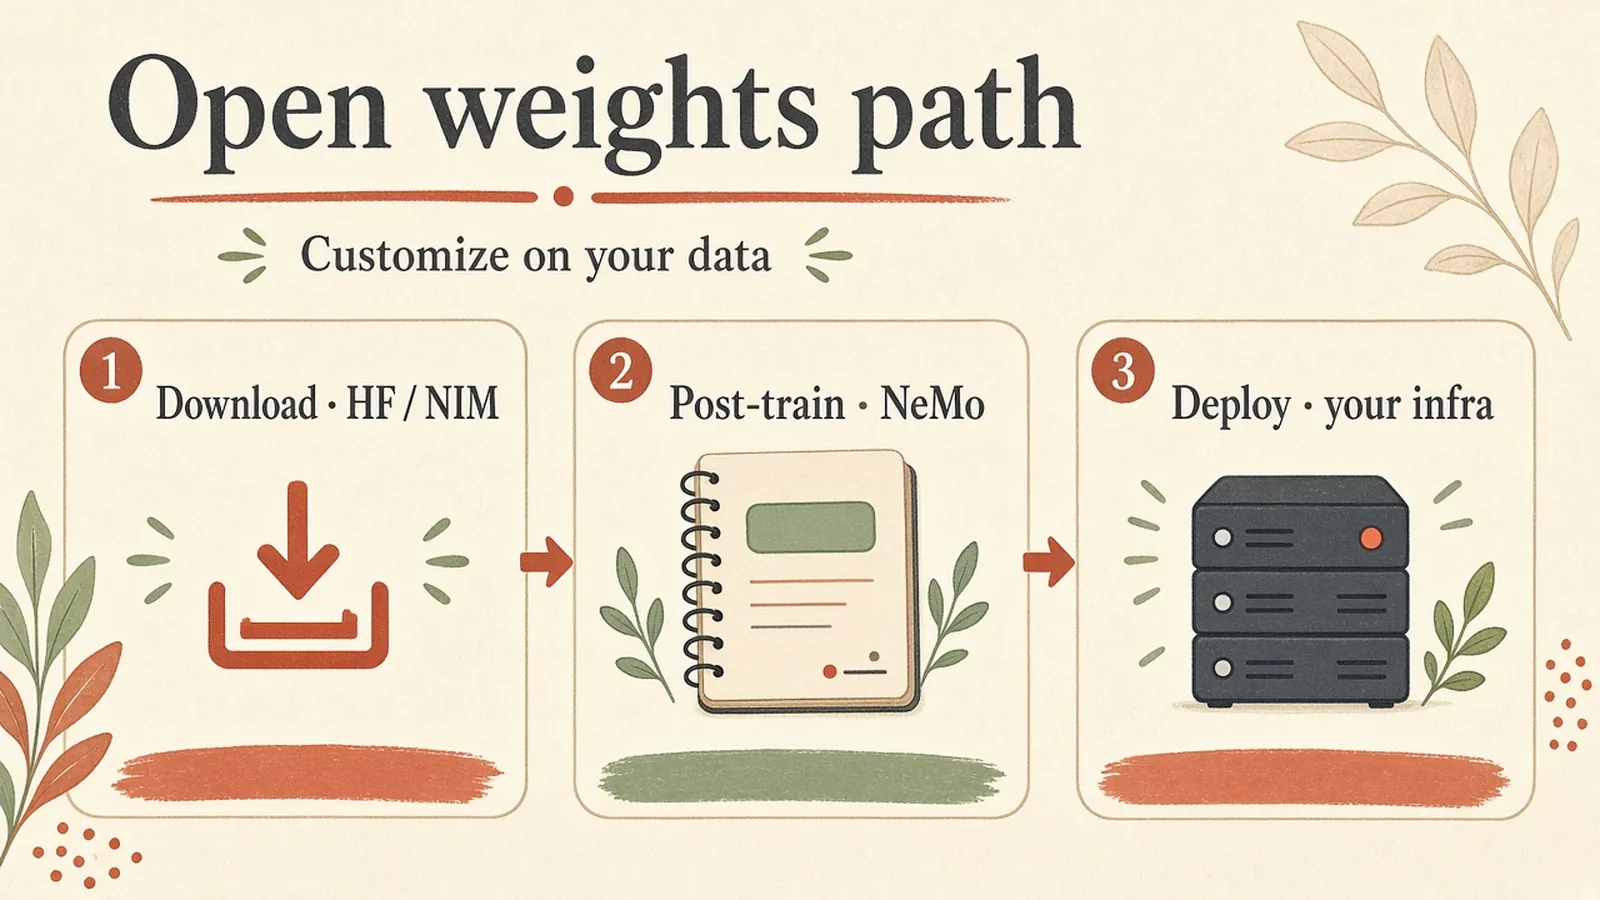
開源權重、資料集與後訓練
官方寫道模型附帶開源權重、開源資料集與訓練配方;可透過 NVIDIA NeMo、Python pipeline 與開放資料集客製。預訓練與持續預訓練合計約 26 兆(trillion)tokens,後訓練約 380 萬樣本,並跨多個環境做強化學習。Hugging Face 另釋出涵蓋工具使用、金融、指令遵循、長上下文、公平性與視覺—語言理解等資料集,以及 NeMo Gym 中的 RL 環境。
企業客製案例(數字皆來自 NVIDIA 官方文,非本文自測):
| 組織/場景 | 官方所述結果 |
|---|---|
| Scale AI × Skydance(供應商信用處理) | 推論成本降約 40 倍、延遲降約 5 倍 |
| Ramp(收據影像→結構化 JSON) | 預期吞吐最高約 +50%、延遲約 10 倍改善 |
| AI21/Alice(威脅情報與弱點分析) | 準確率約 +41% |
亦提到 Atlassian、CrowdStrike、Dassault、Perplexity、Salesforce Missionforce、Synopsys 等整合或客製方向。生產部署可走 NVIDIA NIM 微服務(約每兩週更新安全與效能),並可搭配 Dynamo 服務更多使用者、降低延遲(官方稱最高約 8 倍使用者、延遲降約 85%)。
一人公司:雲端代理還是本機 24GB
對香港/台灣的一人公司與中小企業,這次比較務實的讀法是:
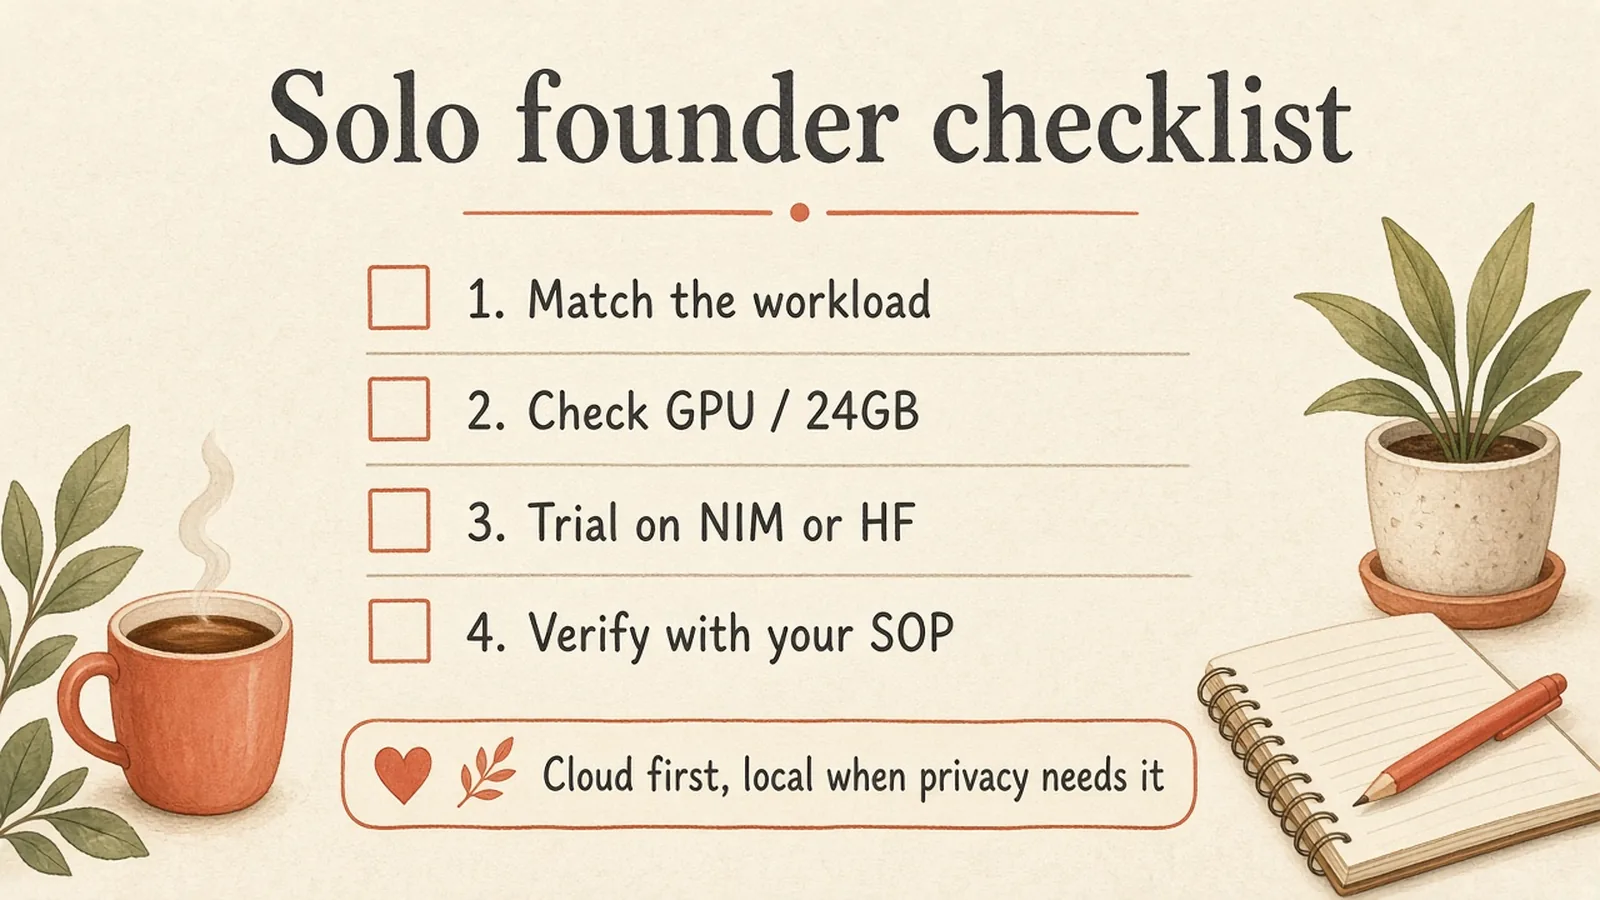
- 先對齊工作負載:多模態文件、長流程工具呼叫、要後訓練自家政策 → 看 Super VL(NIM/自架 GPU)。日常本機研究/寫碼/除錯、資料不想出機 → 先看 Bolt 24GB。
- 硬體門檻要算清楚:Bolt 74B 官方寫的是 24GB 記憶體足跡與 RTX/DGX Spark;沒有對應本機 GPU 時,優先用 Hugging Face、Open Router、ModelScope 或 NIM 試流程,不要先買卡。
- 數字當方向、用自己的任務驗證:官方 5× 吞吐、客製案例的 40×/10× 都是 NVIDIA 或其夥伴場景;換成你的發票、客服腳本或內部 SOP,結果可能不同。
- E4B 可排進 10/23:若你要語音助理或嵌入式對話,等 4GB 版比硬塞 24GB 更划算。
現在就能下載與試用
Super VL 與 Bolt 74B 官方寫道已可於 Hugging Face、Open Router、ModelScope 社群取得,並提供 NVIDIA NIM。下一步很具體:到 NVIDIA 部落格原文 對齊產品線,再到 HF 下載 Super VL 或 Bolt 24GB 權重,用同一組「文件+工具」任務對打雲端與本機,再決定要不要為隱私與批次成本上 24GB 本機卡。