遮蓋後仍公開基準圖
METR 在 2026 年 11 月 5 日公布這份評估。工作期間是 2026 年 8 月 12 日至 10 月 29 日,約 2.5 個全職人力,在 Anthropic 做高權限評估,看 AI 把 AI 研發加快了多少。這不是新的公開模型公告。METR 寫明,這次沒有抽樣非公開模型,也不是 10 月 15 日那項「像員工一樣存取」的計畫。
Anthropic 可以遮蓋報告裡的非公開資訊。METR 可以公開:有這次審查、遮蓋權有沒有被使用、結論是否明顯依賴被遮住的證據,以及拿到的存取程度。報告寫,最高層的風險結論可以自由寫,但他們覺得最有資訊量的證據,多數被遮掉了。Anthropic 把遮蓋說成是為了拿掉可能讓其它 AI 開發者加速的機密。METR 寫,因此公眾比理想情況更得依賴 METR 的判斷。The Verge 在 11 月 7 日的報導複述了同一份公開評估,沒有另給一套數字。
| 資訊類型 | 有沒有給 METR | 公開報告有沒有寫結果 |
|---|---|---|
| 內部模型的基準能力 | 有 | 有 |
| 內部能力的關鍵中間指標 | 有 | 沒有 |
| 演算法進度估計 | 有 | 沒有 |
| AI 貢獻了多少的證據 | 有 | 部分 |
| 關鍵研發投入的測量 | 大部分 | 沒有 |
| 瓶頸與預測的細節 | 部分 | 沒有 |
| 員工訪談 | 有 | 部分 |
合約原本還包括核對算力怎麼分給能力與安全。Anthropic 中途把這一部分拿掉,改成只看研發加速。METR 寫,拿掉的時候他們還沒對算力用法做出實質結論。Anthropic 的說法是先把這次合作聚焦在風險評估,算力分配以後再談。METR 沒有向 Anthropic 收費。對方提供了免費 token,主要用來做資料分析與圖表。
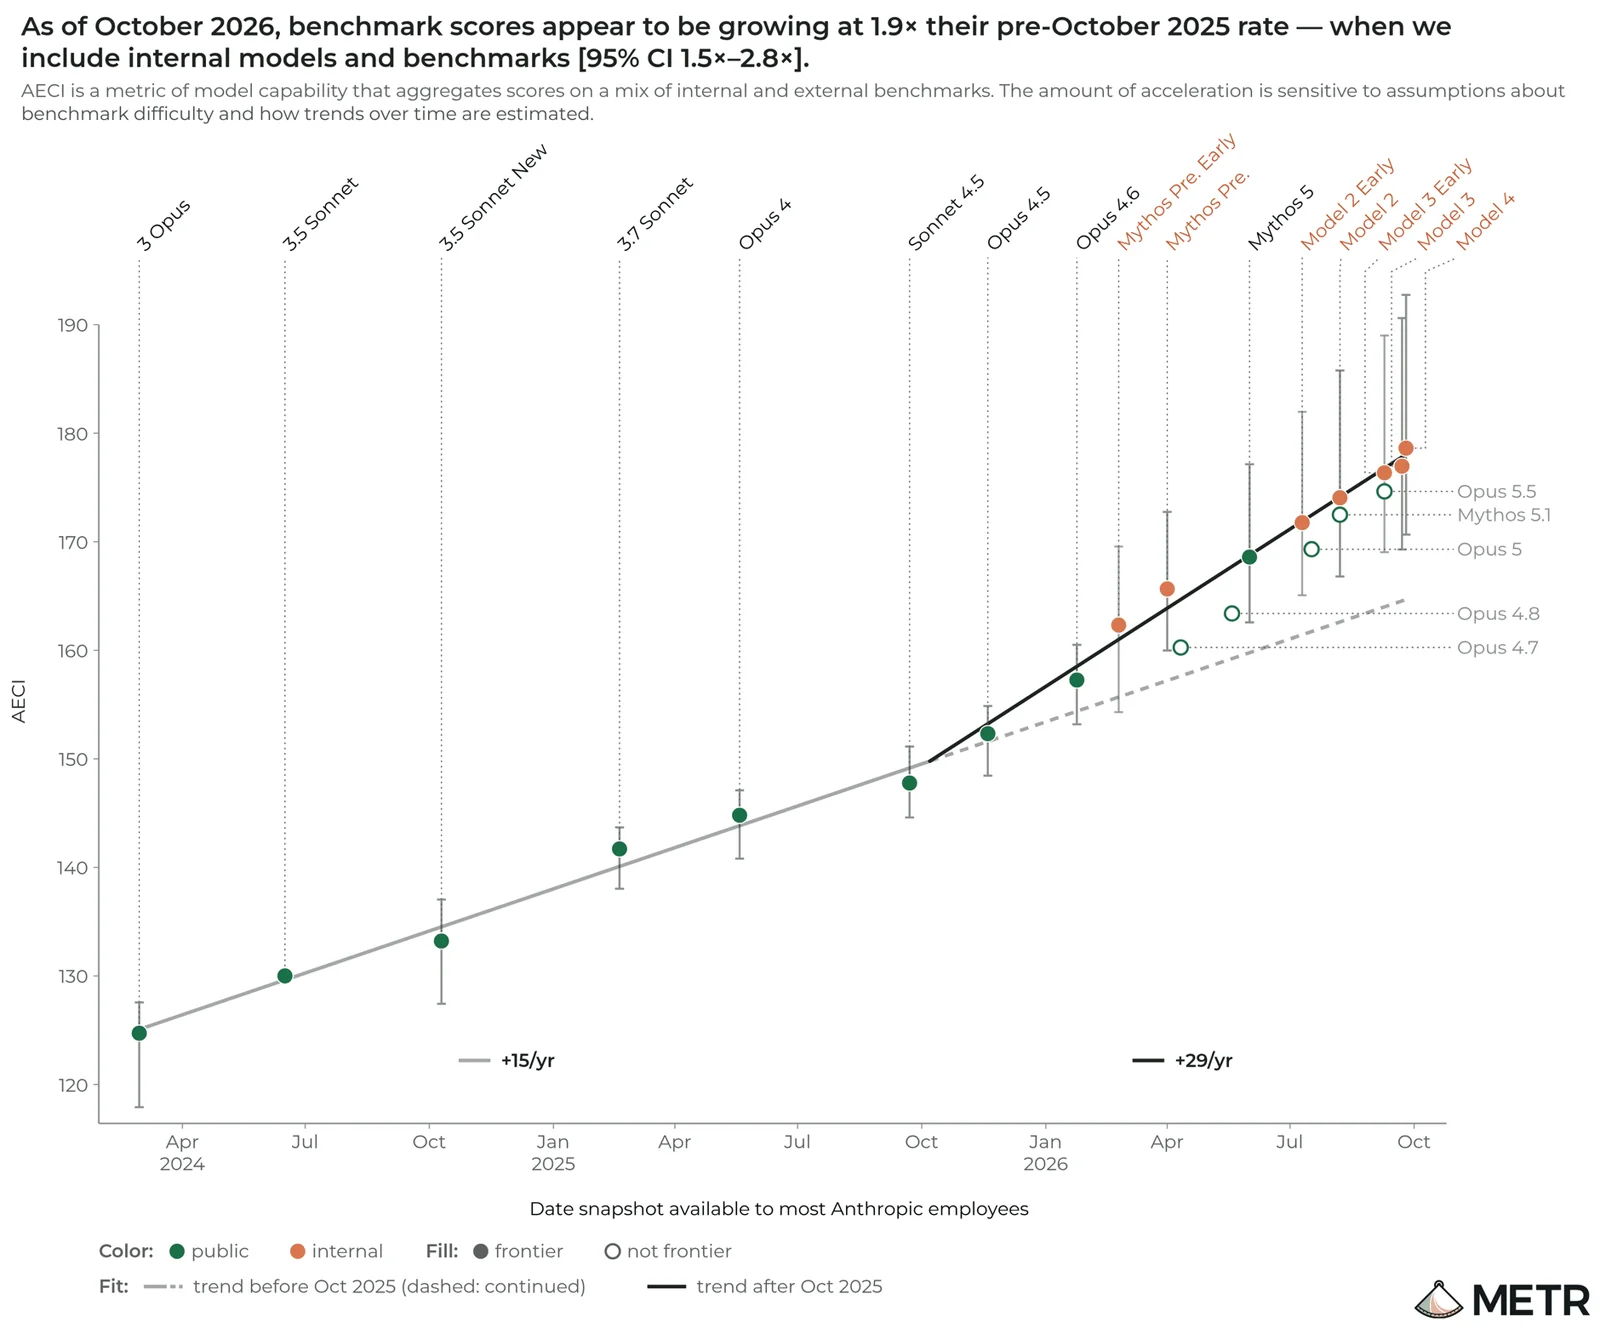
下面這張是他們仍然公開的 AECI 圖。AECI 是 Anthropic 版的 Epoch Capabilities Index。日期是該快照開放給大多數 Anthropic 員工的日子,不是對外發布日。圖上寫,2025 年 10 月之前每年約加 15 分,之後每年約加 29 分,估計加速 1.9 倍,95% 區間 1.5 至 2.8 倍,而且這是把內部模型與基準算進去之後的結果。橘色是內部模型,綠色是已公開模型。報告說,加速對基準難度與趨勢算法的假設很敏感。
主結果用的是 logistic 連結函數,因為那是 Epoch 與 Anthropic 的預設,不是因為它明顯比較貼資料。報告寫幾種連結函數的擬合差不多。換函數時,加速可以落在 1.1 倍至 2.9 倍。complementary log-log 是 1.1 倍,區間 0.8 至 1.5 倍。log-log 是 2.9 倍,區間 2.1 至 4.9 倍。主結果的 1.5 至 2.8 倍,是 logistic 那一列,不是把所有算法併成一個區間。
主觀結論另寫了一句:到 2026 年 10 月,Anthropic 在規格清楚的任務上推進能力的速度,大約是 2024 年 3 月至 2025 年 10 月的兩倍。他們說不確定性高,真的加速落在 1.3 倍或 3 倍也不會讓他們意外。規格沒那麼清楚的任務,還要再加一層不確定。報告把 1.9 倍說成:過去一年在基準上的進度,大致等於 2023 年 10 月至 2025 年 10 月(大約從 Claude 2.1 到 Sonnet 4.5)。
Haiku 5.5 系統卡寫的是 1.7 倍。METR 說自己較高,主要是因為多算了較新的未公開模型。圖上的內部代號是 METR 獲告知的稱呼,他們知道內部還有另一套名字。這不是那些模型的發布。
若把圖改成所有前沿開發者、不只 Anthropic,加速會較低。報告給了兩種讀法,沒有選定:一種是 Anthropic 在 2025 年還在前沿後面,所以 1.9 倍偏高,1.4 倍比較準;另一種是別家模型更針對基準最佳化,所以 1.4 倍偏低,1.9 倍比較接近。另外,Model 4 在它受測的 AECI 基準上都超過 50%,報告擔心之後更難用這套分數測量。
主因不是訓練算力
METR 寫,他們有足夠證據判斷:這次加速不是因為訓練算力的擴張速度變快。那份證據的細節被遮掉了。
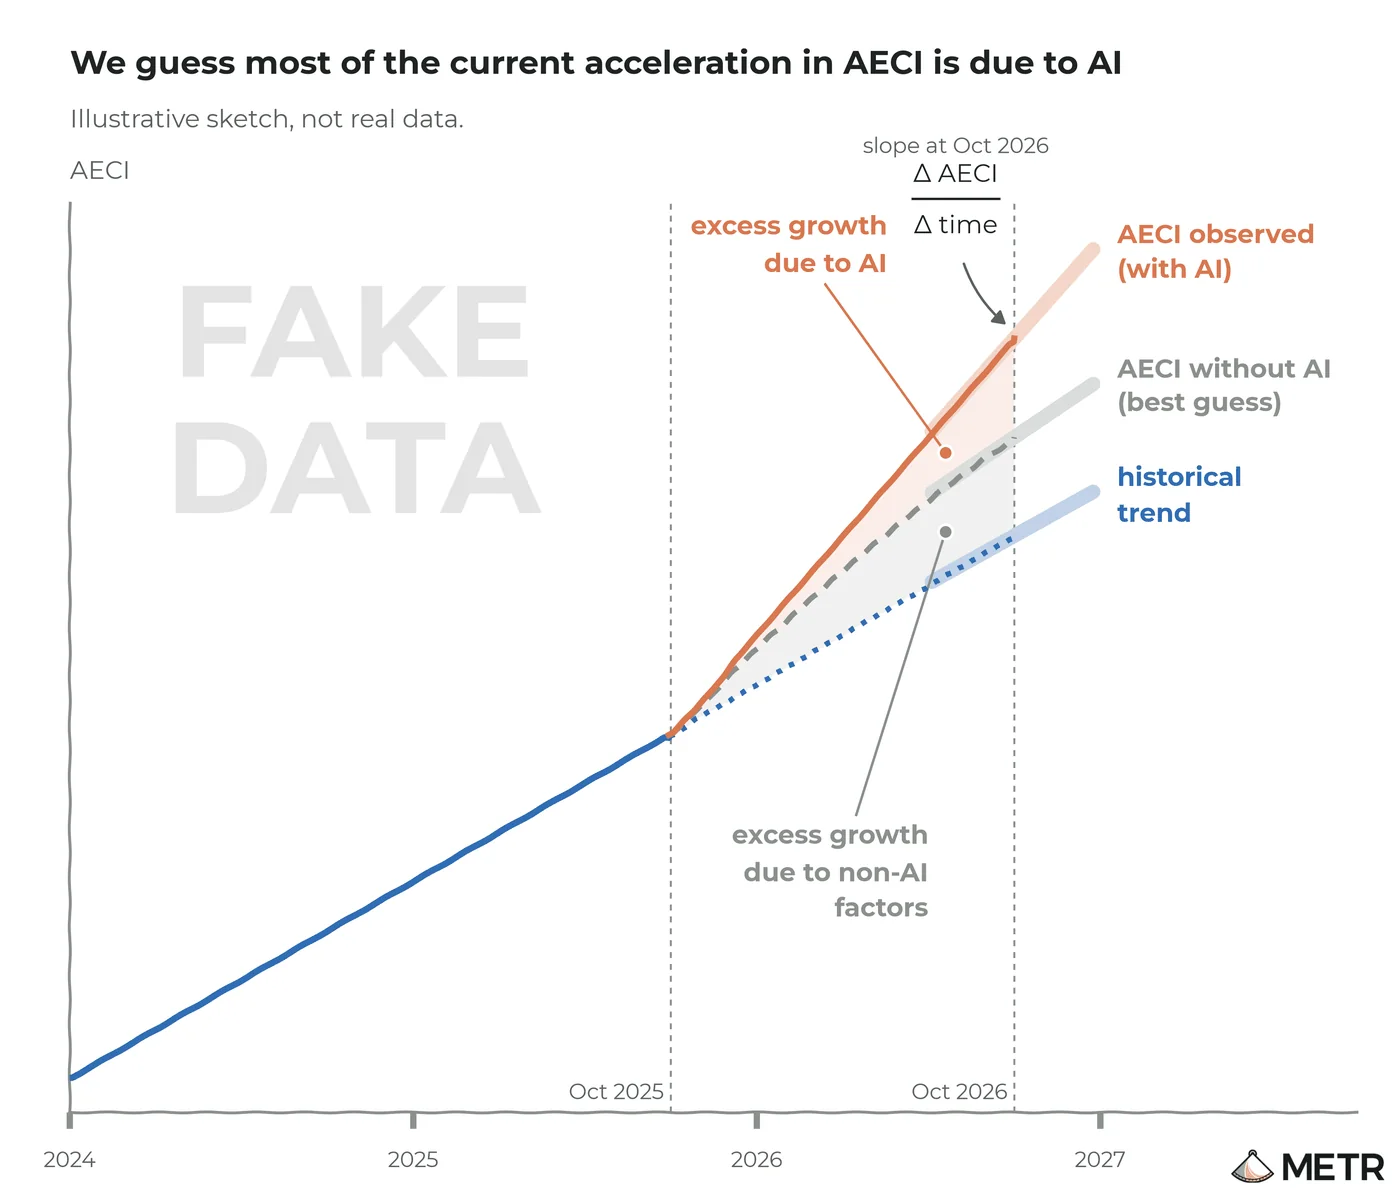
除此之外沒有共識。他們的主觀估計是兩句。2025 年末的加速,很可能受到非 AI 因素影響,其中許多細節被遮。到 2026 年 10 月當下的加速,他們猜測多數(或許約 80%)來自 AI,而且 AI 的比重隨時間變高。這句的不確定性很大。更細的、按訓練流程分段的估計被遮掉了。
報告沒有看到未來 12 個月會擋住演算法進度、訓練算力、實驗算力或資料的明顯瓶頸。但他們說自己的理解在評估期間改過好幾次,對這個判斷沒有信心,也可能漏掉重要瓶頸。因此他們認為,能力再往前,有明顯風險會加速得更快。
下圖標題是「我們猜測目前 AECI 加速的多數來自 AI」。圖上同時寫了 Illustrative sketch, not real data,並打上 FAKE DATA。它不是 80% 的刻度圖,不能拿來核對百分比。
十二倍是員工自填
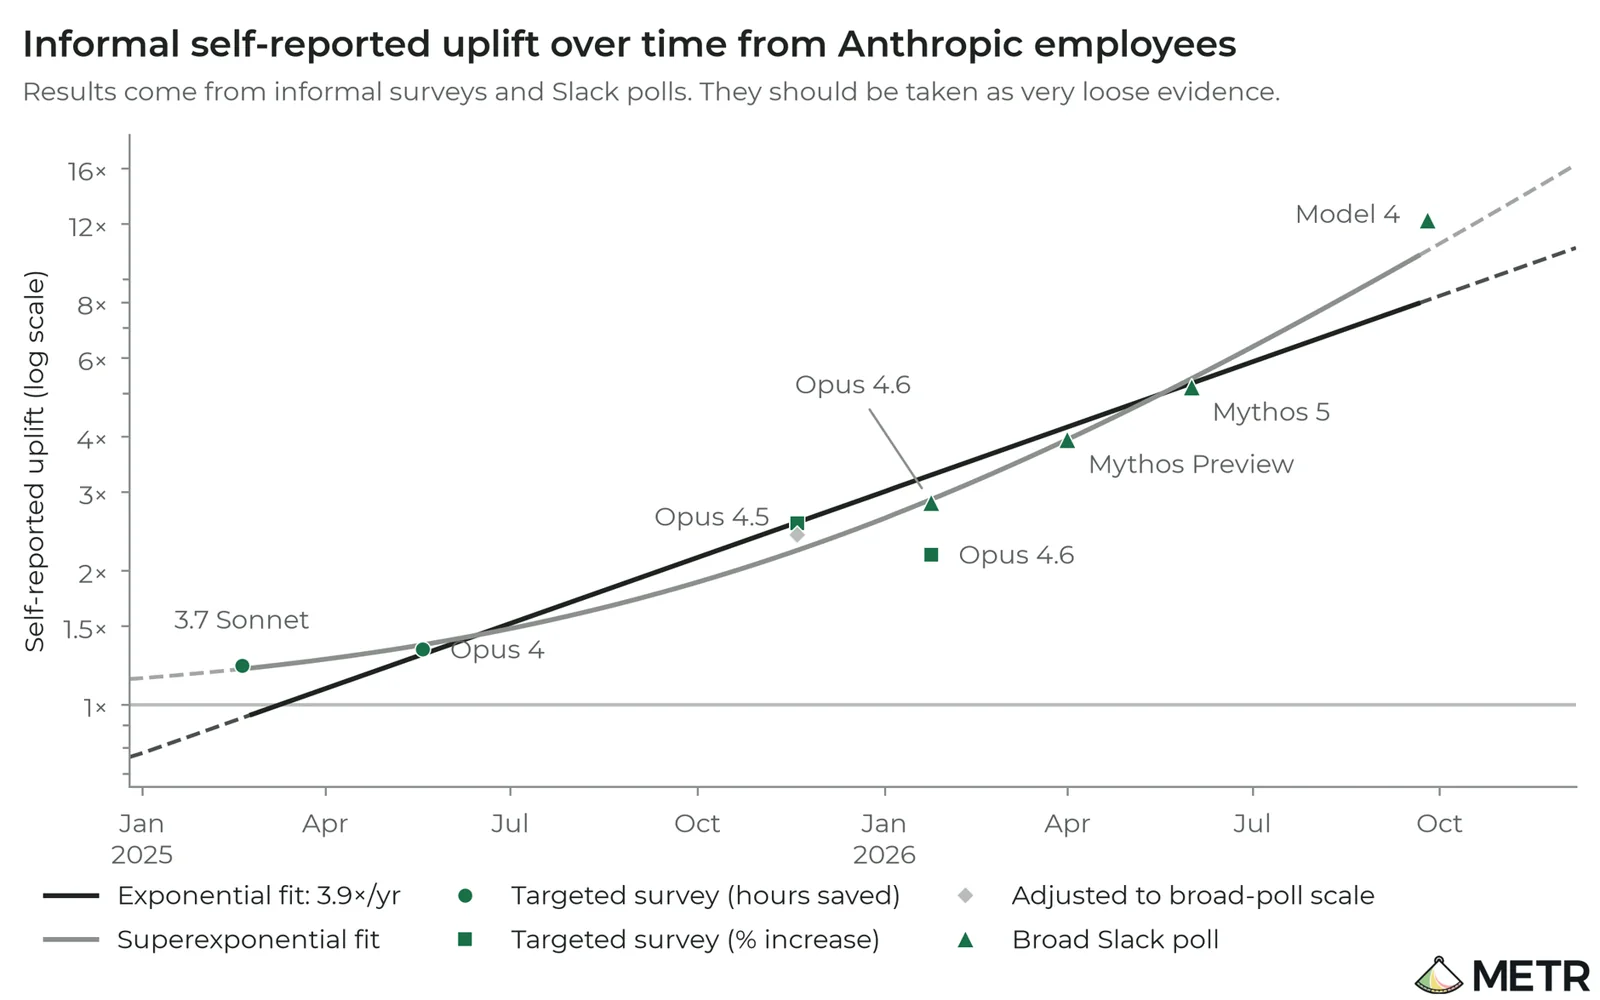
約 12 倍不是計時器量到的產能。METR 寫,最近的資料來自 Slack 投票:員工用表情符號,投自己覺得最新模型讓自己快了多少。他們認為這只是很鬆的證據。回覆的人可能不能代表全體,考慮時間也很短,而且已有一些證據顯示,自填的加速會高估真實產出。
圖的副標寫的是同一句:非正式調查與 Slack 投票,只能當成很鬆的證據。縱軸是對數。2026 年 10 月、標成 Model 4 的那個範圍較廣的 Slack 投票點,落在約 12 倍。正文寫,2026 年 10 月能力最強的那個內部模型,平均自填加速約 12 倍。圖上另有一條指數擬合,標成每年 3.9 倍,以及一條超指數擬合。那是在擬合這些自填點,不是客觀計時。個人覺得自己快了多少,也不等於整個能力進度的加速倍率。報告寫,要維持能力成長,通常還得克服報酬遞減,所以他們更在意自填數字的成長率有沒有變,而不是那一個絕對倍數。那段對照被遮掉了。
訪談是另一條線。METR 與 Anthropic 都訪談了研究人員。METR 用 Claude 把筆記分成是否支持「自己的工作區因 AI 而有 2 倍或以上的加速」。結果是:是 2、偏是 3、邊界或不清楚 4、偏否 0、否 2。他們的整體印象是範圍很寬,中心大約在 2 倍,並把這個分類讀成輕微偏向「有 2 倍或更多」。受訪者對問題的理解並不一致,有人說的是累積、有人說的是當下,有人說自己、有人說整個組織。
報告的理解是:AI 還不能對模型訓練最重要的部分,做出份量很重且完全自主的貢獻。研究人員描述了「有生命跡象」,表示這種貢獻可能很快出現,但各區塊成熟度差很多,細節被遮。加速目前主要仍是 AI 協助人做研發,不是訓練算力擴張,也不是已經換成全程自主。