1.6 兆參數的原生多模態智能體模型
美團於 2026 年 11 月 1 至 2 日發布 LongCat-2.5。官方部落格描述它是面向長程智能體任務的原生多模態模型:
- 總參數 1.6 兆,每個 token 約激活 480 億參數
- 在 LongCat-2.0 基礎上強化原生視覺理解與智能體編程
- 視覺訊號以多層離散 token 表示,與文字統一處理
- 官網 longcat.ai 可體驗,API 同步上線(本文不另寫定價;官方部落格未列價目表)
美團新聞稿另強調:訓練全程由國產算力完成。
官方表格裡的幾項成績
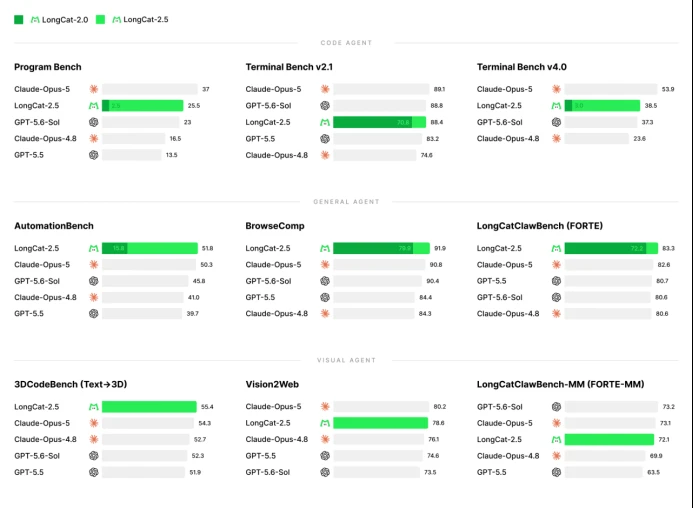
官方評測表把 LongCat-2.5 與 GPT-5.5、GPT-5.6-Sol、Claude-Opus-4.8、Claude-Opus-5 等並列。以下分數只引自官方表/部落格(預設 enable_thinking=on):
| 基準 | LongCat-2.5 | LongCat-2.0 |
|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 |
| Terminal Bench v4.0 | 38.5 | 3.0 |
| BrowseComp | 91.9 | 79.9 |
| HLE w/ tools | 63.1 | 37.5 |
| Vision2Web | 78.6 | 無 |
| 3DCodeBench Text→3D | 55.4 | 無 |
美團新聞稿的說法是:多項主流基準成績落在 Claude-Opus-4.8 與 Claude-Opus-5 之間,部分評測超過 Claude-Opus-5。其他模型標有 * 的分數來自公開報告或排行榜,官方已註明。
國產卡上的長上下文與 W4A4
官方技術重點包括:
- 中訓練與 SFT 做長序列訓練;美團新聞稿寫最長達 1M token
- 對齊超節點拓樸的並行策略;長序列 SFT 單卡吞吐較 DDP 基線提升 86%(官方數字)
- 推理採 W4A4(權重與激活皆 4 bit)。線上壓測相對 W8A8 INT8:prefill 吞吐 +43.3%、decode +42.77%,TTFT -15.91%、TPOT -19.72%
訓練上也放大長程 agentic RL:合成任務、非同步 rollout、混合不同 harness,並把真實失敗軌跡轉成可驗證訓練題。
用在美團主業:商家 AI 幫手
美團新聞稿引述 CEO 王興:模型與 AI 產品要支援主業,而不是當「Token 工廠」。圍繞這個目標,LongCat-2.5 強化商業分析與軟體開發;美團並推出 AI 經營工作台「妙手」,已服務古茗、徐升記、益禾堂等連鎖品牌。
對開發者來說,可先到 longcat.ai 試用,再視需求接 API。定價請以官方 API 文件為準,本文不另行摘錄。