約 2B 的多模態小模型家族
2026 年 10 月 27 日,Liquid AI 宣布 LFM3(Liquid Foundation Models 新一代)。首發涵蓋約 2B 參數級、天生多模態方向:文字、視覺、音訊、omni 與決策等變體,掛在同一條新共享骨幹上。官網強調比 LFM2 更有表現力,同時維持效率,適合作「專門化智慧」的起點——可本機微調、可上裝置、可針對窄任務變專家。
Base 與 post-train 權重開源,並上 Hugging Face、Playground 與 Liquid API。
架構與 22T 預訓練
【事實|Liquid】 LFM3-1.7B-Base 預訓練約 22T tokens;相對 LFM2 增加科學論文、repo 級程式、知識與數學等。最後約 3.5T 為 mid-training(較高品質、較多 agentic/工具軌跡),並把文字模型上下文拉到 256K。
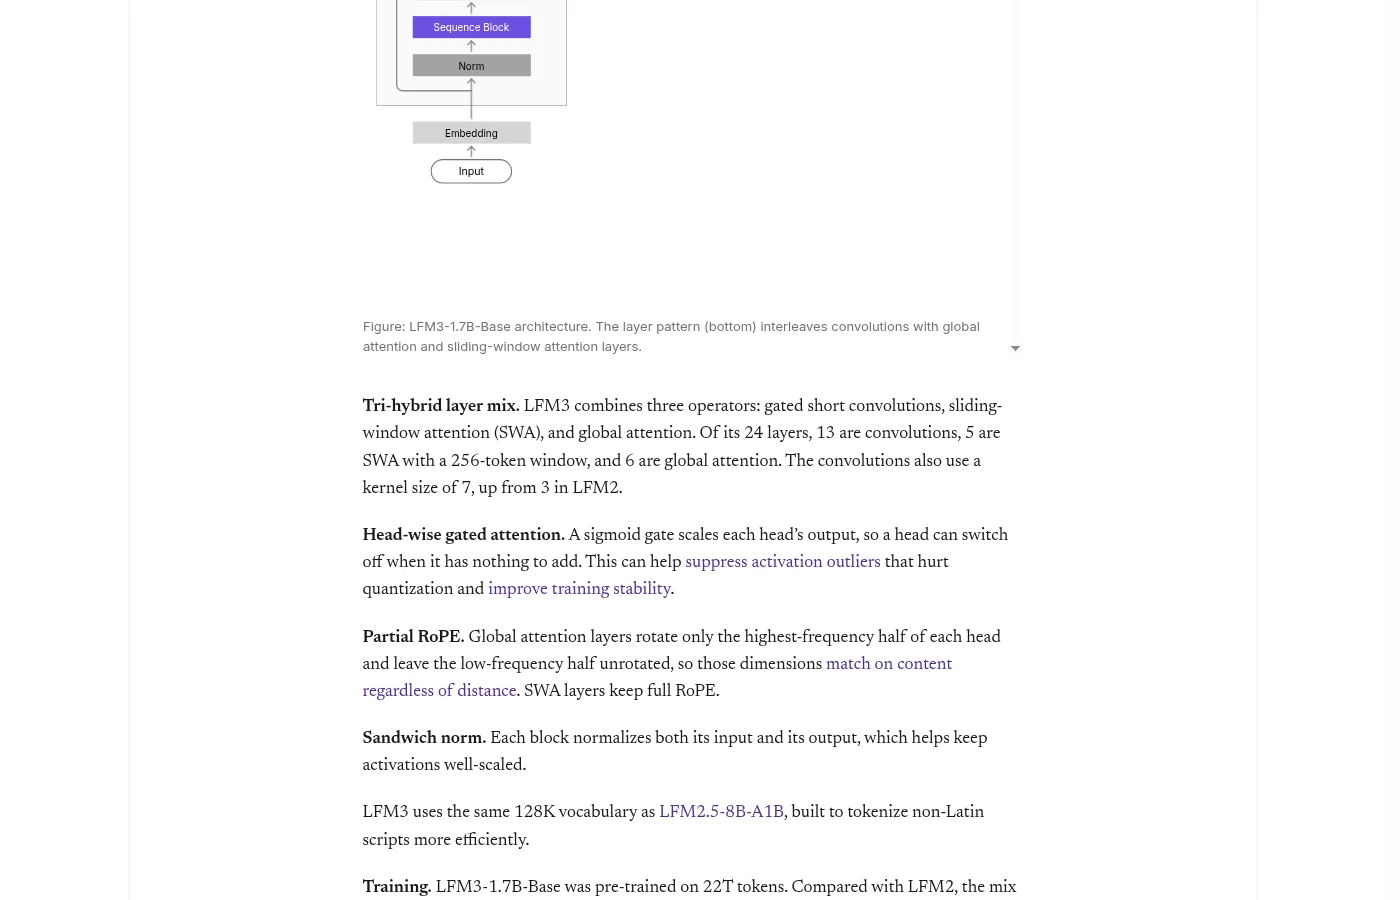
新 tri-hybrid:24 層中 13 層 gated short convolution、5 層 sliding-window attention(256 token 窗)、6 層 global attention;另有 head-wise gated attention、partial RoPE、sandwich norm 等(細節見原文)。硬體迴路從少數裝置擴到 14 組設備/後端組合。官網稱 LFM3-1.7B 以更少參數勝過自家 LFM2.5-2.6B(約少 35% 參數)。
家族裡有哪些變體
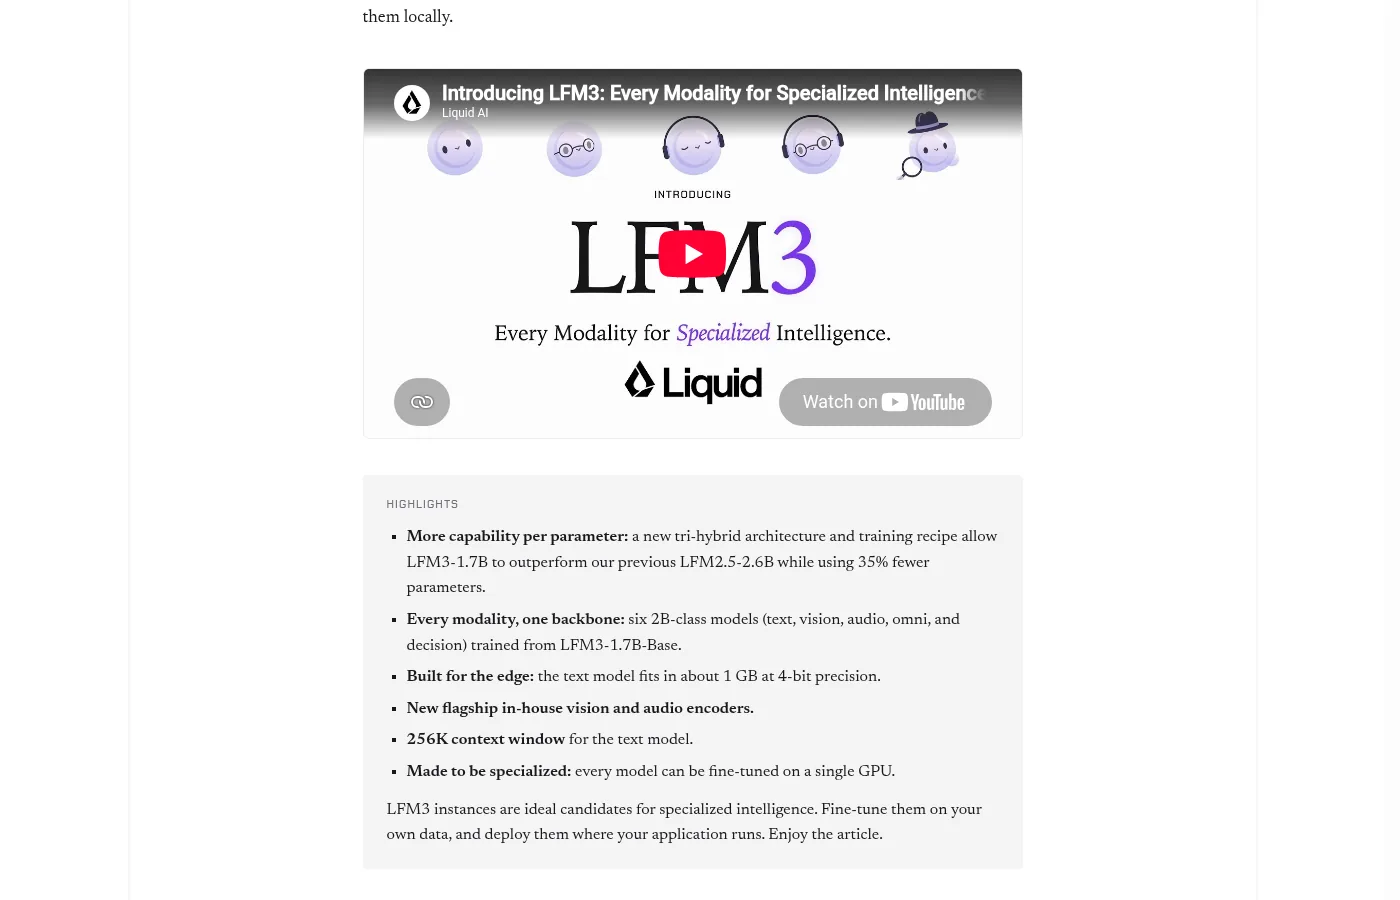
約六個 2B 級實例自 LFM3-1.7B-Base 分出,例如:
- LFM3-1.7B(文字,256K;agent/工具向 post-train)
- LFM3-VL-2B(視覺+影片理解等)
- LFM3-Audio-2B(語音進出、多語等)
- LFM3-Omni-2B(視+聽+說)
- d1-2B/d1-Omni-2B(決策:單次前向回答多題,含框選、抽欄位等)
文字模型約 4-bit 可壓到約 1 GB;官網強調單 GPU 即可微調。邊緣吞吐、與 Qwen/Gemma 等比較表皆在原文——引用請回 Liquid 頁核對,勿混用二手彙整。
專門化例子與怎麼開始
官網示範:把 LFM3-VL 短微調做風機葉片缺陷分類;以及把 VL 接到機器人規劃/導航/操作的研究延伸。這些是 Liquid 展示的能力敘事,不是保證你資料集上同分數。
下載與文件見 Liquid 原文 與 Hugging Face;可用 llama.cpp、MLX、vLLM、SGLang 等路徑。選型時先對齊模態(只要文字/要看圖/要語音),再估裝置記憶體與微調資料。
讀數字時請回原文
LFM3 的賣點是「小而可專門化的多模態骨幹」,不是再一個雲端巨型聊天模型。任何 LiveClaw、SWE-bench、視覺平均分等表格,一律以 Liquid 部落格與各 model card 為準;本文不轉貼完整基準表以免過時。