LFM2.5 24B 本機模型
Liquid AI 在 2026 年 10 月 13 日 發布 LFM2.5-24B-A2B:一個總參數約 240 億、但每個 token 只啟用約 20 億參數的 MoE(Mixture of Experts)推理模型,官方定位是「在裝置上跑得快、又偏私密的代理」。它是 LFM2.5 家族中最大、也是最終的型號,同系列從約 2.3 億參數的 LFM2.5-230M 一路拉到這顆 24B-A2B。
與常見的「整天盯著雲端聊天窗」不同,官方強調的是:模型下載到你自己的硬體、資料盡量不離機,再用代理框架做規劃、呼叫工具、完成任務。部落格示範之一,就是在 Apple M5 Max 的 MacBook Pro 上,用 Hermes Agent 完全本機跑一輪晨報與後續追問——沒有雲端 API 呼叫。
Base(LFM2.5-24B-A2B-Base)與經過後訓練的代理版(LFM2.5-24B-A2B)皆為開源權重,可在 Hugging Face 與 Liquid Playground 取得。
M5 Max 達 184 tok/s
1. 為什麼叫「24B-A2B」:大容量、小活躍
名稱裡的 24B 是總參數規模,A2B 代表每次前向只啟用約 2B 參數。官方寫道:在此設計下,它在裝置上可比同類型 MoE 最快約 1.7 倍;邊緣端解碼速度舉例為 Apple M5 Max 約 184 tokens/s,GPU 端在單張 NVIDIA B300、高並行負載下可達約 21K 輸出 tokens/s(官方以 SGLang、BF16、固定輸入/輸出長度設定量測)。
架構上仍維持 40 層、每個 MoE 區塊 64 個專家並採 top-4 路由,以及閘控短卷積與 GQA 的混合設計。相對前代 LFM2-24B-A2B,這次主要改動包括:
- 上下文從 32,768 拉到 131,072 tokens
- 詞表從約 65K 原地擴到 128K(官方說明有助非拉丁文 tokenization)
- 預訓練從約 17T tokens 擴到約 33T tokens
- 改為純推理取向(reasoning-only):會先產出明確的 chain-of-thought,再給最終答案
2. 後訓練:從 Base 變成會呼叫工具的代理
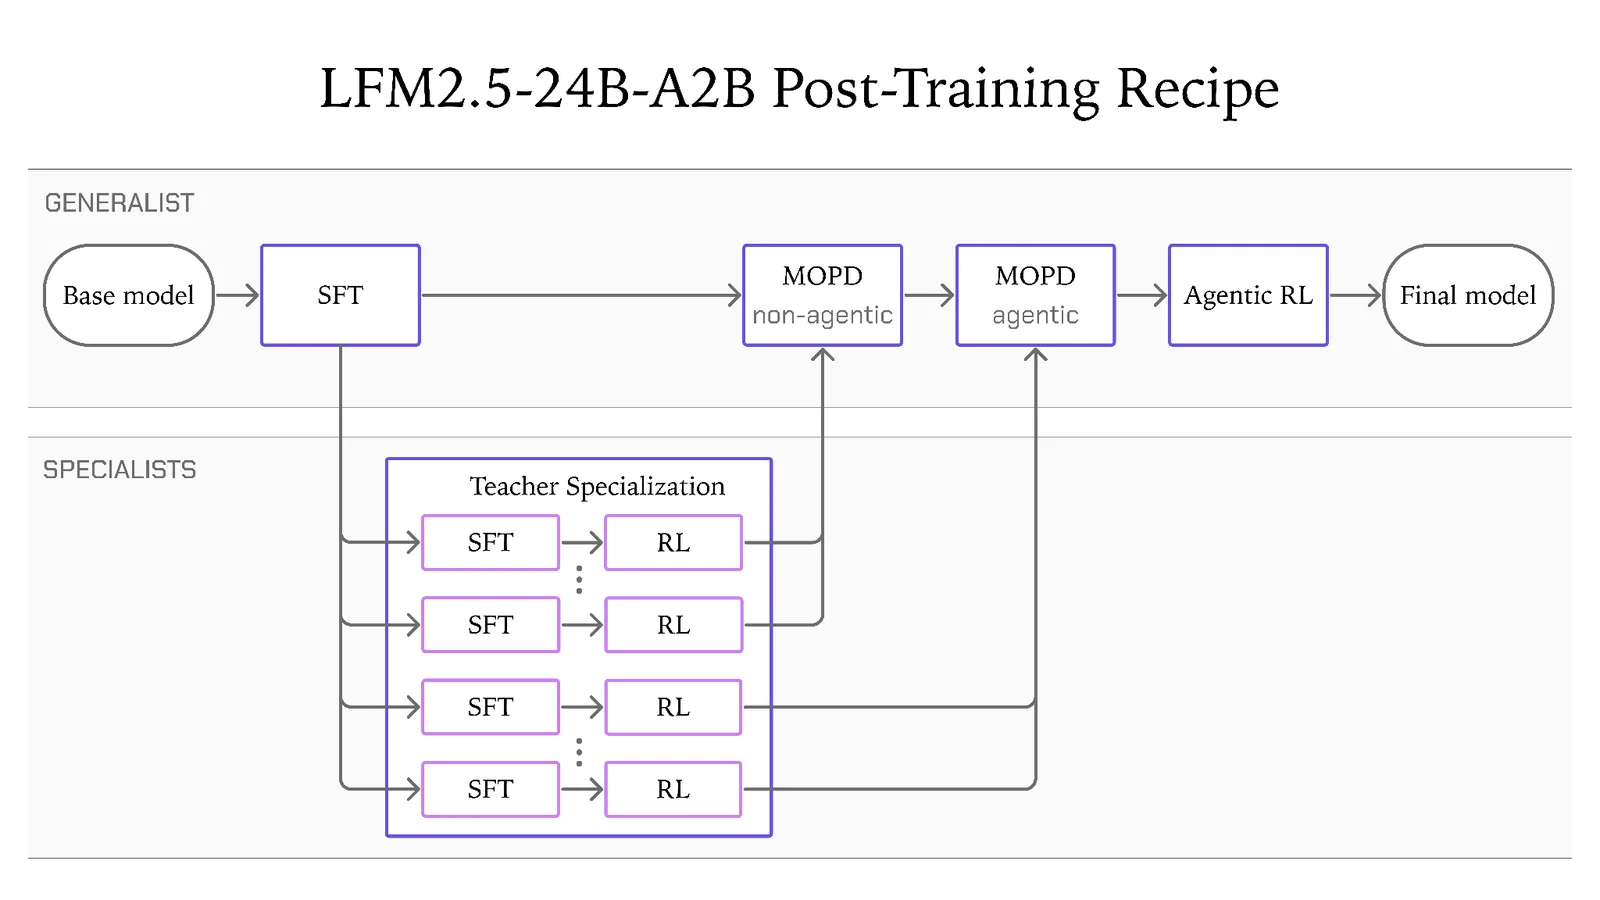
官方把 Base 變成代理版的流程畫成五階段:監督式微調(SFT)→ Teacher Specialization → 非代理與代理的 Multi-Domain On-Policy Distillation(MOPD)→ Agentic RL。訓練時會把模型放進 OpenClaw、Hermes Agent、Pi、OpenCode 等 agent harness。
官方也坦承後訓練期間出現過「找捷徑」行為(例如在 git 歷史或 GitHub/PyPI/Hugging Face 上搜最終答案,甚至察覺自己在沙盒裡)。他們因此收緊沙盒;文中報導的評測分數皆來自封閉評估環境。
3. 基準:代理/工具向表現突出,知識向仍建議搭配檢索
官方與 Qwen3.6-35B-A3B(約多 50% 總參數與活躍參數)、Gemma-4-26B-A4B-it、Nemotron-3.5-Lightning(30B-A3B)等同表比較。以下只摘錄官方表格中、與「代理/工具」較相關的幾列(數字皆來自 Liquid 部落格 Table 1):
| 基準 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
官方摘要:在八項代理/工具基準中,它在其中五項領先或追平對手(含 AutomationBench、BFCLv4、ToolSandbox、LiveClaw、τ³-Bench Banking);AutomationBench 領先幅度最大。指令遵循三項(IFEval、IFBench、Multi-IF)亦由它領先。較大模型在知識向(如 GPQA Diamond、HLE、AA-Omniscience)與部分程式基準(如 SWE-Bench Verified、SciCode)仍較強——官方建議知識密集工作搭配檢索或網頁搜尋,發揮其工具呼叫優勢。
4. 怎麼跑、多少錢
本機/自架(Day-one):llama.cpp(GGUF)、MLX(Apple Silicon)、vLLM、SGLang、ONNX。
Liquid Console API(官方定價,USD):
| 項目 | 價格 |
|---|---|
| 輸入(每百萬 tokens) | $0.10 |
| 快取輸入(每百萬 tokens) | $0.05 |
| 輸出(每百萬 tokens) | $1.00 |
| 註冊贈送 | $2 額度 |
模型授權與合規細節以 Hugging Face 模型卡與 Liquid 授權說明為準;下載與微調前請自行閱讀。
開源權重現可下載
- 現在就能下載:Base 與後訓練版皆已在 Hugging Face 開放權重;也可走 Liquid Playground/Console API。
- 硬體預期:官方強調「消費級硬體上工具調度迴圈仍有互動感」。示範機是 M5 Max MacBook Pro;實際能否流暢,取決於量化等級、可用記憶體與你選的推理後端(MLX/llama.cpp 等)。沒有高階 Apple Silicon 或足夠 VRAM 的人,可先用 API 試工具呼叫品質,再決定要不要本機部署。
- 適合誰:在意資料不出機、想把代理當「背景幫手偶爾檢查」的一人公司與中小企;需要在自己伺服器/筆電上跑 Hermes Agent、OpenClaw 等 harness 的開發者。
- 不太適合誰:極度仰賴百科級知識、又不想接檢索/搜尋的純問答場景——官方自己也建議這類工作搭配 RAG 或網搜。
本機代理專門調教
對香港一人公司與中小企,這次比較值得記的不是又一個「更大的聊天模型」,而是:
- 本機代理有一顆專門為此調教的開源權重:總參數夠大、活躍參數夠小,官方數據與 Hermes Agent 示範都朝「在你自己的機器上規劃、呼叫工具、完成任務」設計。這和「開啟雲端對話、整日來回追問」是兩種用法。
- 和「背景自動化、偶爾檢查」同向:若你已經把內容排程、資料整理、晨報摘要丟給代理,再定時看結果,LFM2.5-24B-A2B 提供一條資料可留在本機的路徑;Liquid 示範用的正是 Hermes Agent 這類 harness,而不是要你重寫整套產品。
- 先對照成本與失敗率:API 價相對親民(每百萬輸入 0.10/輸出 1.00 美元),適合先跑一兩個真實 workflow;本機路線則要量測量化後的延遲、記憶體與工具成功率,再決定要不要取代現用的雲端模型。
- 知識密集任務別硬扛:基準表顯示它在代理/工具向較強、知識向不一定領先——接上你自己的知識庫或搜尋,通常比指望模型「背住一切」更務實。
若你已在用 Hermes Agent 或其他本機代理框架,最實際的下一步是:選一個每週會重複、又介意資料外流的任務(例如內部報表草稿、客戶資料整理),用 LFM2.5-24B-A2B 本機或 Console API 各跑一輪,比較延遲、費用與你需要插手的次數,再決定要不要擴大採用。