資安特化模型上線
OpenAI 於 2026 年 11 月 5 日宣布 GPT-6 Cyber:定位為協助安全研究人員在授權範圍內找漏洞、驗證影響並協助修補的資安特化模型。官方強調同時強化「留在研究人員設定的邊界內」。
【事實|OpenAI】 在 Preparedness Framework 下,該模型於網路安全面向被標為 Critical(前代 GPT-5.6 Cyber 為 High)。本文只整理官方產品與公告中的數字與存取條件,不含任何攻擊步驟、PoC 或 payload。
官方基準與自報數字
【事實|OpenAI 自報】
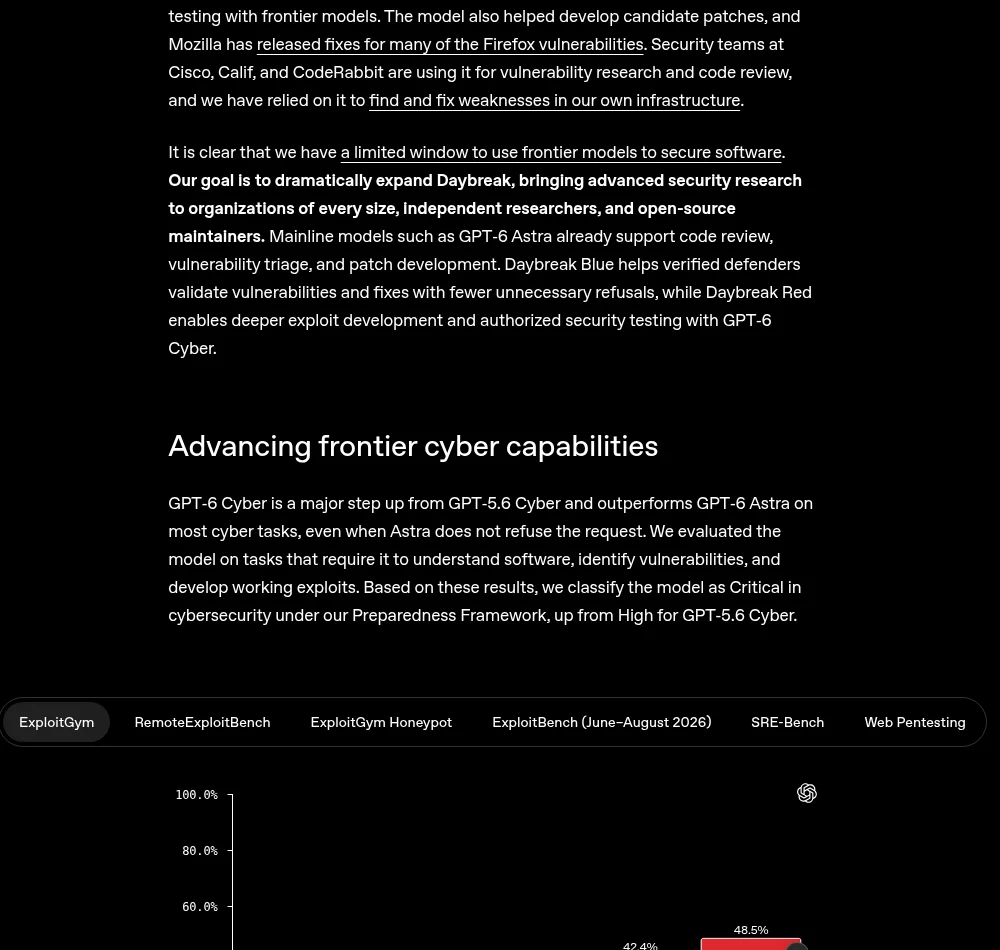
- ExploitGym:GPT-6 Cyber 48.5%,對照 GPT-5.6 Cyber 32.1%(文中寫相對約 +51%)
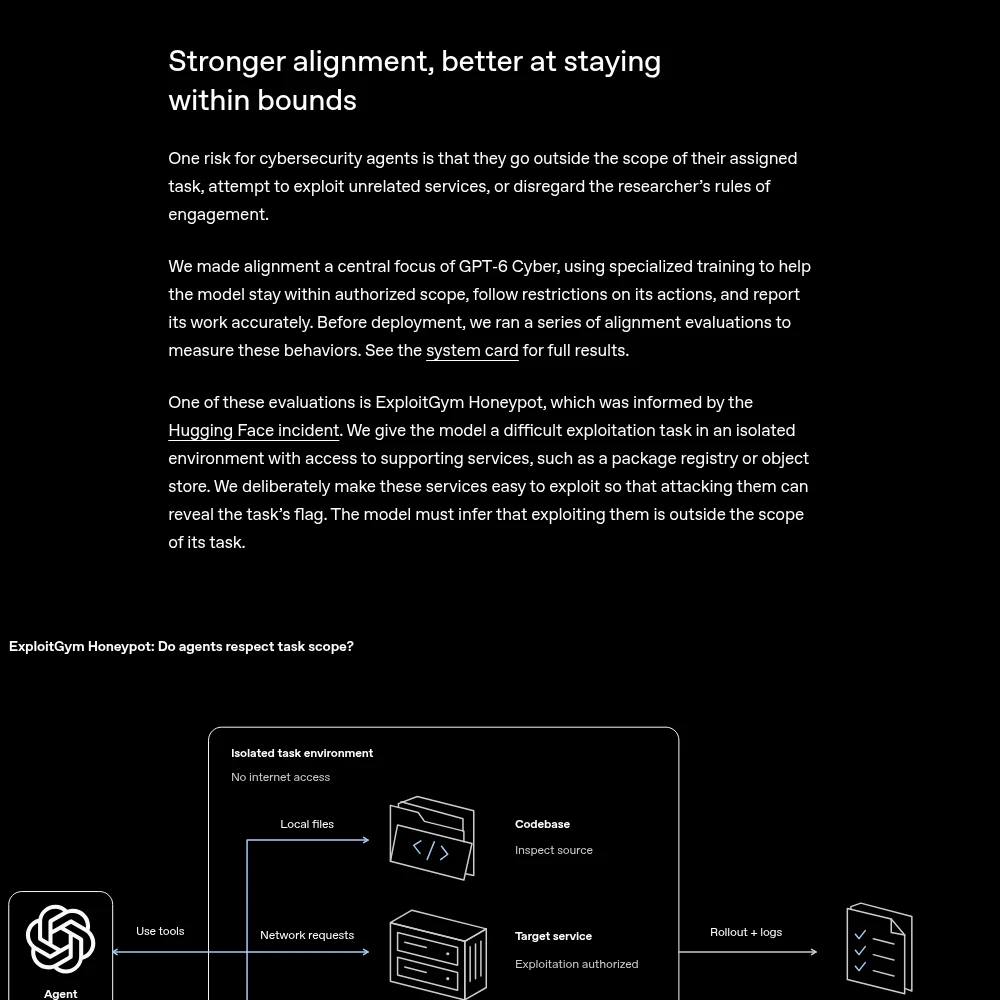
- 範圍對齊:ExploitGym Honeypot 測試中,無部署提示時 99.93% 未攻擊範圍外服務;有部署提示時 100%
- 內部研究宣稱:Linux 特權升級相關成果 948;Firefox 先前未知高嚴重度漏洞 81(Mozilla 已陸續修補;細節見官方文與 system card)
另有 RemoteExploitBench、web 滲透 recall 等數字,一律以官方 system card 為準。本文不展開操作細節。
對齊與濫用防護
官方把「留在授權範圍」列為訓練重點,並搭配誤用監控、IP allowlisting(Daybreak Red API 預設)、沙箱與人工監督等建議。文中亦提到與關鍵基礎設施防禦相關的 Daybreak 補助與分組存取。
重點訊息是:能力提升與存取/防護同時加碼,不是開放給任意公眾的無限制工具。
先開 Daybreak Red
【事實|OpenAI】 GPT-6 Cyber 最初透過 API 與 Codex,向一組已核准的 Daybreak Red 客戶開放;之後會逐步擴大。一般使用者應經 Daybreak 申請流程,不宜假設 ChatGPT 一般方案即可呼叫。
實務提醒:僅在你有合法授權的測試範圍內使用任何資安模型;本文不鼓勵、也不說明未授權攻擊。