資安與長時程工程的下一站
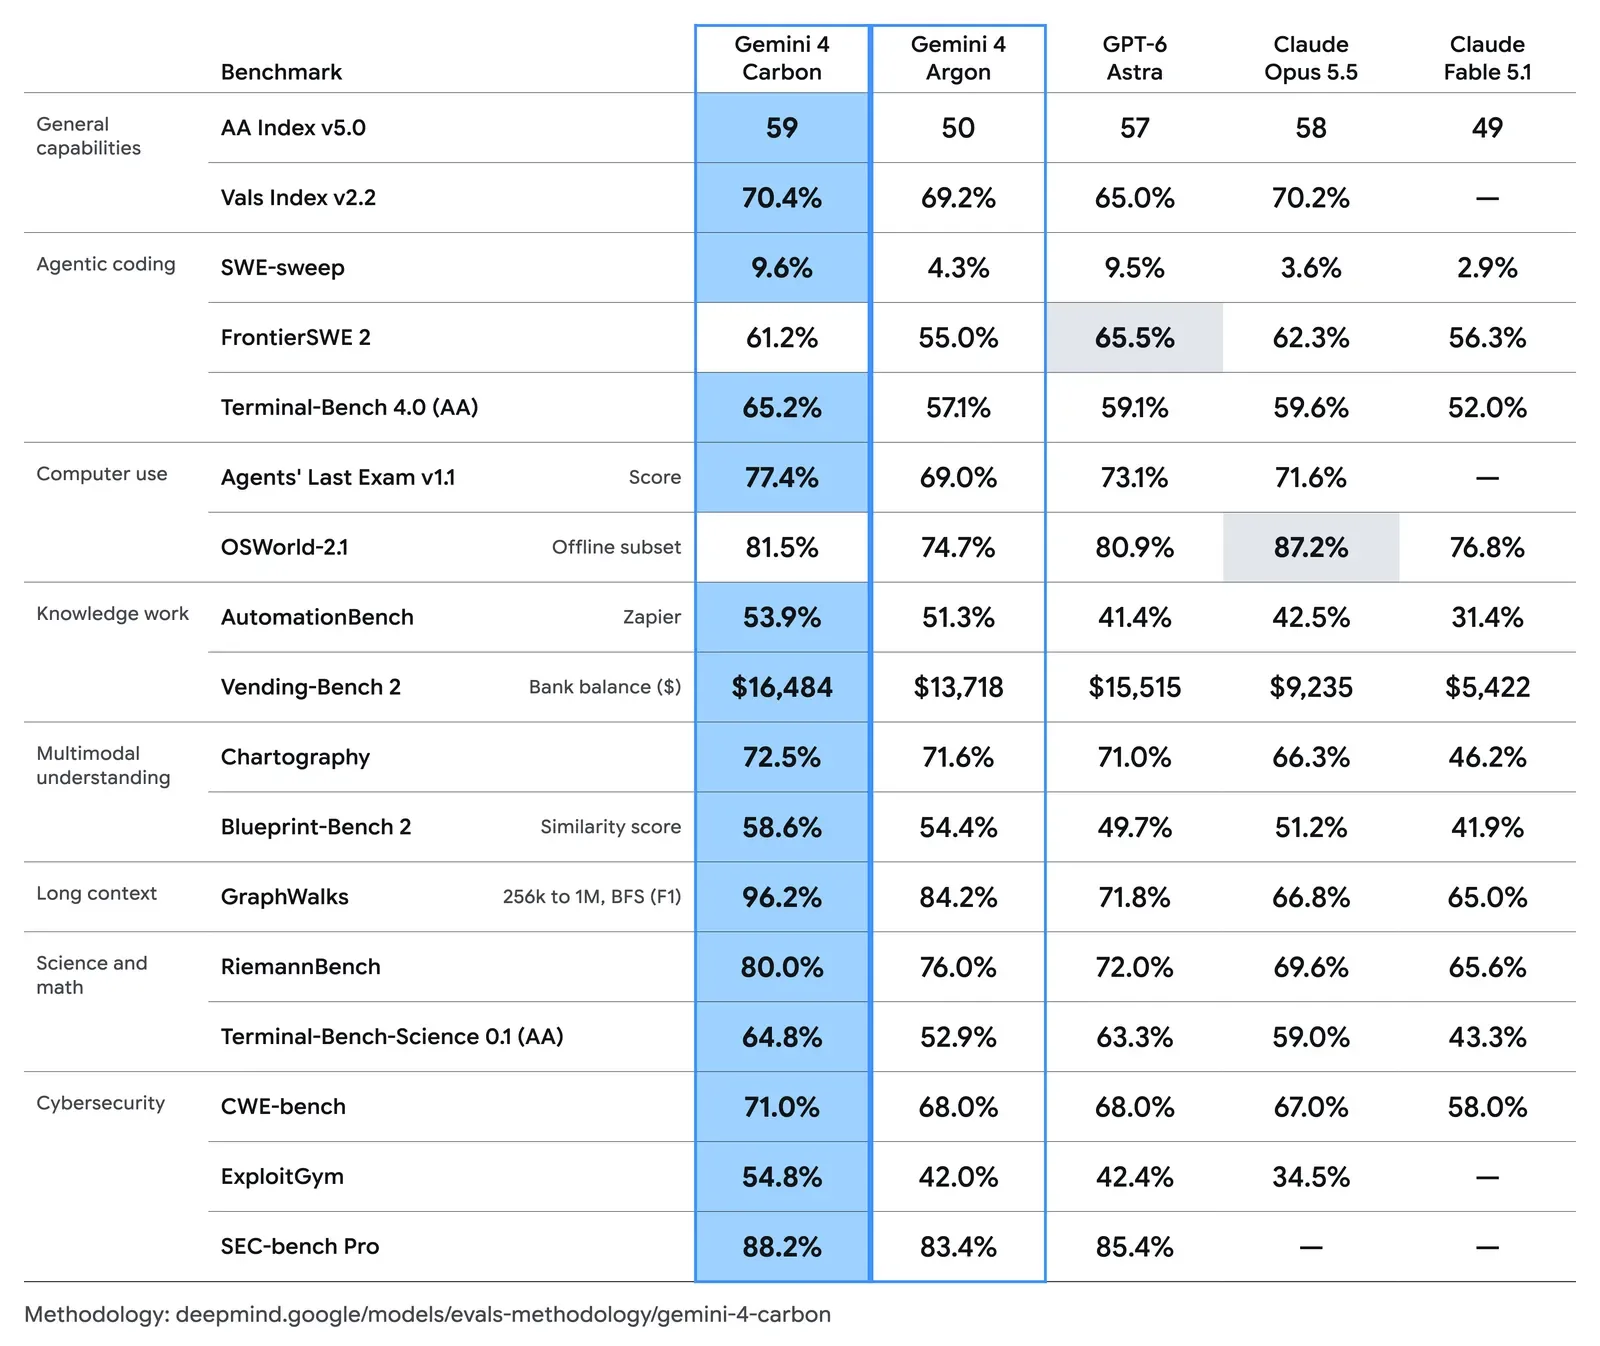
2026 年 10 月 28 日,Google 宣布前沿模型 Gemini 4 Carbon:官方定位為目前最強一版,重點放在資安(cybersecurity)與長時程(long horizon)能力。文中寫 Carbon 在更新後的 Artificial Analysis Intelligence Index v5.0 排名第 1(59 分),並在程式與代理任務有明顯提升。
Carbon 建立在約兩週前推出的 Gemini 4 Argon 之上。Google 表示會採取較審慎的釋出:已參與美國政府預發布測試自願流程;本週起先給一部分 cyber defenders,再透過 Fairwind Program 逐步擴大給其他信任夥伴,收集回饋並調整防護後,才盡快開放給開發者、企業與一般消費者。
引言價與 Argon 同檔
官網寫 Carbon 的引言價與 Argon 相同:每百萬輸入 token 2 美元、每百萬輸出 token 10 美元;快取輸入再享輸入價 95% off。引言期結束後改為每百萬輸入 4 美元、輸出 20 美元(頁面腳註說明)。
內部場景:團隊觀察到 Carbon 可連續跑數天,在大型程式庫與低階系統上做根因分析與修補這類多步驟工程任務。WebDev Arena 官方寫 Carbon 提升約 +89 Elo,排名第 4(1768)。
資安三關:找洞、驗證、修補
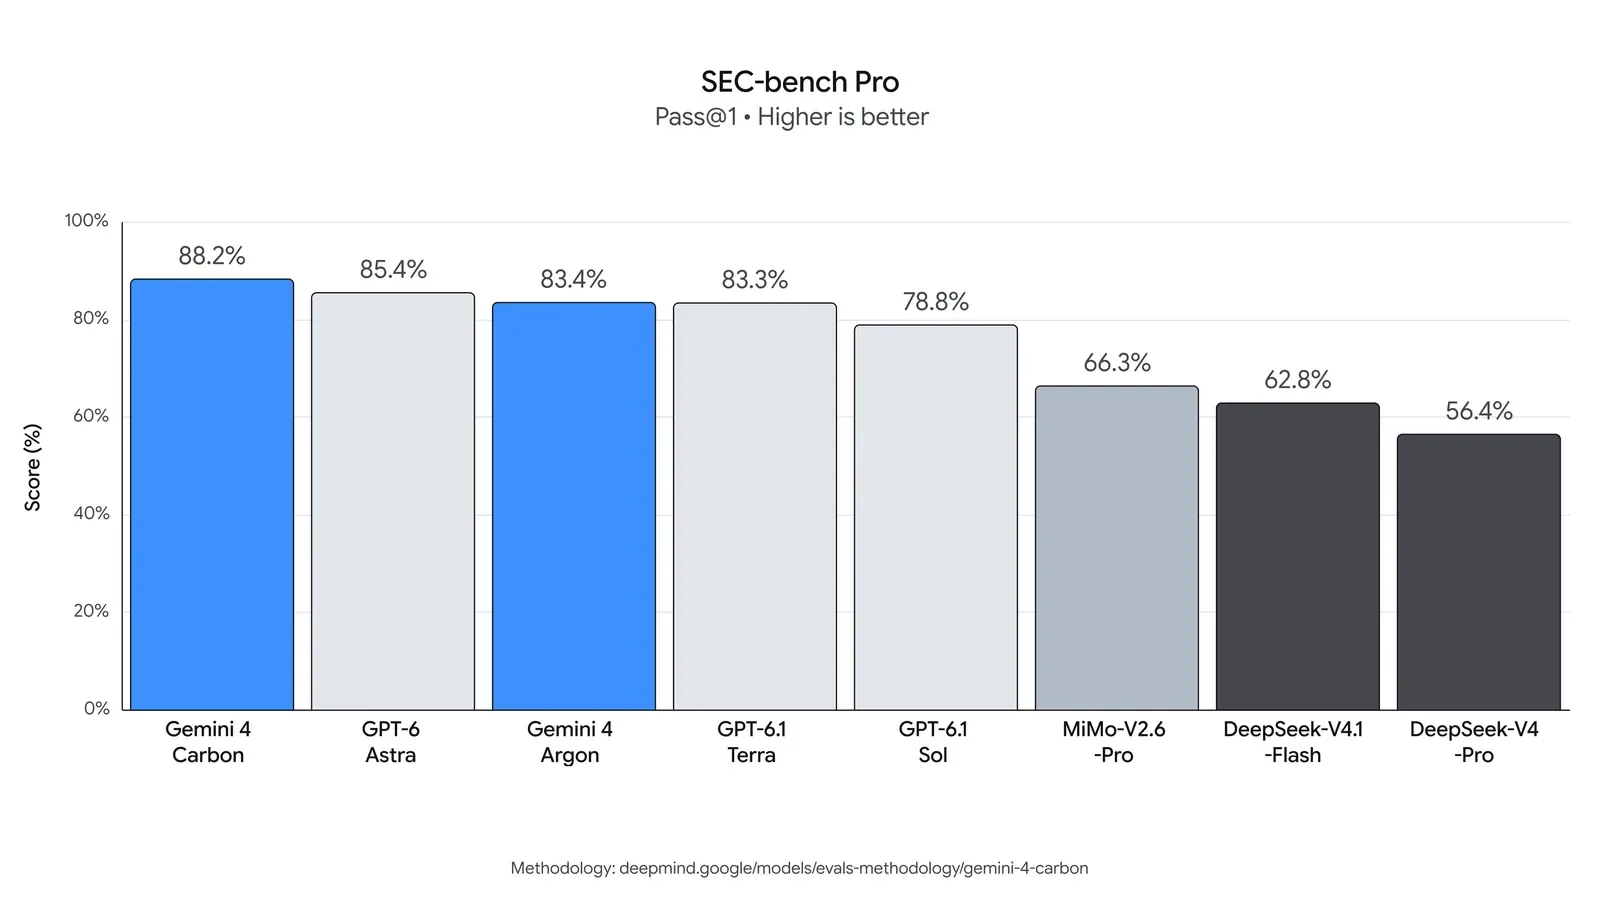
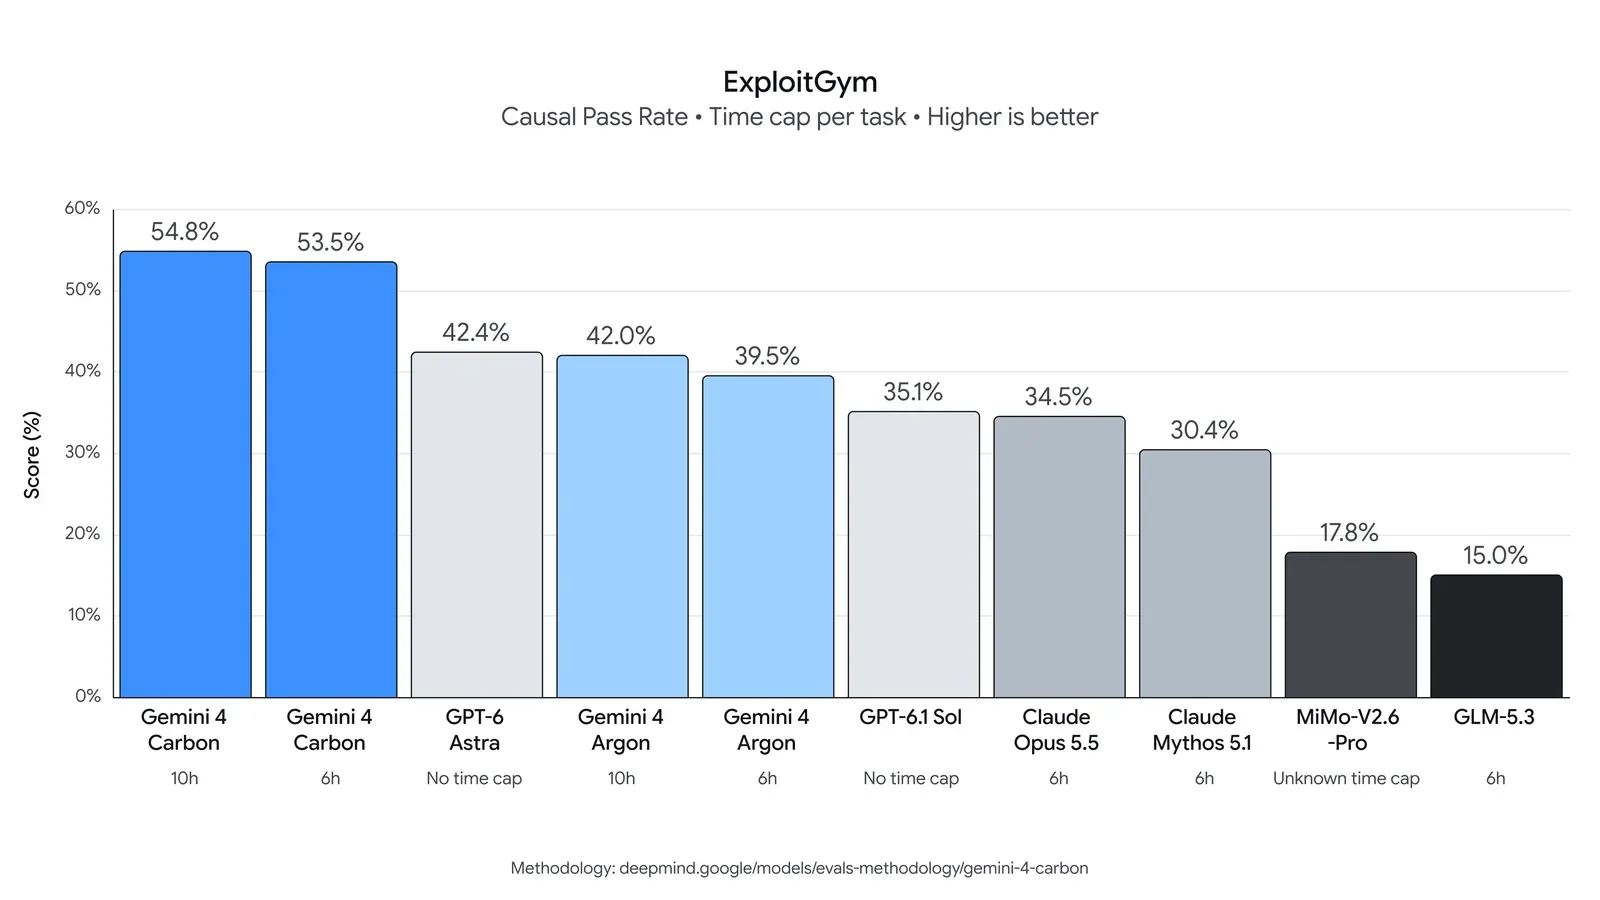
Google 把 Carbon 的資安能力寫成防禦生命週期三步(頁面標明外部基準未開防護評估):
| 關卡 | 基準 | Carbon(官網) |
|---|---|---|
| 找真實漏洞 | SEC-bench Pro | 88.2% |
| 驗證是否可利用 | ExploitGym | 54.8% |
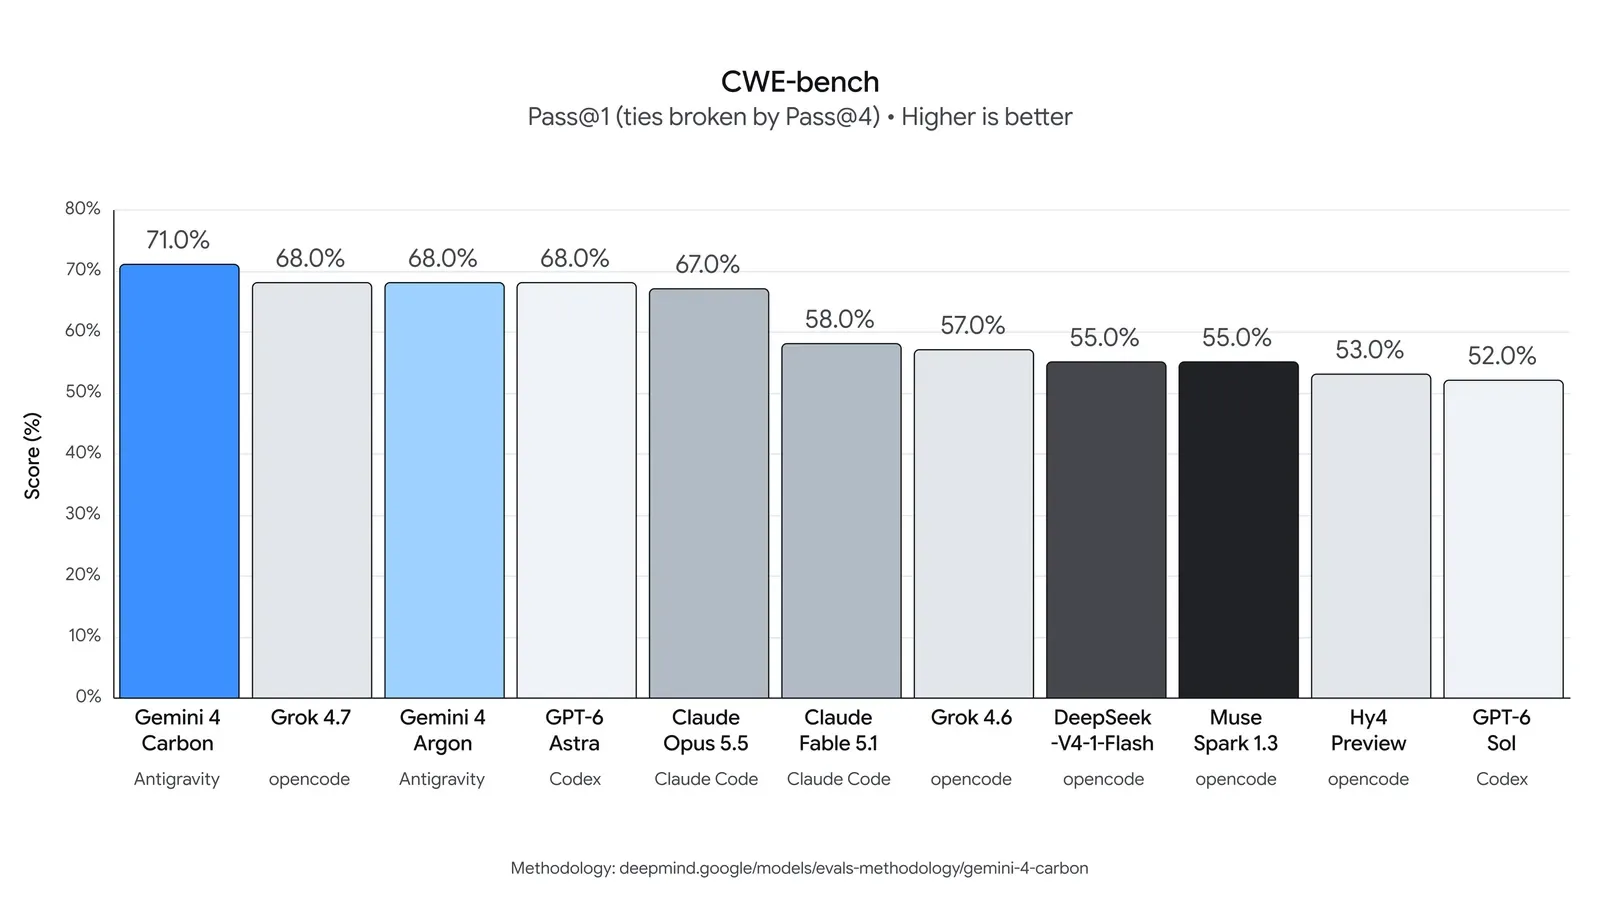
| 從根因修補 | Collinear CWE-bench | 71.0% |
內部基準另寫:產生安全程式碼的成功率相對 Argon 逾 2 倍;Chrome 團隊回報 Carbon 產出高品質修補相對「另一實驗室大型前沿模型」表現逾 10 倍;雲安平台 Wiz 亦觀察到它在網頁滲透測試相關基準領先(皆為頁面轉述)。
對齊與提示注入防護
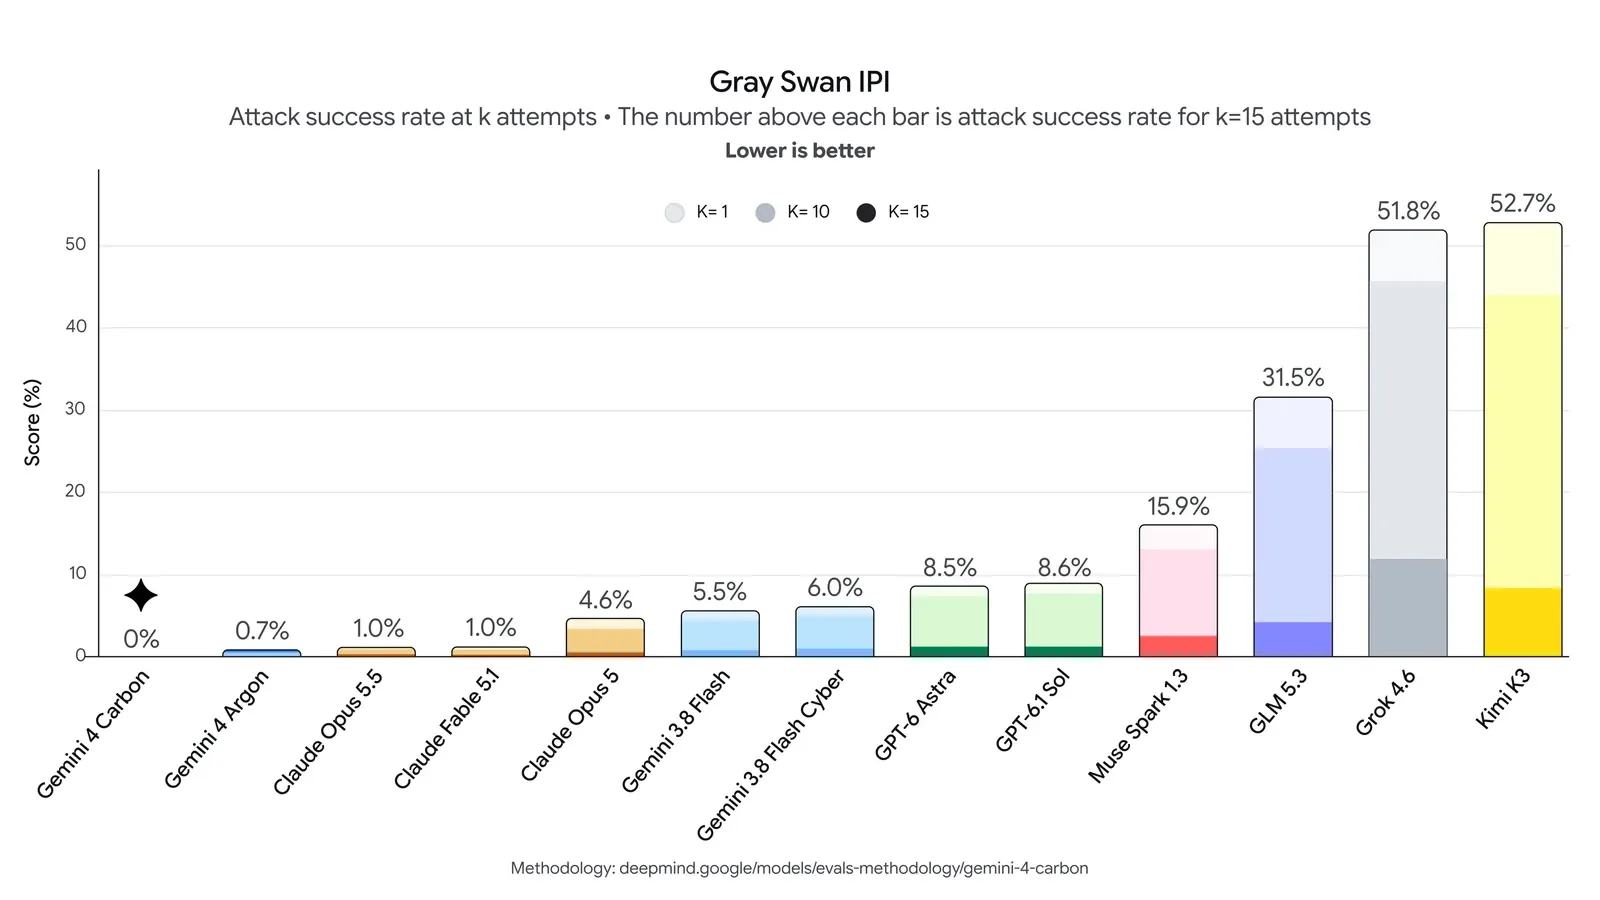
Carbon 延續 Argon 的多層安全堆疊(訓練、即時濫用防禦、提示注入韌性、思維鏈監控)。頁面摘要包括:Terminal-Bench 4.0 成功作弊降至 0.0%、嘗試作弊 0.4%;內部高嚴重未對齊警示約降 80%;無根據宣稱相對 Argon 約降一半;過度擴權降 26%、服務不足降 29%;Gray Swan Indirect Prompt Injection 攻擊成功率由 Argon 的 0.7% 降到 Carbon 的 0.0%。
現在誰用得到、怎麼讀數字
目前還不是全面開放給一般開發者與消費者:先是部分 cyber defenders,再經 Fairwind 擴大。價格與基準皆以 Google 原文 為準;基準第一名不等於你手上任務一定過關,對外系統仍需人工覆核與既有安全流程。