各代理只交壓縮結果
AWS 在 2026 年 11 月 4 日發表系列第二篇,談生產環境裡的四層上下文工程,並用 Deep Insight 的程式說明。Deep Insight 是開源的多代理資料分析方案,建在 Strands Agents SDK 與 Amazon Bedrock AgentCore 上。文末連結的儲存庫是 aws-samples/sample-deep-insight。這篇是 Part 2。Part 1 談五個生產挑戰,Part 3 預告會寫私有網路部署,文中標成即將推出。
下面的約 95% 與約 97%,都是這份參考實作裡的對照,不是任何專案照做就會得到的比例。
文中把做法收成四層:架構上隔離上下文、用提示詞控制輸出、把重的內容放到檔案、再用獨立代理與防護做驗證。各層補前一層做不到的地方。
單代理會把探索、分析、圖表、驗證與報告全堆在同一個視窗。文中舉的例子是分析銷售資料並做一份 DOCX 報告:載入與探索約 5 分鐘、分類銷售分析約 3 分鐘、五張時間序列圖約 10 分鐘、統計驗證約 3 分鐘、最終報告約 5 分鐘,合計超過 15 萬 token、約 15 分鐘。這是文章裡的例子,不是一份公開基準測驗。Amazon Bedrock 上的 Anthropic Claude Sonnet 4.5 視窗是 20 萬 token。視窗中途溢位、舊上下文拖累、出錯就要整段重跑,是他們要避開的情況。文中引用 Anthropic 在 2025 年 9 月的說法:上下文裡的 token 變多,模型從中準確回想的能力會下降。
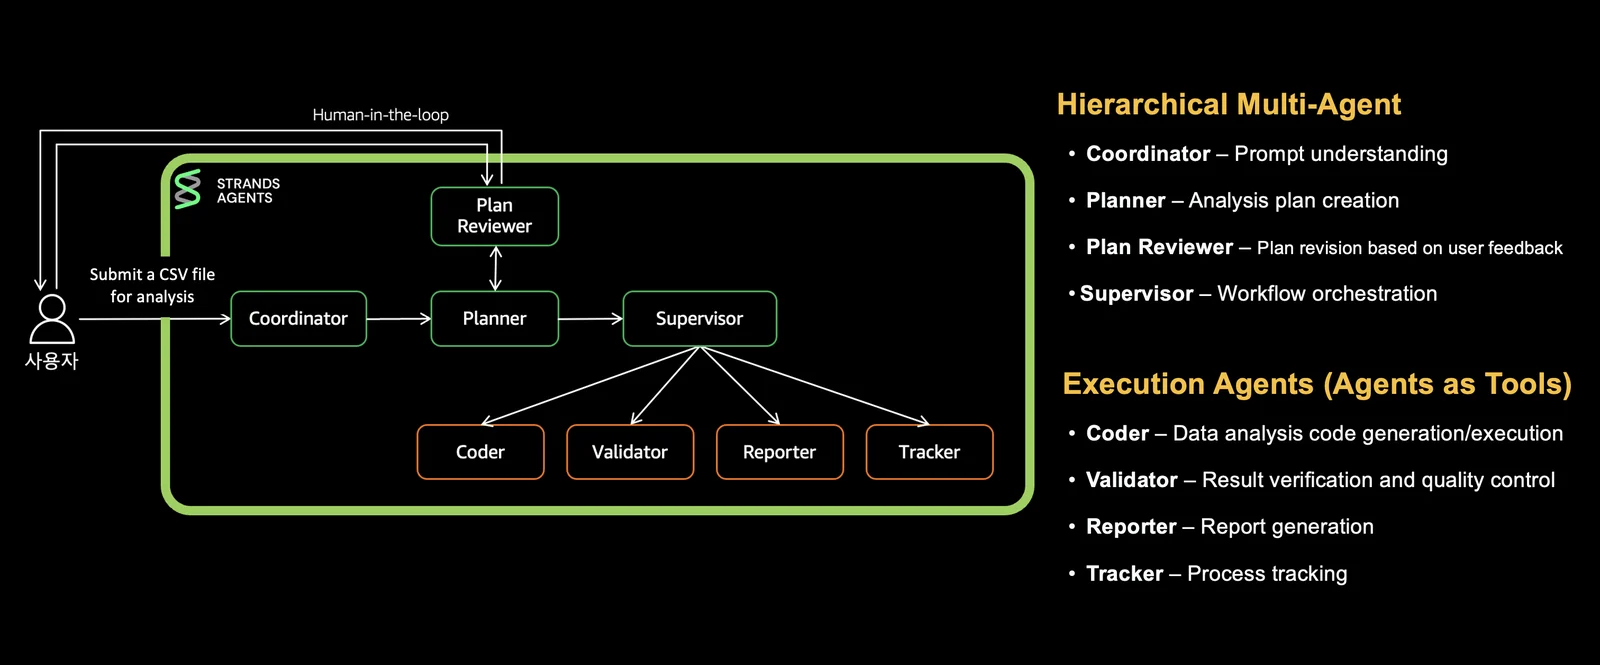
Deep Insight 用 Coordinator、Planner、Plan Reviewer、Supervisor,以及工具代理 Coder、Validator、Reporter、Tracker、Auditor。隔離之後,文中寫即使用得最多的 Coder,總上下文也低於 2.5 萬 token。代理之間只傳完成通知與簡短摘要。
共享狀態是一個 Python 字典 shared_state,只放四樣:上一則代理的最終訊息、各代理壓縮後的線索、Planner 產生並由 Tracker 更新的完整計畫,以及代理名稱與訊息的簡短歷程。線索用固定格式,不把整段對話傳過去。
下圖來自系列第一篇,畫的是同一套 Deep Insight。Supervisor 底下的執行代理是 Coder、Validator、Reporter、Tracker。Part 2 的正文另外寫了 Auditor,負責檢查最終報告。這張圖的執行代理清單沒有把 Auditor 畫成同層的盒子。Plan Reviewer 在圖上標成由人參與的步驟。Part 2 也寫,Plan Reviewer 不在快取表裡,因為它收集的是使用者的核准或回饋,不是去呼叫模型。
提示詞先規定回覆多短
隔離之後,若某個代理回得很長,Supervisor 的上下文仍會被撐大。第二層用提示詞限制回覆。
| 代理 | 輸出 token 上限 | 原因 |
|---|---|---|
| Coder | 1,000 至 1,500 | 分析程式存成檔案,只回狀態、已完成事項與洞察 |
| Validator | 800 | 驗證結果寫進 citations.json,只回摘要 |
| Reporter | 1,000 | 報告做成 DOCX,只回結果摘要 |
他們還要求每份腳本自給自足:變數不會留到下一份腳本,所以舊程式可以從上下文拿掉。Supervisor 的提示詞要求,目前這個代理的清單項目還沒全部標成完成,就不要切到下一個代理。
程式與結果留在檔案
提示詞擋不住很長的程式。第三層把重的內容留在檔案系統,上下文裡只留指標。
一般若把寫檔與執行分成兩個工具,一份約 100 行的腳本會整段進上下文,多份腳本可以累積超過 1,000 行。Deep Insight 的 Coder 改成一個 write_and_execute 工具:寫入並執行之後,只回短摘要。文中的例子是寫了 105 行、執行成功,上下文裡大約只留三行摘要,並依此說大約少了 95% 的 token。這是該例子相對「程式整段進上下文」的算法,不是所有專案的保證。
文中另外引用 Anthropic 在 2025 年 11 月〈Code Execution with MCP〉的數字:在執行層先過濾、再進上下文,token 從 15 萬降到 2 千,少 98.7%。那是 Anthropic 該文的數字,不是 Deep Insight 測到的 95%。
常用函式先做成 coder_analysis_utils.py,之後的分析改為匯入。文中寫,若每次重寫,10 次分析可以重複 200 至 300 行。改成匯入後,大約 20 至 30 行變成兩行 import。
詳細結果追加到 all_results.txt。沒有這份筆記時,Coder 每次都把細節交給 Supervisor。有筆記時,傳過去的大約是 30 個 token 的短句,Reporter 要寫報告時才去讀檔。檔案角色如下。
| 檔案 | 寫入者 | 讀取者 | 角色 |
|---|---|---|---|
all_results.txt |
Coder | Reporter | 分析結果的累積紀錄 |
calculation_metadata.json |
Coder | Validator | 數值計算的來源、公式與結果 |
citations.json |
Validator | Reporter | 已核對的引用 |
audit_findings.json |
Auditor | Reporter | 最終報告的引用問題,用來要求重試 |
coder_analysis_utils.py |
Coder | 各腳本 | 共用函式 |
full_plan(shared_state) |
Planner、Tracker | Supervisor | 清單完成狀態 |
技能也改成需要時才載入。若把每份技能指南都放進系統提示,會超過 2 萬 token,而且每次呼叫 Coder 都載入用不到的內容。Deep Insight 啟動時只放約 500 token 的目錄,裡頭是名稱與短說明。使用者要做 README 時,代理再讀取該技能的 SKILL.md,文中寫詳細指南大約 3 千 token。用約 500 token 的目錄取代超過 2 萬 token 的完整指南,文中寫大約少 97%。這同樣是這份實作的對照。新增技能是在 skills/ 底下加目錄與 SKILL.md,啟動時會被發現。
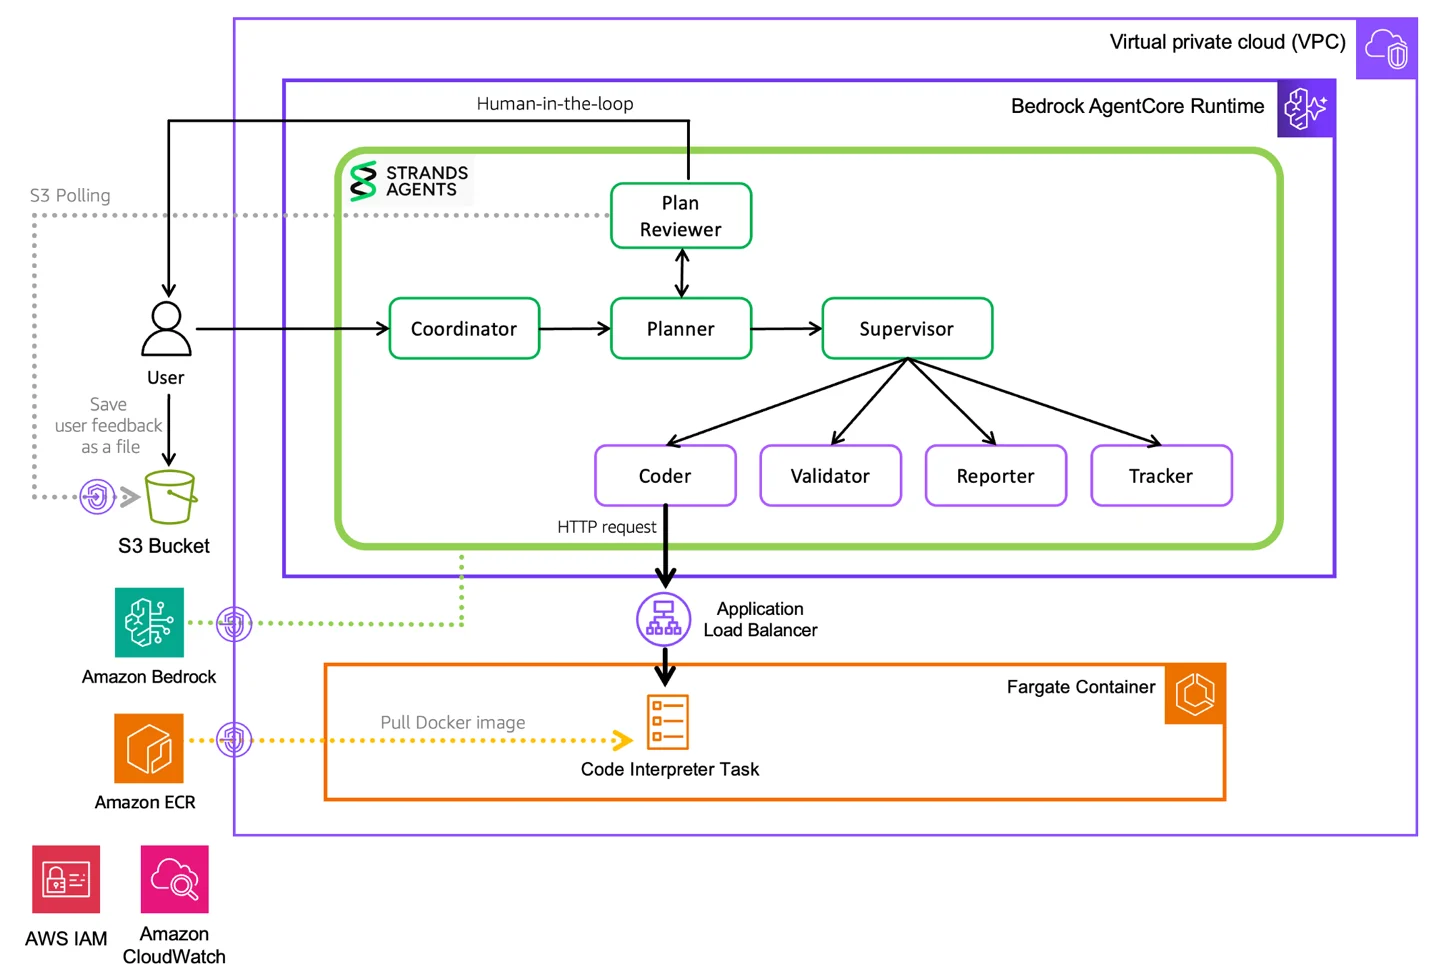
下圖來自 Part 1,是同一套參考實作的部署圖。Strands 多代理跑在 Bedrock AgentCore Runtime。Coder 的程式執行經負載平衡器進到 Fargate 上的程式解譯器,而不是把執行過程全部留在對話裡。Part 2 的 write_and_execute 講的是回傳摘要。這張圖講的是程式在哪裡跑。兩件事相關,但圖本身沒有標出 95%。
獨立複核與選擇性快取
前三層仍可能讓錯誤流進報告。第四層用 Tracker、Validator 與 Auditor。Tracker 依完成訊息把清單從未完成改成已完成。Validator 讀 calculation_metadata.json,用來源資料重算。文中寫,絕對差小於 0.01 視為相符,不符就標出。通過的計算寫進 citations.json。Auditor 對照最終 DOCX、citations.json 與 calculation_metadata.json,只讀不改,把引用問題寫進 audit_findings.json,最多可以要求 Reporter 針對問題重試兩次。
計算太多時不會全部重算。超過 50 筆:所有高重要性,加上 10 筆中重要性。超過 20 筆:所有高重要性,加上 15 筆中重要性。20 筆或更少:所有高重要性、所有中重要性,再加 5 筆低重要性。比較前把值轉成 float,避免數值型別不一致。
視窗仍可能溢位。他們用 Strands 的 SummarizingConversationManager:溢位時把最舊的一半訊息收成一段,並保留最近 10 則。摘要提示要求線索、計畫與追蹤狀態原樣保留。
快取按代理開啟。文中寫,有開啟的代理在重複呼叫上,輸入 token 成本最多可降 90%。這是上限,而且只針對會重複用到同一提示的代理,不是每一則請求。
| 代理 | 提示詞快取 | 工具快取 | 原因 |
|---|---|---|---|
| Supervisor | 開 | 開 | 重複呼叫多,系統提示與工具定義大 |
| Coder | 開 | 開 | 連續跑多份分析,提示相同 |
| Reporter | 開 | 開 | 分段寫報告,提示重複高 |
| Auditor | 開 | 開 | 多輪檢查同一組提示與工具,Reporter 重試後再跑 |
| Coordinator | 關 | 關 | 一次性呼叫 |
| Planner | 關 | 關 | 每個請求呼叫一次,只有使用者要改計畫才再呼叫 |
| Validator | 關 | 關 | 每次資料不同,命中率低 |
| Tracker | 關 | 關 | 工作輕,沒有工具 |
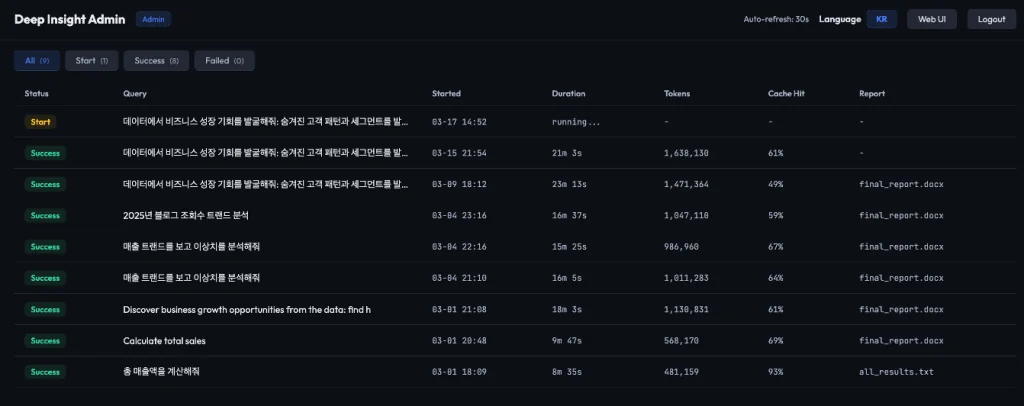
下圖是 Part 1 的管理畫面,不是 Part 2 的 95% 或 97% 實驗圖。畫面有 Tokens 與 Cache Hit 欄,各列的命中比例並不相同。不能把畫面上的某一列,讀成所有專案都會達到的快取比例,也不能拿來代替上表的「最多 90%」。