研究比較,不是看診建議
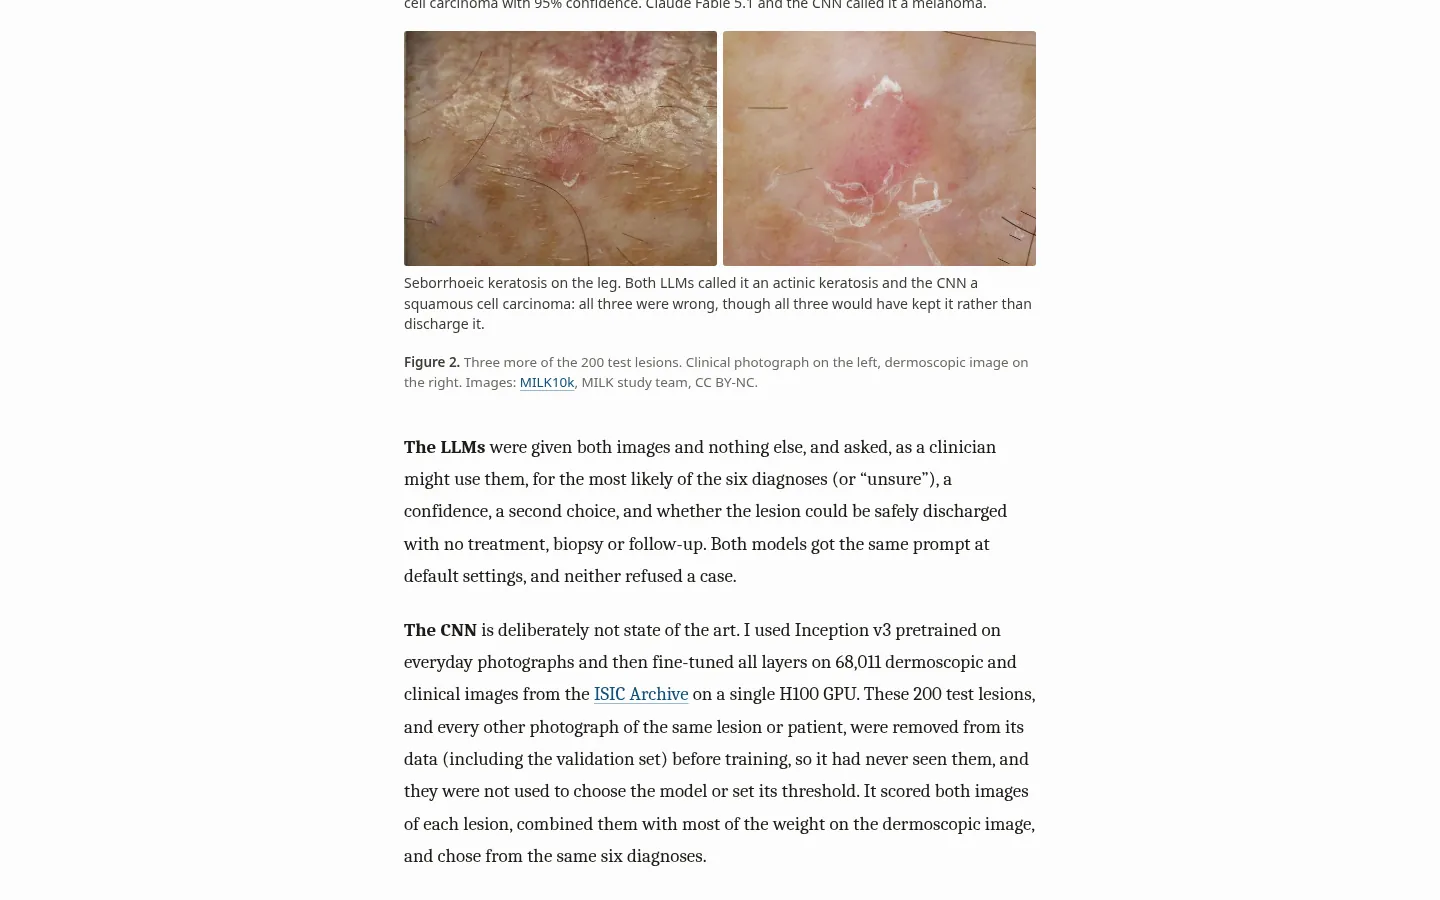
英國皮膚科顧問醫師 Dr Magnus Lynch(Guy's Hospital/King's College London)在 2026 年 10 月 25 日發表實驗:把 GPT-6 Astra、Claude Fable 5.1 與一個約十年的 Inception v3 CNN,拿來辨識同一批皮膚病灶。
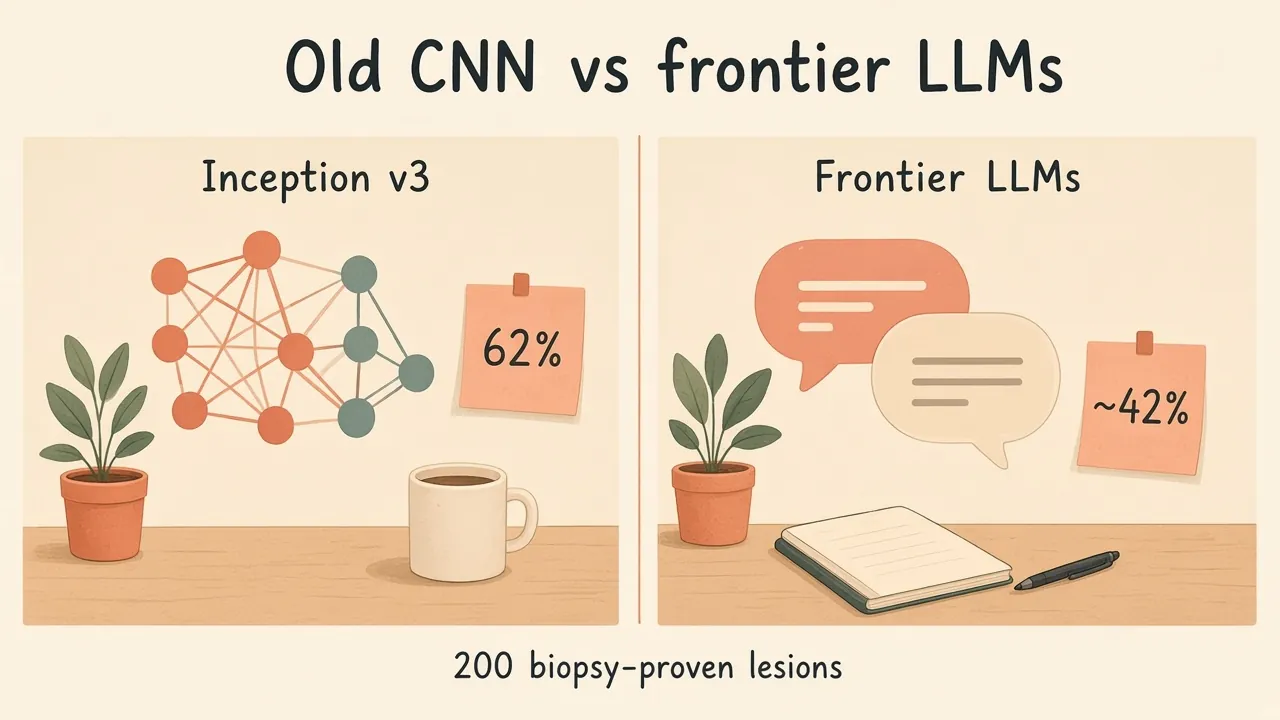
結論很刺眼:在 200 個病理證實病灶上,CNN 第一選擇正確 125/200(62%),兩個前沿 LLM 分別 84 與 85(約 42%)。本文只整理這項研究比較,不能當作診療、篩檢或出院建議。
病灶影像來自 MILK10k(ISIC,CC BY-NC)。基於非商業授權限制,封面未使用病灶原圖,改以示意插圖;正文截圖為研究文頁面。
200 例怎麼抽、怎麼問
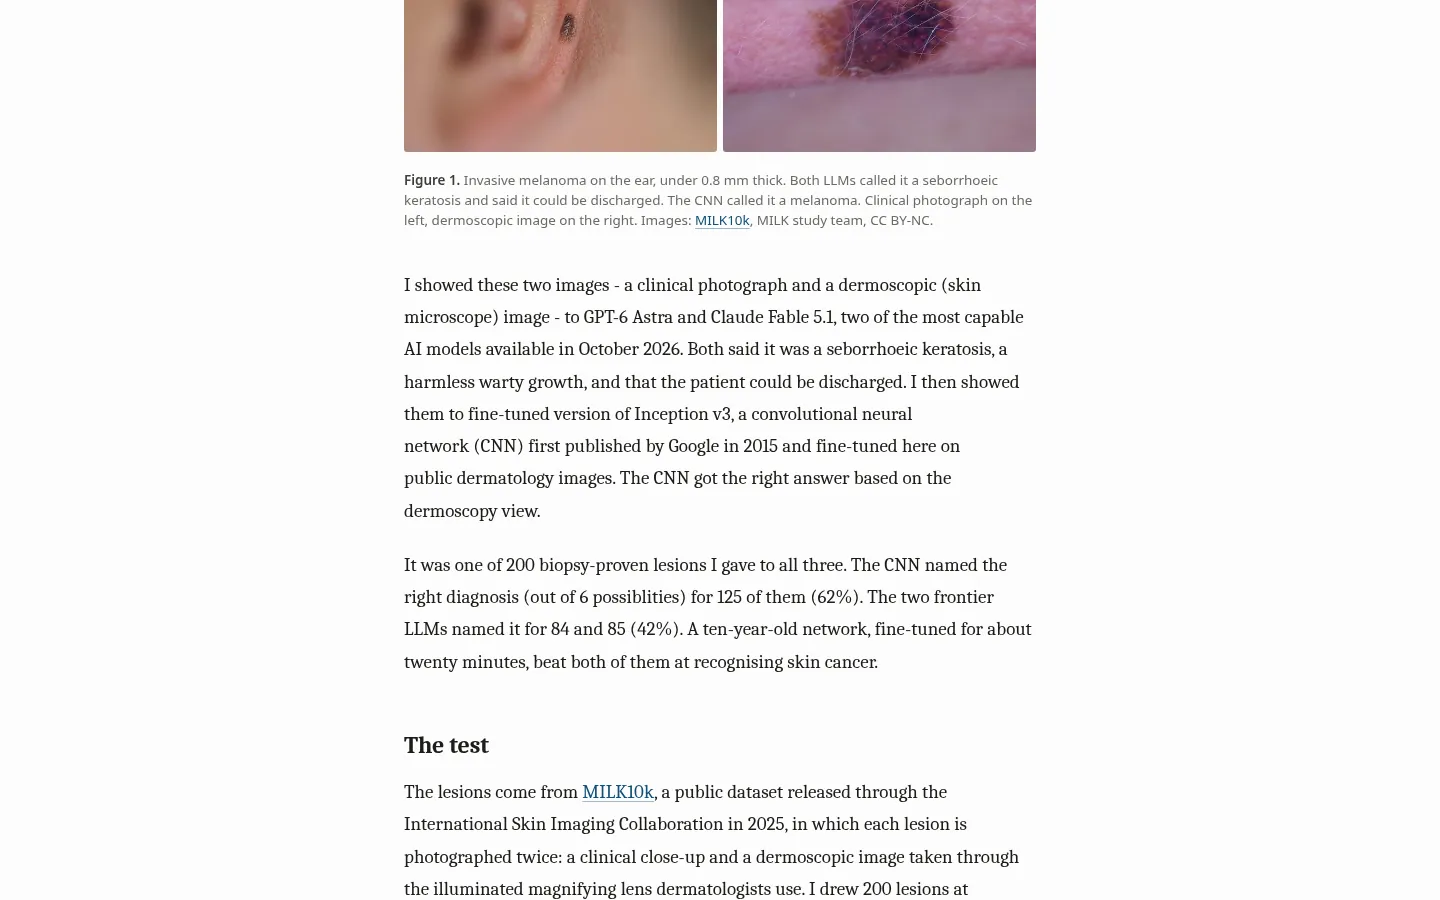
語料:MILK10k 公開資料,每例有臨床近拍+皮膚鏡圖。隨機抽 200 例,皆經組織病理確認:
- 不該出院 100:黑色素瘤 30、基底細胞癌 25、鱗狀細胞癌(含 Bowen)25、日光性角化 20
- 可安全出院 100:良性痣 50、脂溢性角化 50
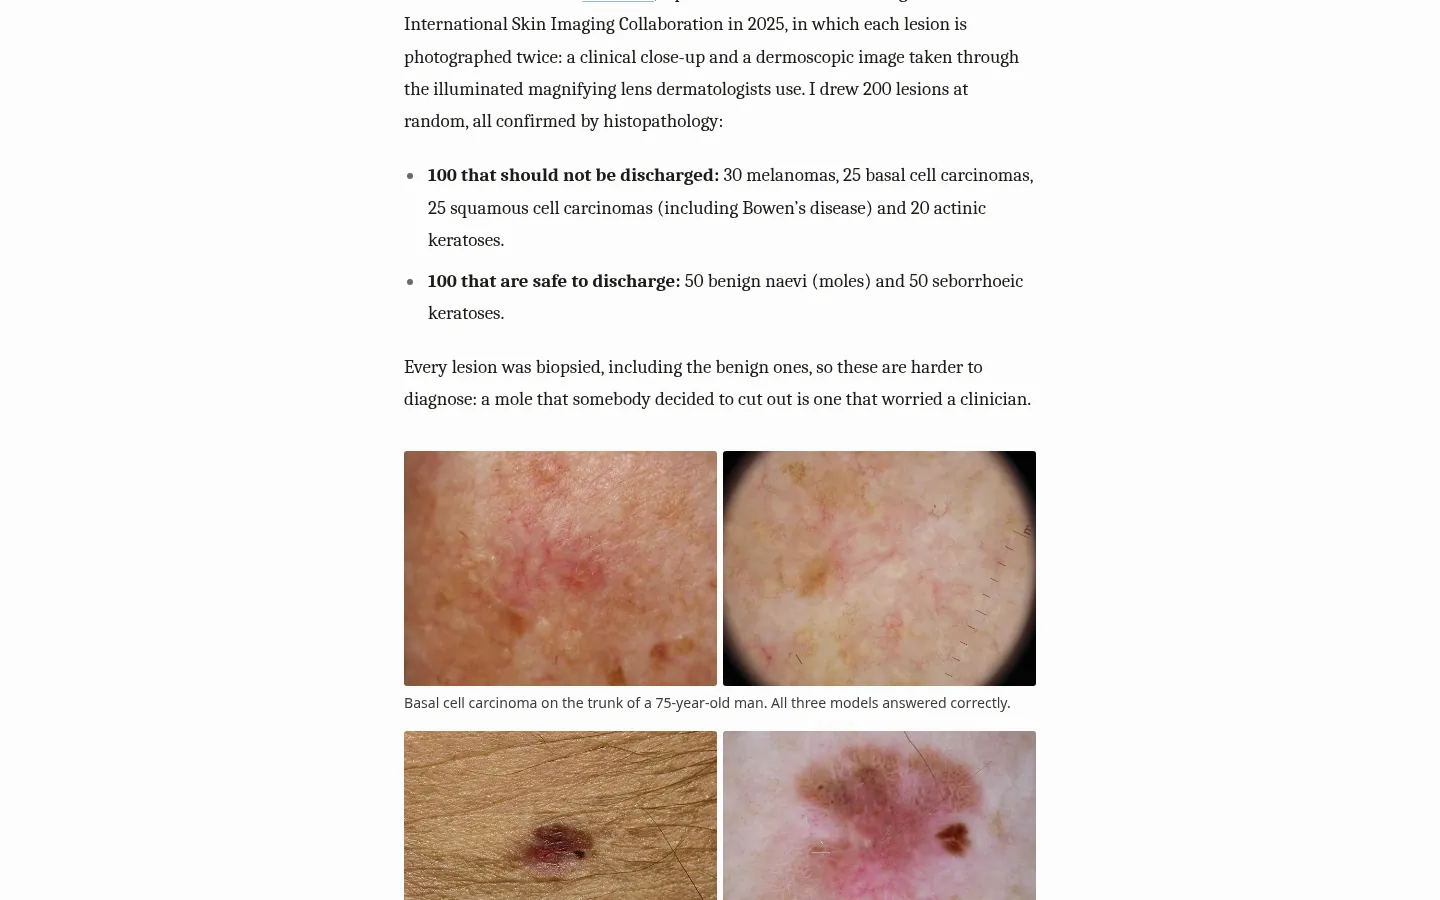
因連良性都做過切片,整體偏「臨床已擔心」的難題。LLM 收到兩張圖與同一提示(六選一或 unsure、信心、第二選擇、能否安全出院);CNN 用 ISIC 公開影像微調約二十分鐘(單卡 H100),訓練前剔除這 200 例及同病灶/同病患所有照片。
數字對照表
| 指標 | GPT-6 Astra | Claude Fable 5.1 | CNN(Inception v3) |
|---|---|---|---|
| 第一選擇正確(/200) | 84(42%) | 85(42%) | 125(62%) |
| 第一或第二選擇正確 | 134 | 138 | 173 |
| 黑色素瘤第一選擇(/30) | 8 | 11 | 13 |
| 不安全病灶被留下(/100) | 97 | 96 | 預設閾值 77;對齊後可 98 或 99 |
| 安全病灶被出院(/100) | 32 | 22 | 預設閾值 76 |
| 黑色素瘤被出院(/30) | 3 | 4 | 預設閾值 18;對齊後 2 或 1 |
CNN 在無害病灶辨識差距最大(痣 37/50、脂溢性角化 26/50)。LLM 常有「最愛答案」:Astra 把 75 例叫成基底細胞癌(實際 25),Fable 把 53 例叫成日光性角化(實際 20)。
限制寫得很清楚
作者自列:樣本小、黑色素瘤僅 30 例不確定性大;LLM 每例只跑一次;皆為已切片難題;MILK10k 自 2025 公開,LLM 理論上 可能看過(若有只會幫忙 LLM);Inception v3 只是基線,臨床監管產品通常更好。另以病患口吻只問「要不要看醫生」時,兩 LLM 幾乎對所有病例(含無害)都建議就醫。
本文建議:做醫學影像產品時,專用視覺模型仍可能勝過「通用多模態聊天」;引用時務必附 caveats,且不要把任何模型輸出當成診斷。完整案例、提示與程式在作者提供的下載包。