什麼被外洩、影響多大
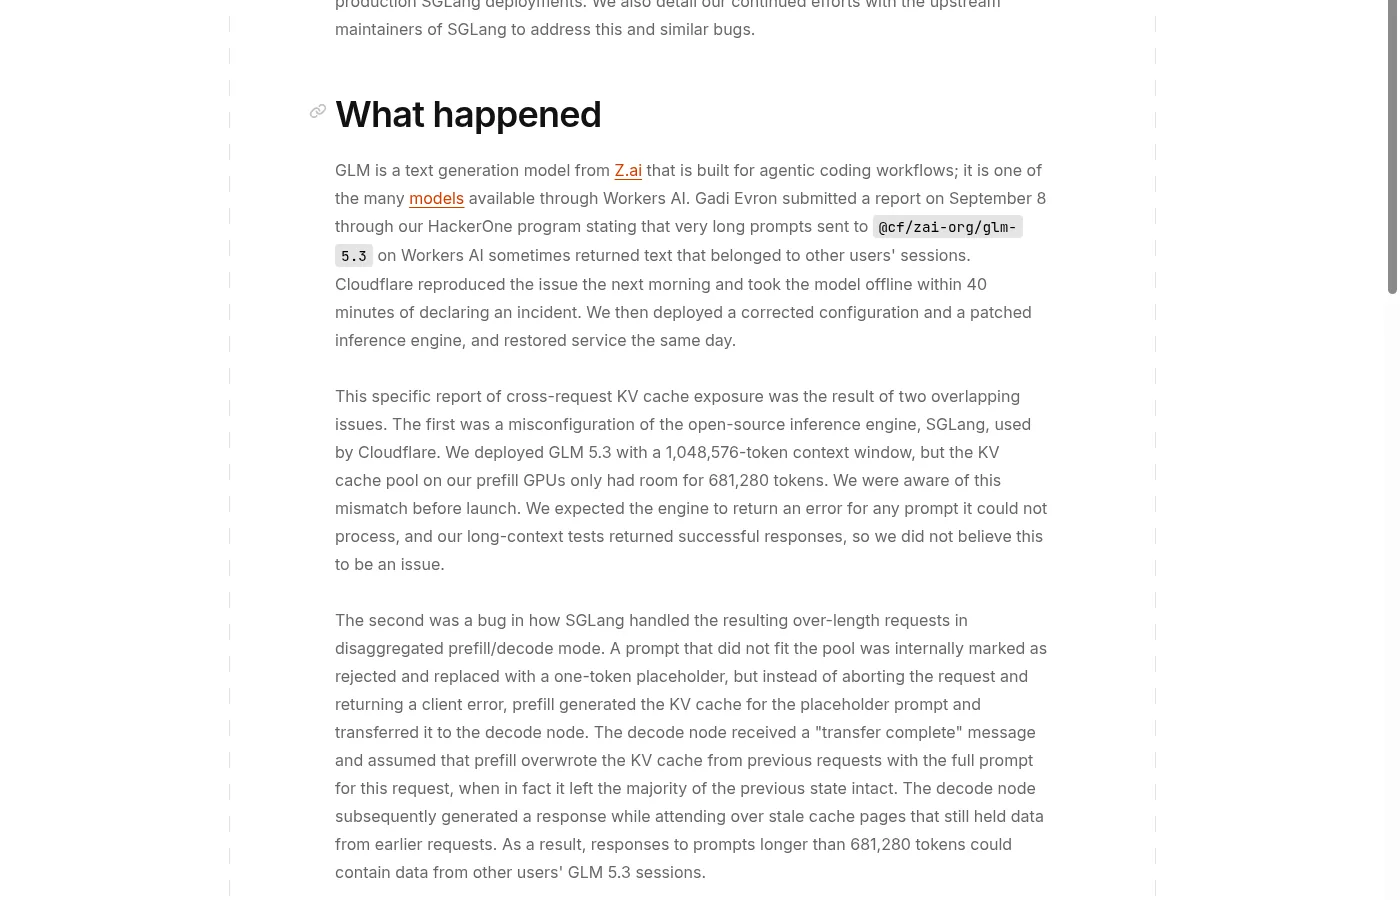
2026 年 10 月 26 日,Cloudflare 與 SGLang/研究人員協調披露:Workers AI 上的 GLM-5.3(@cf/zai-org/glm-5.3)曾出現跨請求 KV cache 外洩。使用者可能收到含其他客戶稍早請求內容的回應。
【事實|Cloudflare】
- 暴露窗口:2026-08-27(模型上線)至 09-09(修復後恢復)
- 受影響回應共 155 則;皆為提示長度超過 681,280 token
- 排除自家測試與回報者後,流量型態符合一般長上下文使用,未發現刻意利用
- 僅此模型受影響;Workers AI 其他模型確認未中招
- 09-08 經 HackerOne 由 Knostic 的 Gadi Evron 回報;09-09 驗證後約 40 分鐘內將模型設為私有,當日完成修補並恢復
兩層原因:設定+引擎
架構上,Workers AI 用 SGLang 做 prefill/decode 分離:prefill GPU 產 KV cache,經 RDMA(Mooncake)交給 decode GPU 生成。
- 設定:上下文長度設為 1,048,576 token,但 prefill 的 KV pool 實際只有 681,280 token。團隊事先知道差異,誤以為引擎會對放不下的提示回錯誤;長上下文測試卻常拿到成功 HTTP。
- 引擎 bug:超長提示在 disaggregated 模式下被標為拒絕並換成單 token 佔位,卻仍走完 handoff;decode 以為拿到完整新 cache,實際多數頁面仍是前一請求殘留,於是回應可能夾帶他人資料,且回 HTTP 200。
怎麼修、建議其他營運者
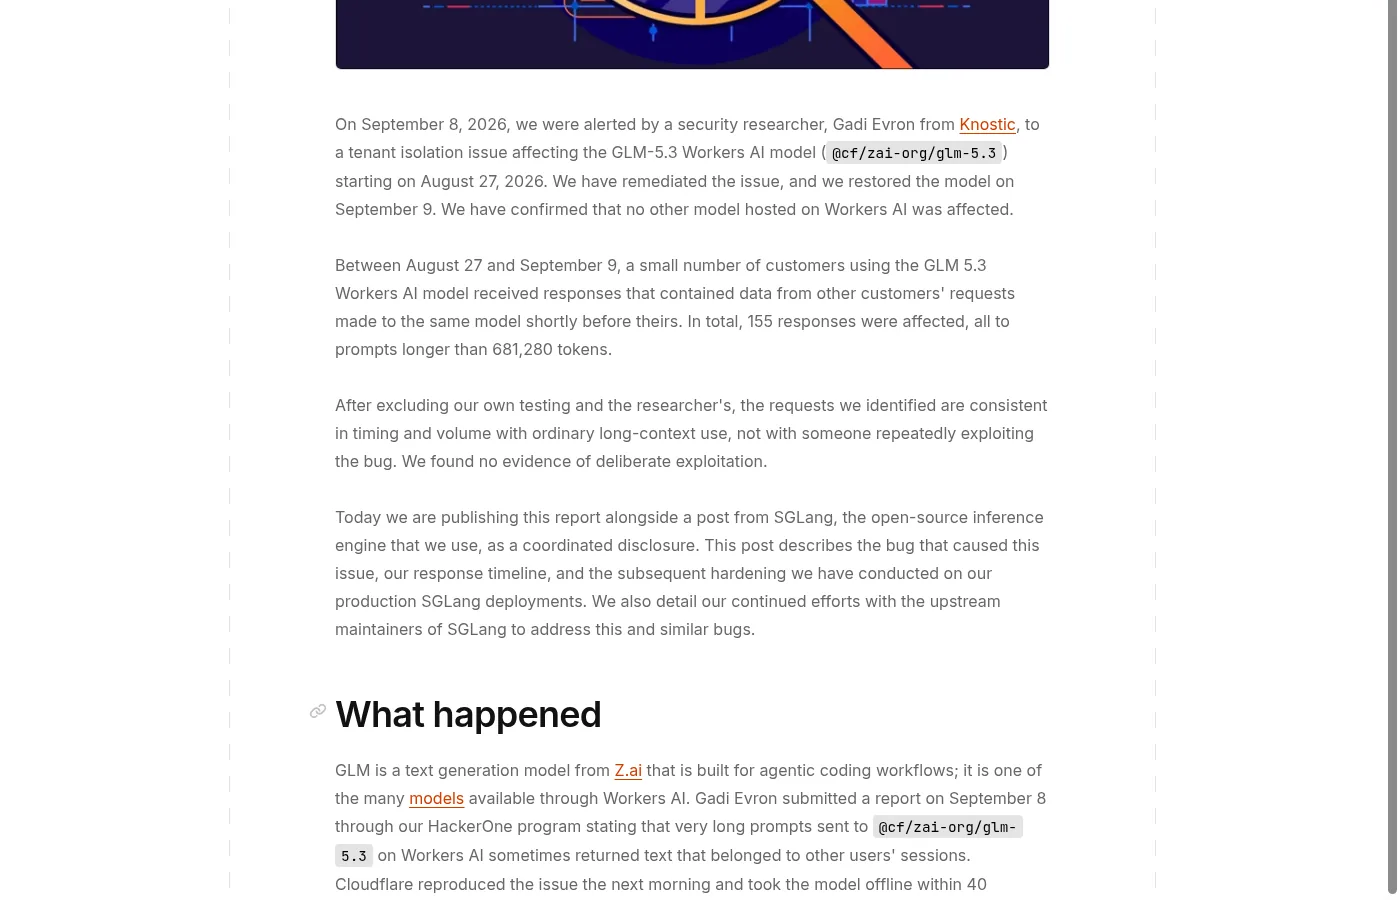
立即措施:擴大 prefill KV pool(約 204 萬 token,約為上下文兩倍),使合法請求碰不到拒絕路徑;並修引擎,讓帶 pending rejection 的請求在 admission 就以原錯誤結束、不做 KV 傳輸。上游相關修正含 #36988、#38935 等;建議營運者升到 SGLang v0.5.22 或之後。Cloudflare 亦對所有 SGLang 部署做硬化(deferred release、傳輸批次上限、部署前檢查 pool vs context 等)。
時間線與讀這篇的重點
官網時間線(UTC)從 08-27 上線暴露,到 09-08 回報、09-09 下線/修補/恢復,再到 10-02/10-19 上游發版、10-26 協調公開。完整步驟以 Cloudflare 原文 為準。
【解讀】 這是推理引擎記憶體生命週期與多租戶隔離的實務課:長上下文+disaggregation 時,pool 必須 ≥ context,且拒絕路徑不能「看起來像成功」。自架 SGLang 的團隊應對照文末營運者檢查清單。