用逐字稿校正記錯筆記
Anthropic 在 2026 年 11 月 6 日發表研究,談代理怎麼整理記憶。重點不是記愈多愈好。筆記可能一開始就寫錯,也可能在環境變了之後過時。他們把事後對照原始逐字稿、修正筆記、合併重複、再留下小型索引的做法叫做 dreaming。
這篇是工程研究與評估,不是宣布所有 Claude 使用者都多了一個可點的 dreaming 按鈕。文中把記憶和另外三件事分開:不改模型權重,所以不是重新訓練;不是單次對話裡的暫時學習;也不是把舊對話收成摘要以便續寫的 compaction。compaction 是用摘要換掉較舊回合,不是無損壓縮。文中用睡眠打比方,只是在說明離線整理,不是人類睡眠研究,也沒有任何 ADHD 或療效說法。
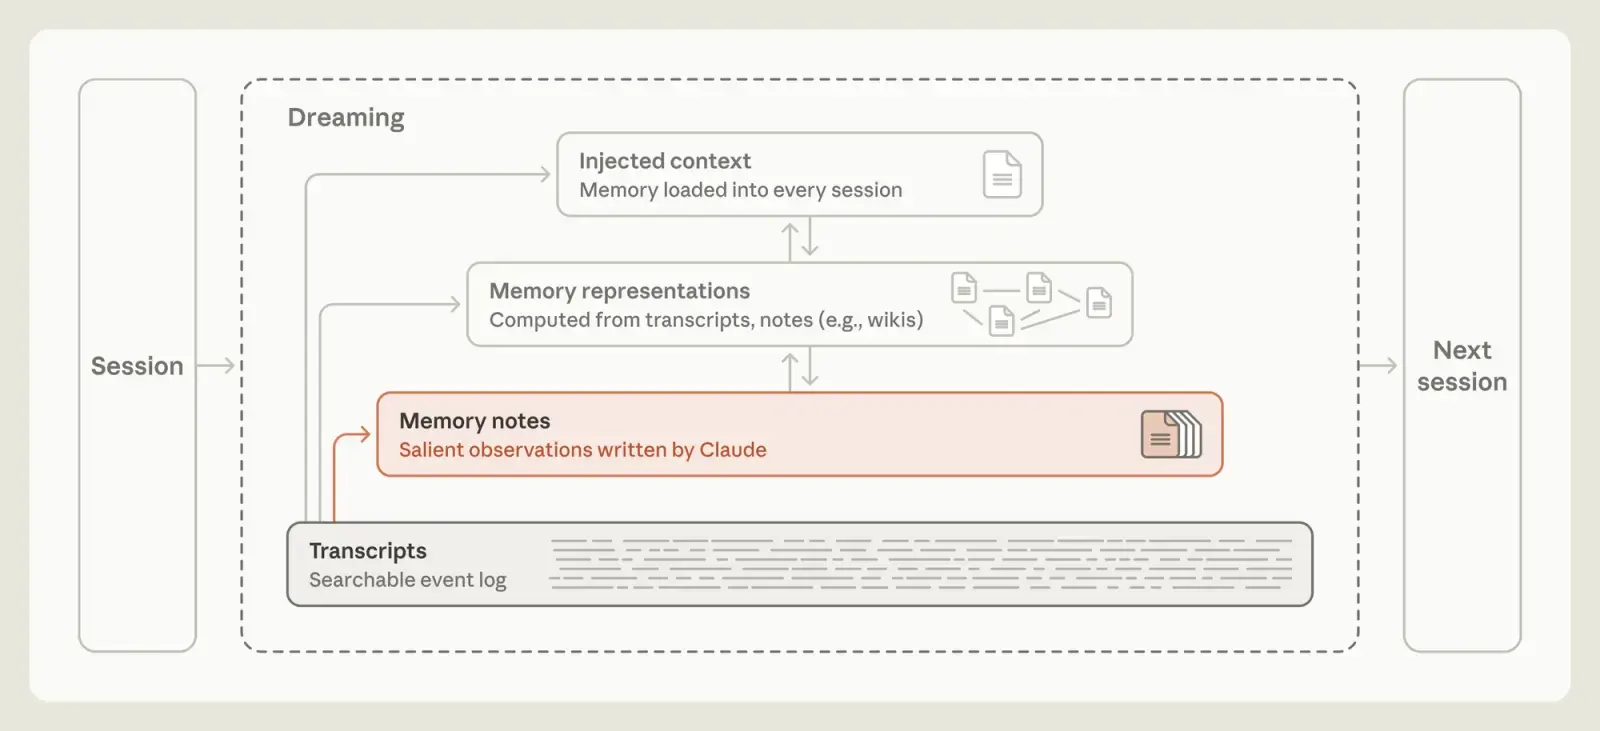
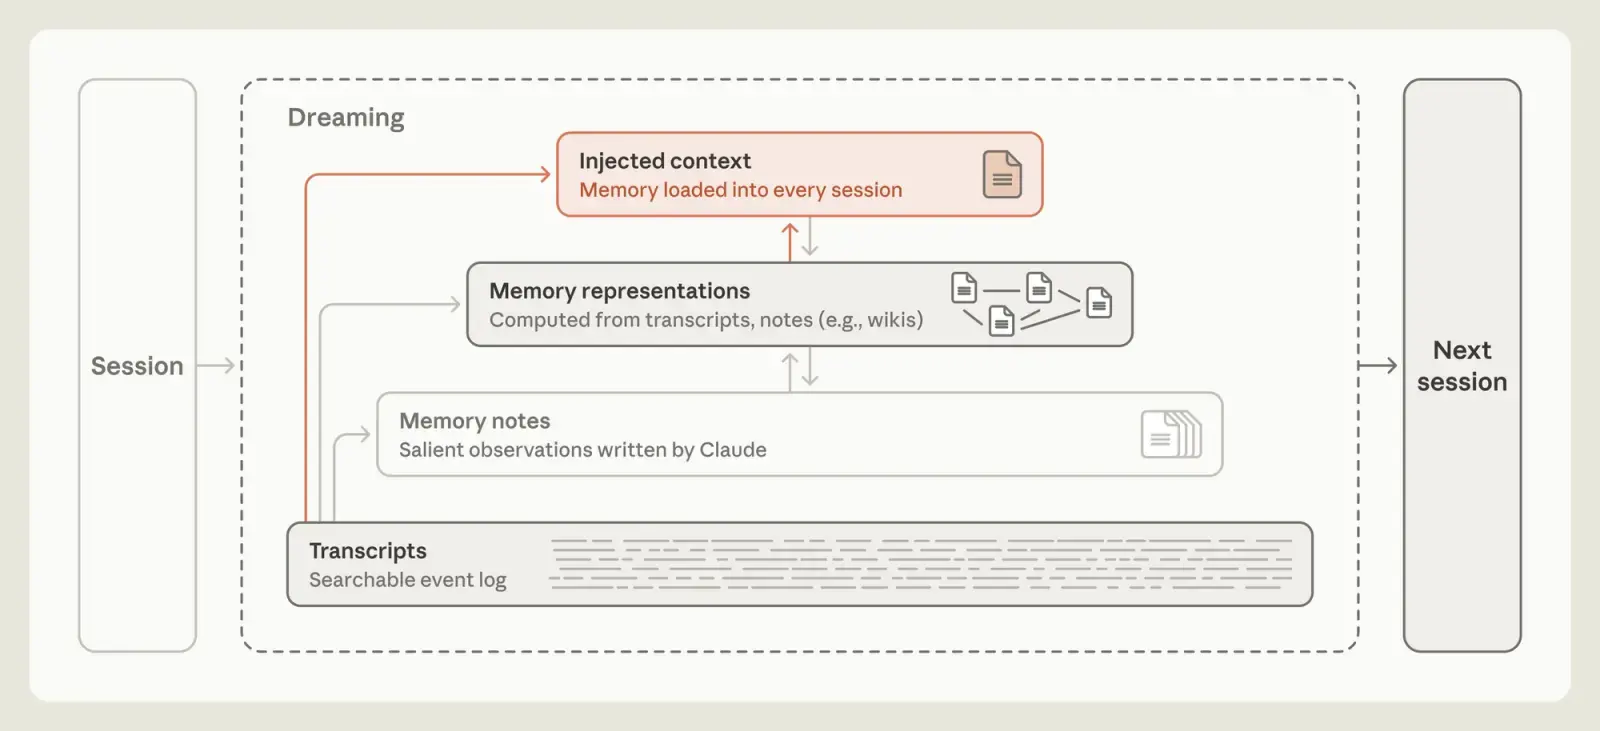
圖由下到上是可搜尋的逐字稿、Claude 寫下的記憶筆記、維基這類整理結果,以及每次新對話會先載入的注入內容。虛線框標成 Dreaming。這張把「用逐字稿校正筆記」那一層塗亮。
資料庫任務看平均報酬
Continual Learning Bench(CL-Bench)1.0 裡有一個資料庫查詢任務。Claude Managed Agents 每一題開新對話,但可以讀寫一個跨題保留的記憶資料夾。答錯之後,模型可以記下失敗、提出原因、再檢驗,變成下一題用的規則。
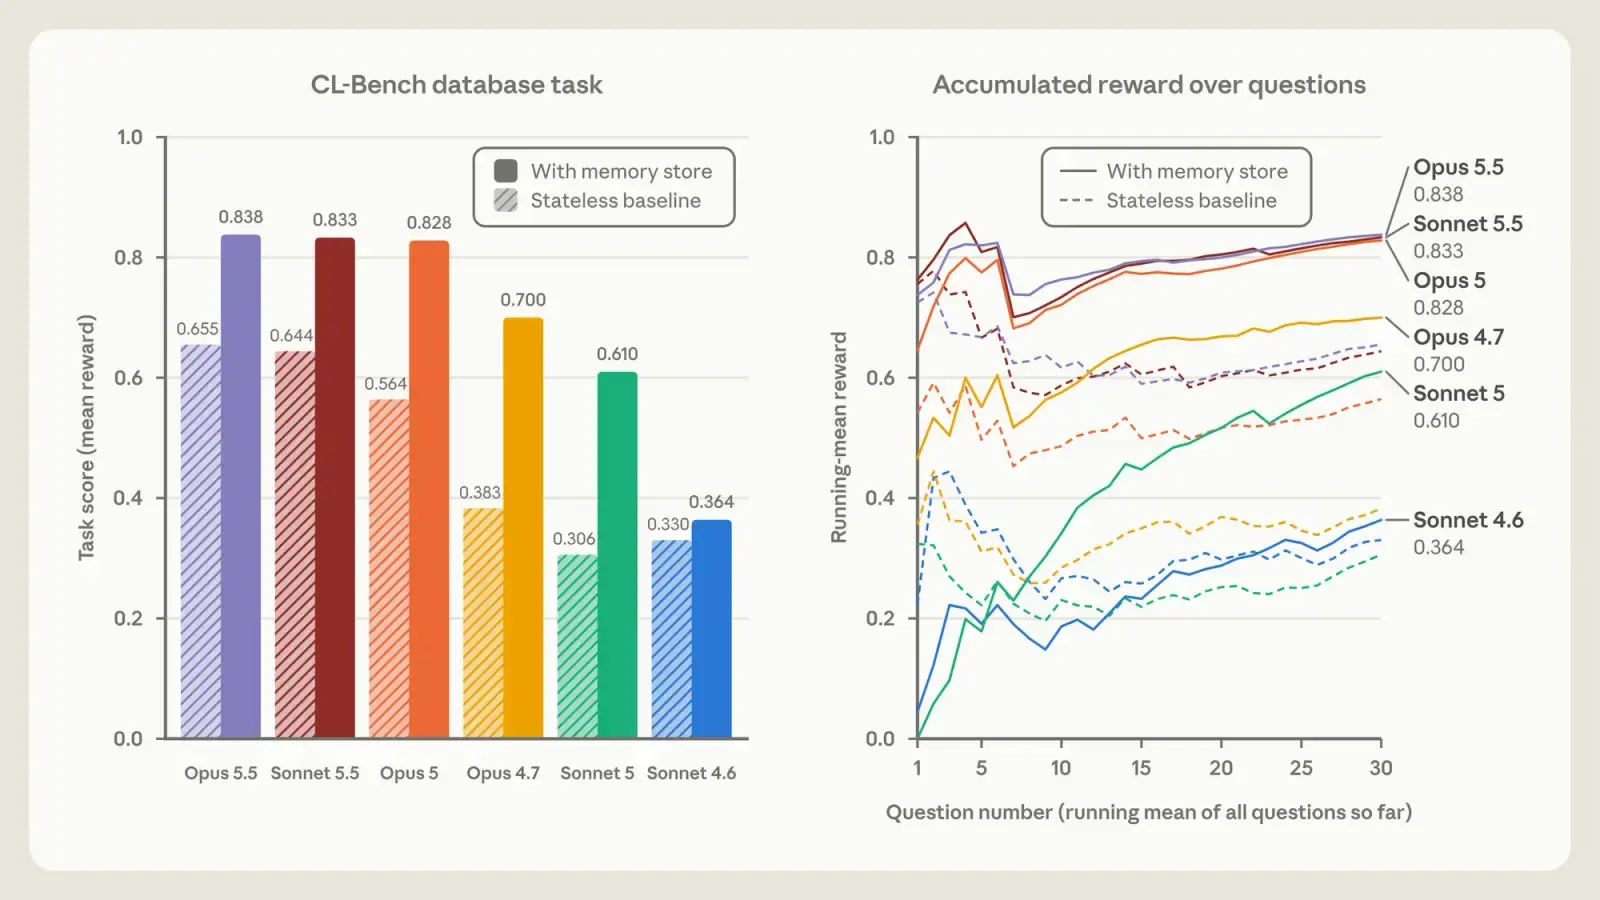
下面的數字是圖上的 mean reward(平均報酬),不是答對題數的百分比。封面左圖比較無記憶基準與有記憶資料夾,右圖是隨題目累積、截至當題的平均報酬。實心長條與實線是有記憶,斜線與虛線是無記憶。
| 模型 | 無記憶基準 | 有記憶資料夾 |
|---|---|---|
| Opus 5.5 | 0.655 | 0.838 |
| Sonnet 5.5 | 0.644 | 0.833 |
| Opus 5 | 0.564 | 0.828 |
| Opus 4.7 | 0.383 | 0.700 |
| Sonnet 5 | 0.306 | 0.610 |
| Sonnet 4.6 | 0.330 | 0.364 |
較強的模型比較會自己把這個迴圈走完。文中寫,Opus 5 是這組裡第一個把規則、怎麼知道它為真、先前答案和陷阱放在一起的。Opus 5.5 與 Sonnet 5.5 有記憶時的平均報酬和 Opus 5 差不多,但它們沒有記憶時的基準稍高。Sonnet 4.6 常常不讀記憶檔,有記憶只從 0.330 到 0.364。
另一張圖補上次數。Sonnet 4.6 在基準、只有記憶、以及記憶加更明確指示時,平均報酬是 0.330、0.364、0.641,各 3 次。0.330 到 0.641 接近兩倍,仍是平均報酬。圖上的參考線寫 Opus 4.7 有記憶 0.700(3 次)、Opus 5 有記憶 0.828(16 次)。誤差線左邊是各次的標準差,右邊是標準誤。
若規定只准記下失敗,增益會掉:Opus 5 少 0.234(3 次)、Opus 4.7 少 0.150(3 次)。Sonnet 4.6 只少 0.020,而且那一條是 1 次。不能據此認定所有模型在『只記失敗』限制下都會明顯退步。文中另寫,Sonnet 5 在沒有被額外提醒時,10 次有 9 次會先讀記憶。Sonnet 4.6 不到一半。
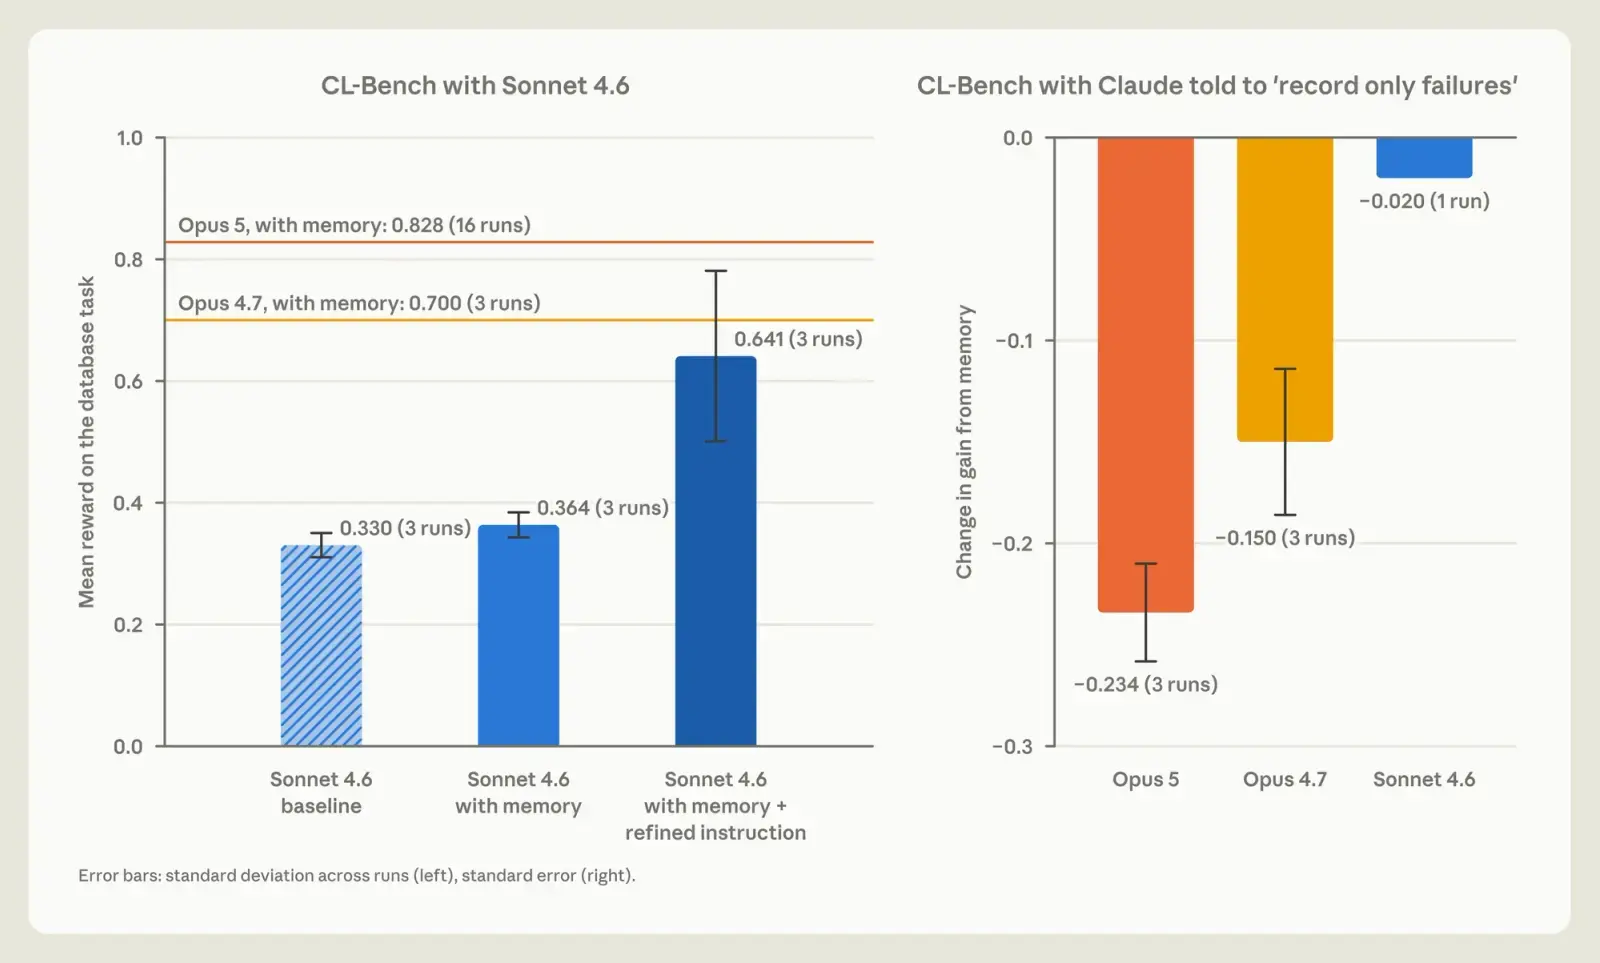
封面那張長條圖是同一組平均報酬,沒有標每次的次數。看數字時要連同這張圖的次數與誤差一起讀,不要把每一根長條都當成同樣的樣本數。
寶可夢少記比狂記有用
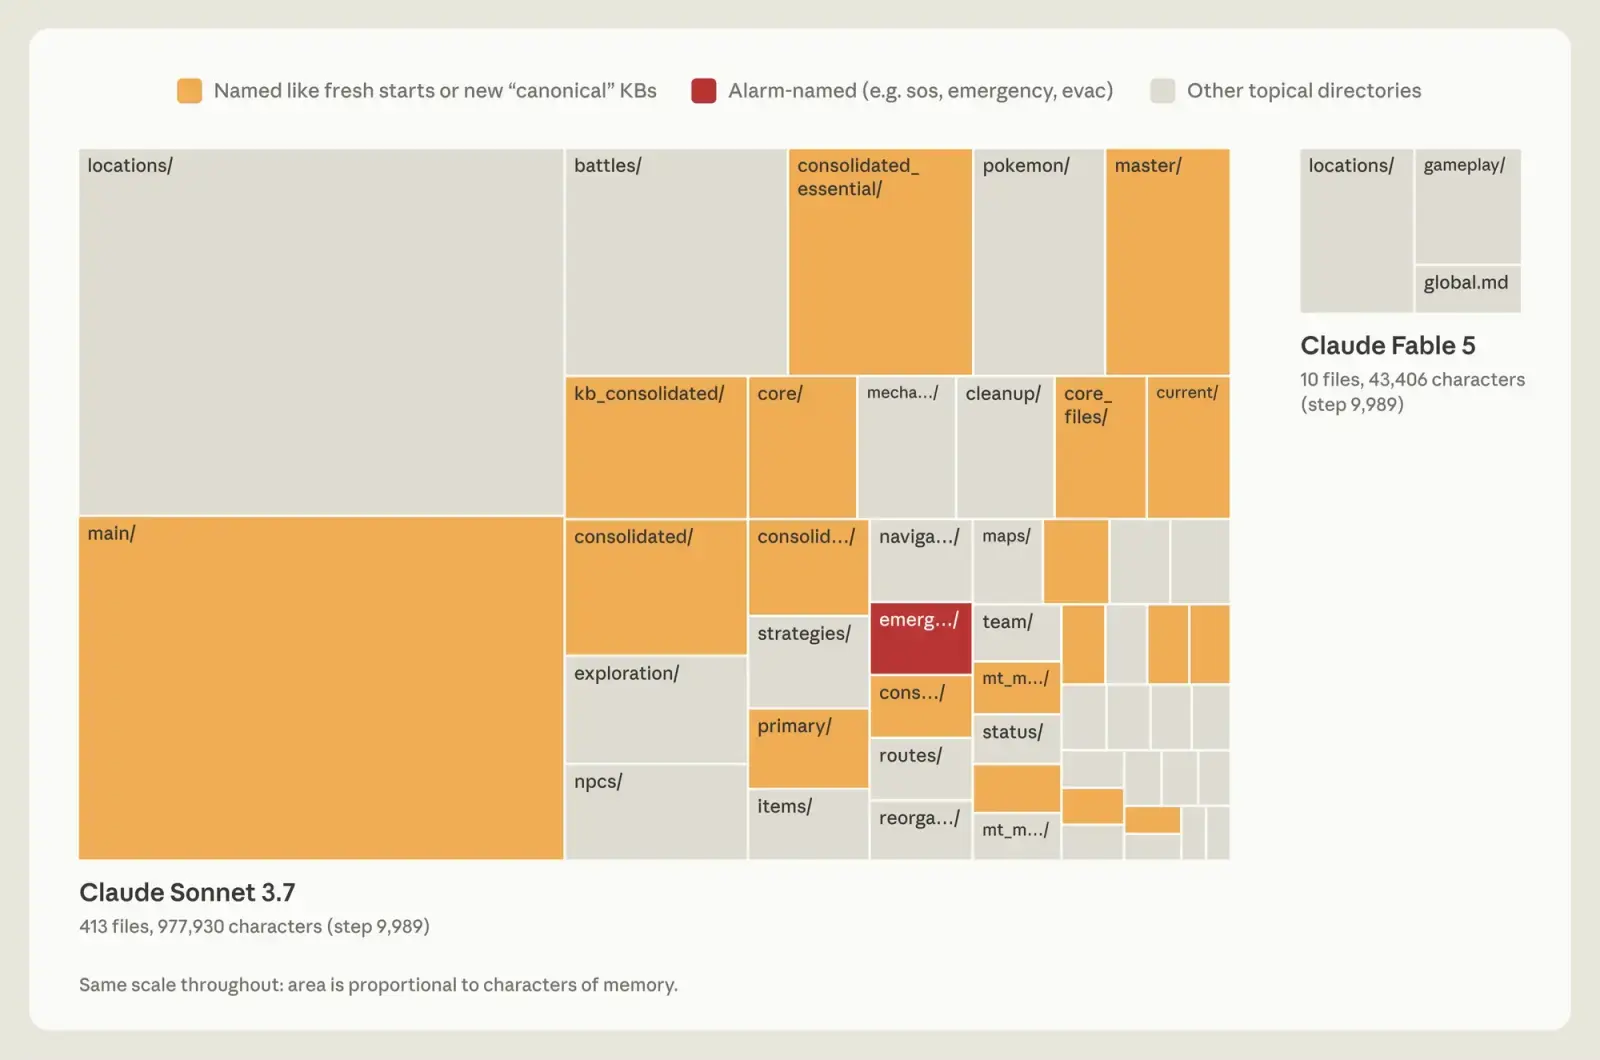
他們也用寶可夢紅版看模型會把什麼當成值得記。各跑一次,大約一萬步時比較資料夾。圖上記在第 9,989 步。
Sonnet 3.7 幾乎什麼都寫:413 個檔、977,930 個字元。正文另寫 225 個資料夾,只拿到 1 枚徽章。Fable 5 是 10 個檔、43,406 個字元,其中有頂層 global.md。正文說它是 9 個檔放在 2 個資料夾,再加這份 global.md,與圖上的 10 個檔一致,並拿到 4 枚徽章。面積照字元數,兩張圖同一比例。
這不是遊戲攻略。文中舉例,連續 7 顆精靈球沒抓到鯉魚王之後,模型自己寫下要改按鍵節奏。那是它選擇存下來的筆記,不是被驗證過的遊戲規則。畫面上看得到的金錢或座標,不必再存一份。策略與已檢驗的規則才需要寫下來。Sonnet 3.7 大約在第 1 萬步又開新的總檔,接下來 17 步只在整理檔案,遊戲裡沒有動作。
改正方位才走到下一城
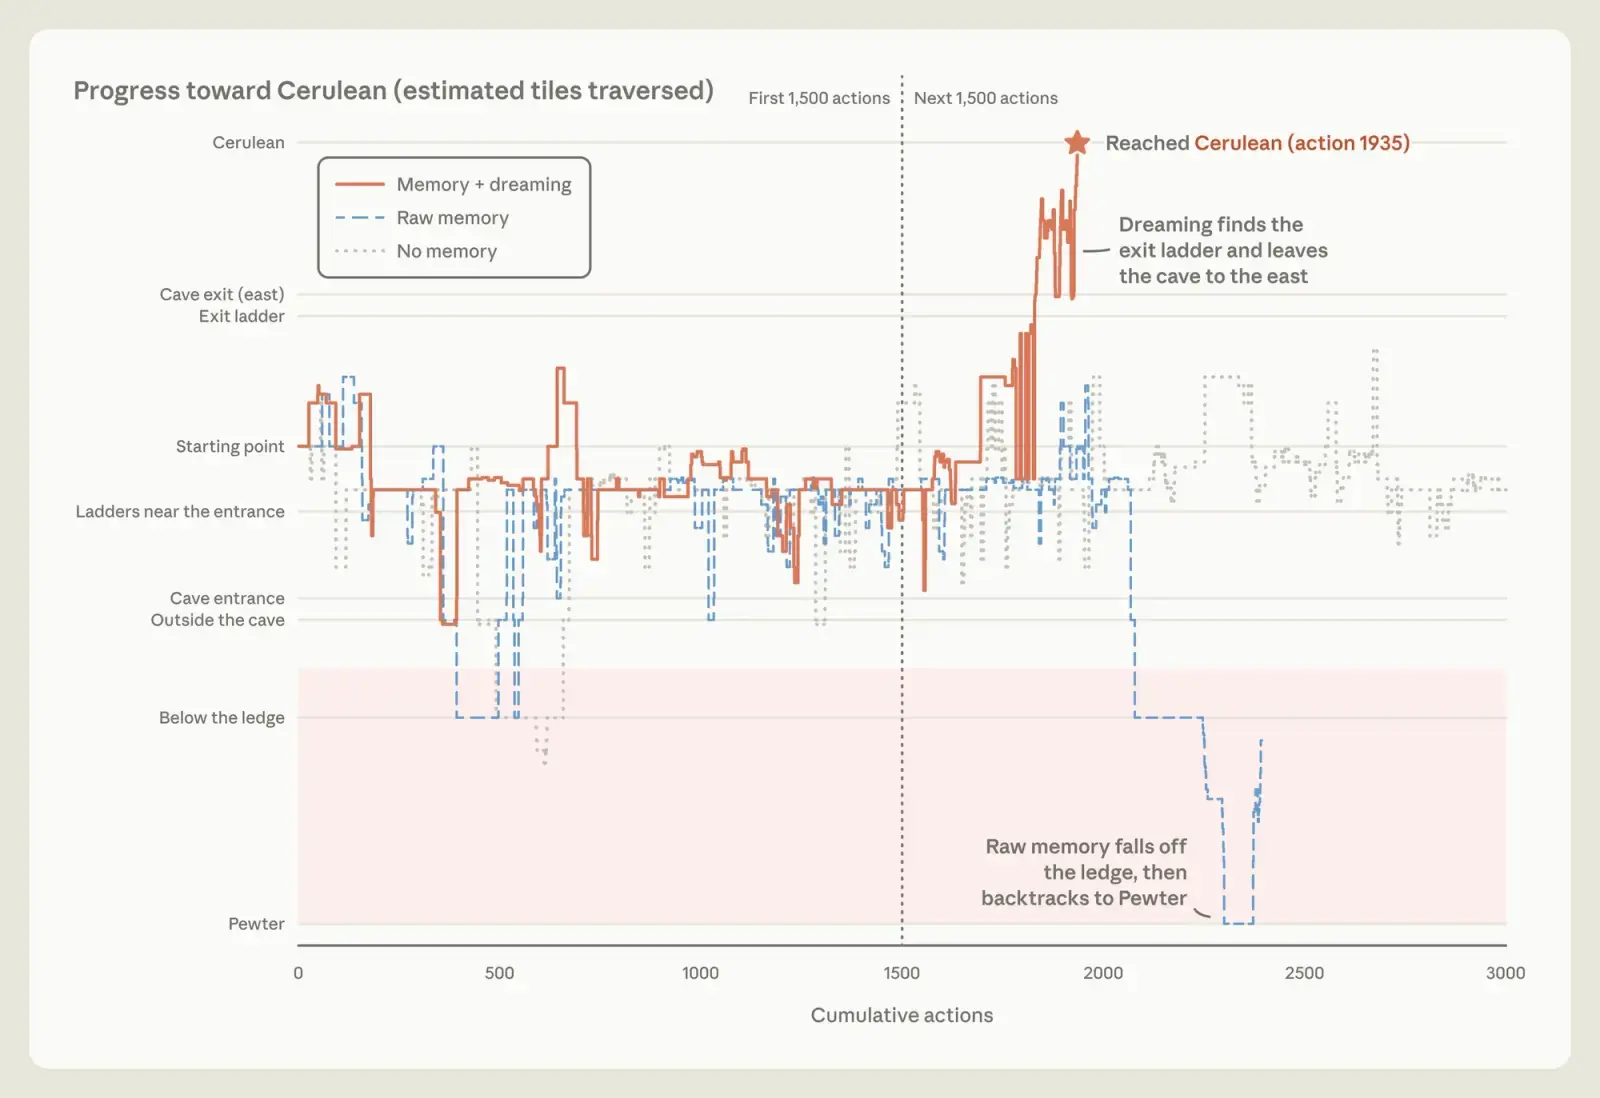
月見山入口附近有一段單向落差。模型把寶可夢中心的方位記錯,寫成在東邊。它走出中心時說山已經在後面,筆記還標成過關。實際上沒有。導航工具沒畫出落差,它又把走錯解釋成自己在正確的一側。
dreaming 拿這份錯誤筆記對照該次逐字稿,改寫方位。改正之後,它走回洞穴,並抵達下一座城華藍市。沒改正的那次,掉回原路 3 次,最後回到前一座城深灰市,整段沒有抵達華藍市。沒有記憶的那次也過不了這座山。
下圖的縱軸是估計走過的地圖格,不是精確座標。記憶加 dreaming 的那條線在累計第 1,935 個動作抵達華藍市。未校正記憶的線掉下落差後折返深灰市。沒有記憶的線沒有抵達。這是圖上的一次對照,不是多次實驗的統計結論,也不能拿來當可靠的遊戲走法。
維基要搭配搜尋才更好
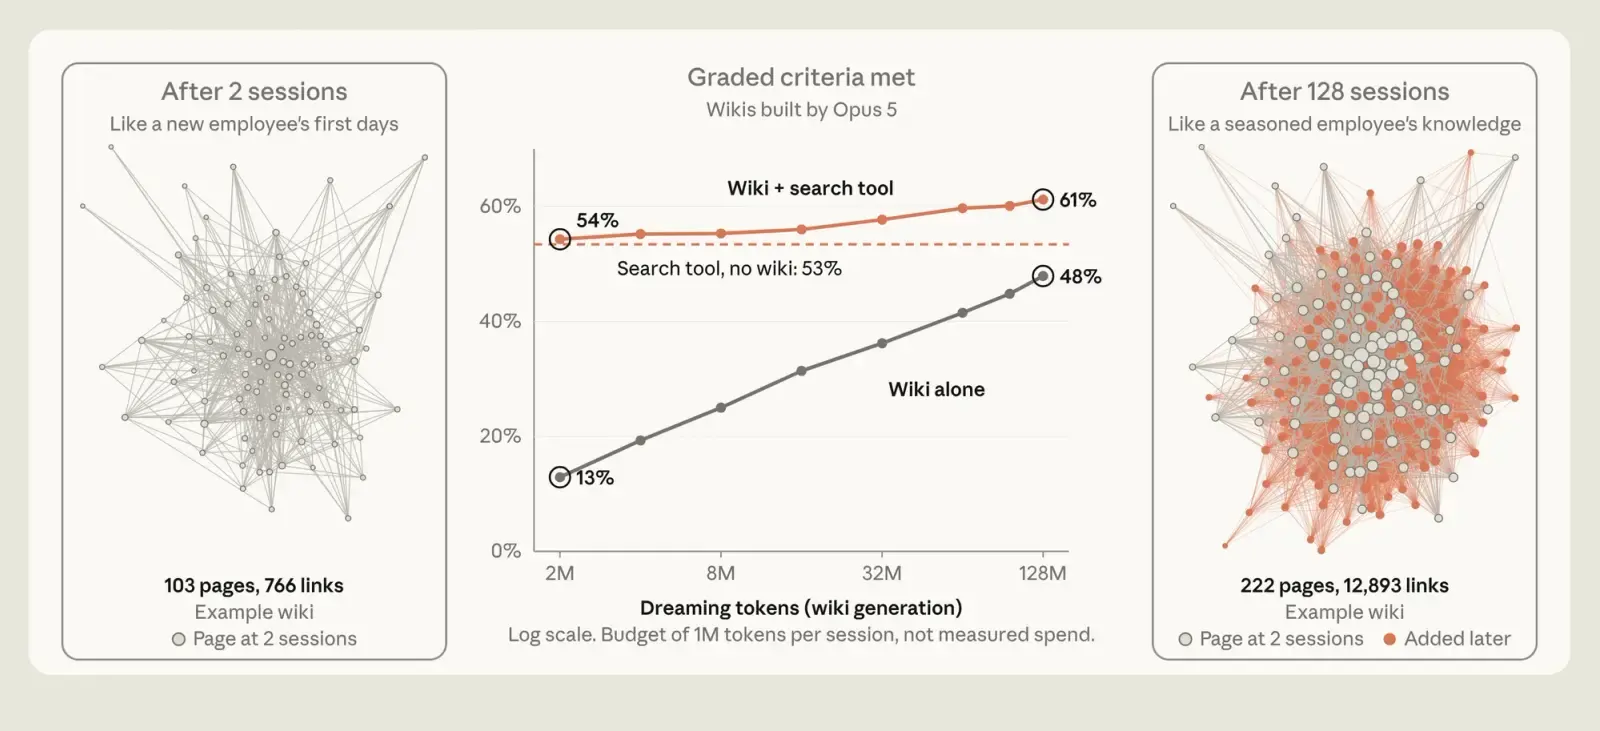
他們用 Stainless 約 35 萬份內部文件、大約 4.2 億 token,做 25 題。文中說 Stainless 是他們在五月收購的軟體公司。Opus 5 在多次 dreaming 裡寫維基、改連結、合併重複,再用原文核對。只靠維基時,符合評分標準的比例從 13% 升到 48%。只給搜尋、沒有維基,維持 53%。維基加搜尋從 54% 升到 61%。文中並寫,每題大約少用 2 萬 token。
圖的橫軸是 dreaming token,對數刻度,從 2M 到 128M。圖註寫每個 session 的預算是 1M token,不是實際花費。2 次之後的示例維基是 103 頁、766 條連結。128 次之後是 222 頁、12,893 條連結。
另一組合併案文件有 24 題,超過一半要跨文件。正文說,需要跨多份文件、或還要判斷與計算的項目(圖中的紅線與橘線),查維基是 87%,只搜尋是 73%。若題目用搜尋就能在單一文件找到,維基沒有明顯幫助。還有一次維基比原文還大:10 份文件、115 KB,對上 68 頁、255 條連結、203 KB,約 1.77 倍。整理如果沒有合併與刪減,就只是再抄一份。
頂層只留小型索引
會被每段新對話先載入的那一層必須短。載入不等於模型會照做。Claude Code 的自動記憶只載入 MEMORY.md 的前 200 行或 25 KB,當成索引,其餘要再去找。dreaming 的工作之一,是把細節往下移,上面只留連結。
整理自己的專案筆記時,可以照這個順序:保留原始逐字稿或來源,用它校正已經寫錯的筆記,把重複頁合併,頂層只留短索引。不要把研究裡的寶可夢推論當成遊戲規則,也不要把它看成已經上線給所有人的新介面。