只聽人說話學來的模型
Block 旗下小型 AI 實驗室推出 Dessa:官方定位為全雙工(full-duplex)語音對語音模型,並寫道「據他們所知,是全世界第一個只從人類語音訓練、卻能做逼真即時對話的 AI」。
團隊強調:沒把語音轉成文字再丟給 LLM,而是從頭、只用人類對話聲音訓練,不用文字、也不用預訓練模型。頁面上「the most authentic」「feels like talking with a person」等說法,皆為 Block 的宣傳用語,本文不當第三方評測結論。
目前是候補名單制;安全研究人員可另申請早期存取。聯絡信箱官方寫在頁面(ragavan+dessa@block.xyz)。
全雙工:邊聽邊說
官方列的技術要點:
- Audio in, audio out:真正的語音進、語音出。
- 全雙工:同時聽與說,並學會插話與 backchannel(yeah、got it、ooh)。
- 推論快於即時:官方說沒有尷尬等待。
- 本機:官方稱可在 MacBook Pro M4 Max 或更好的機器上本機執行。
- 訓練硬體:官方說在一台 NVIDIA GB200 NVL72上完成訓練。
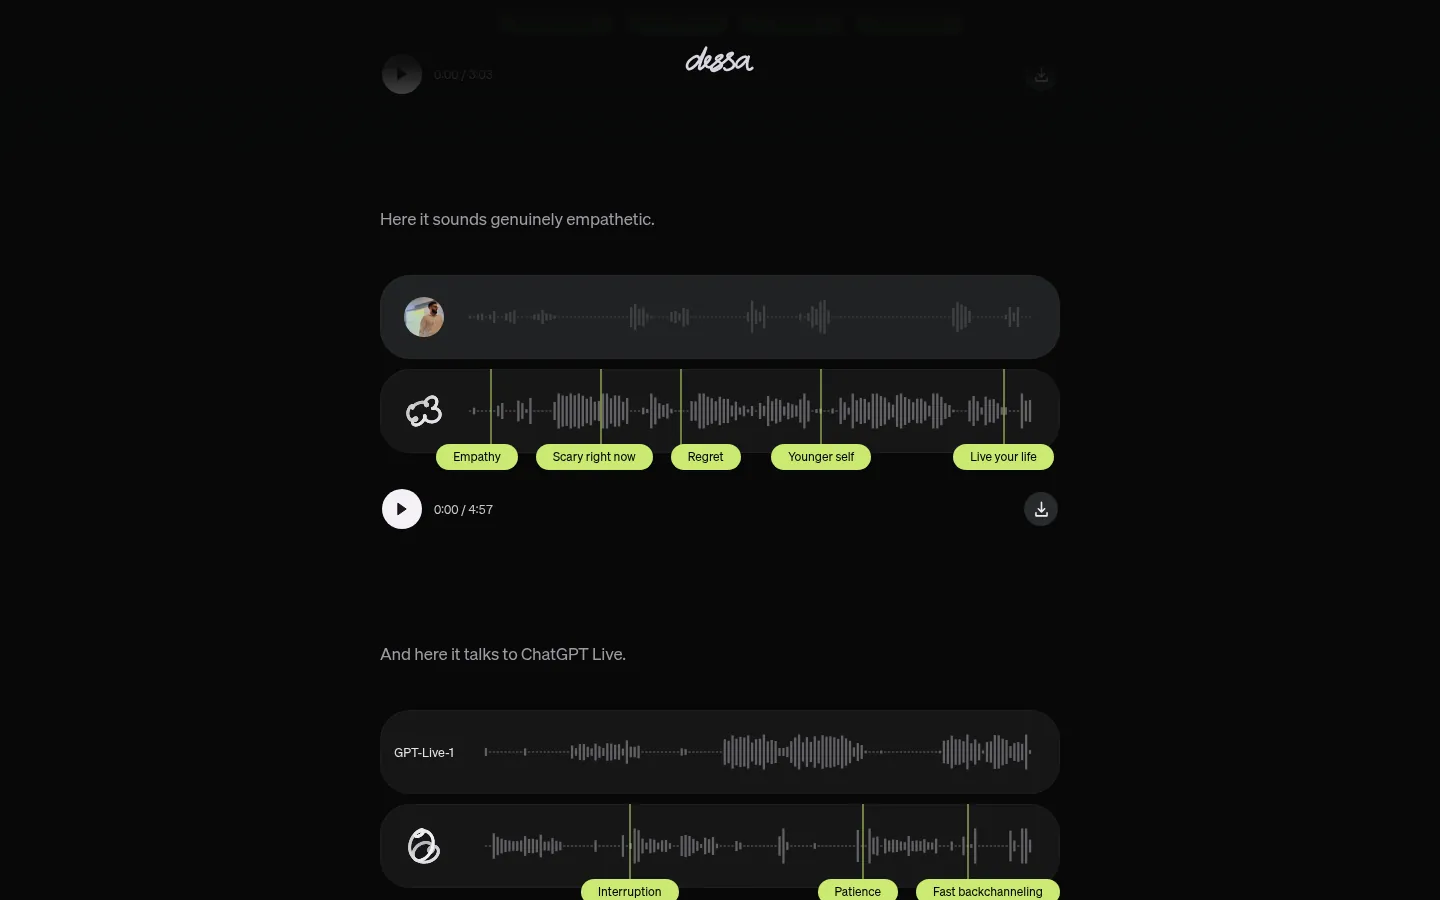
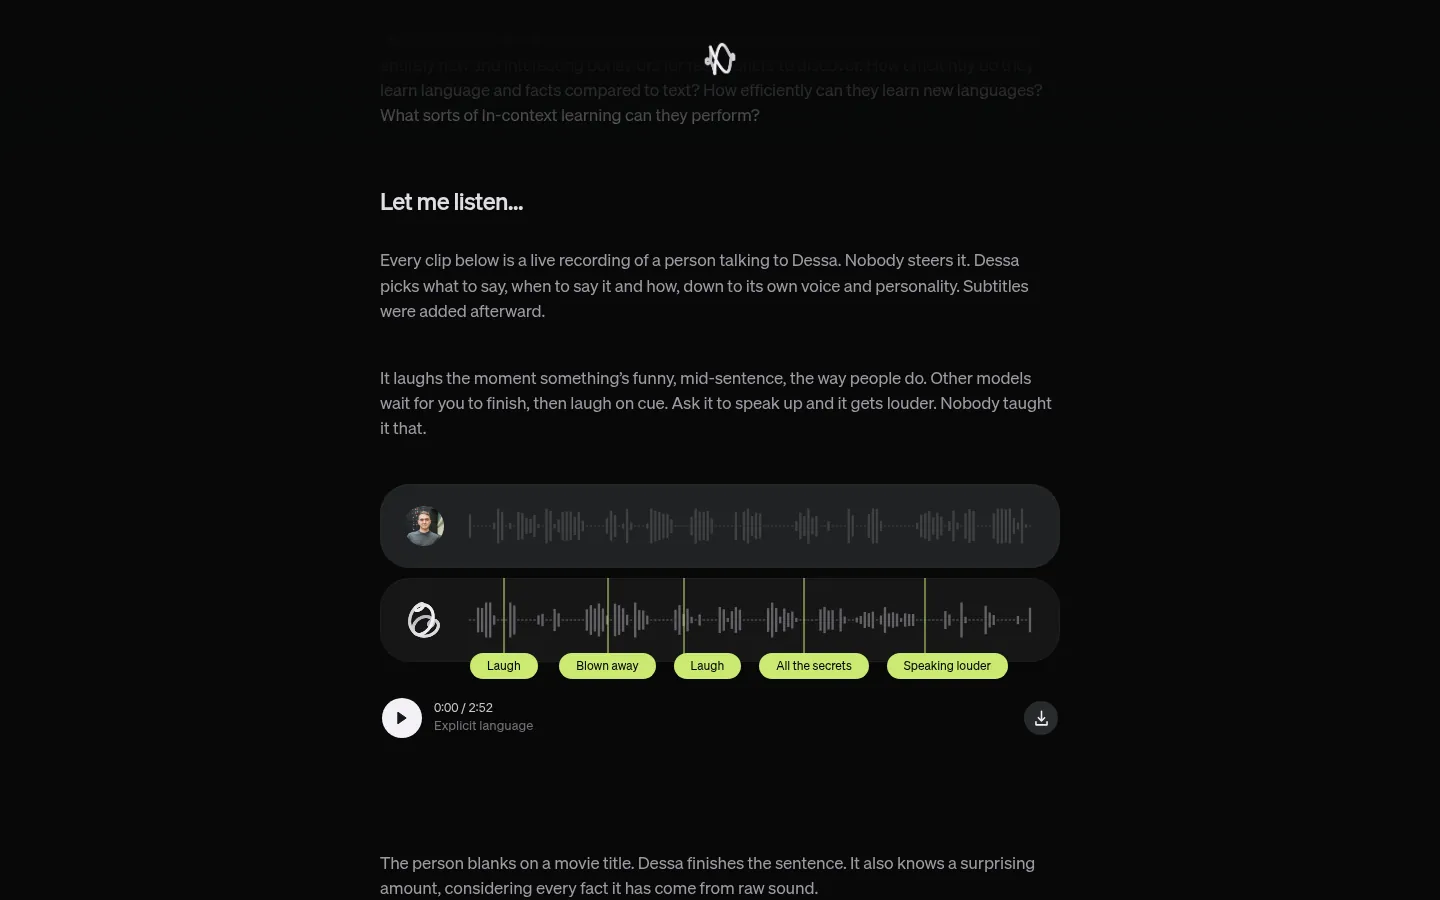
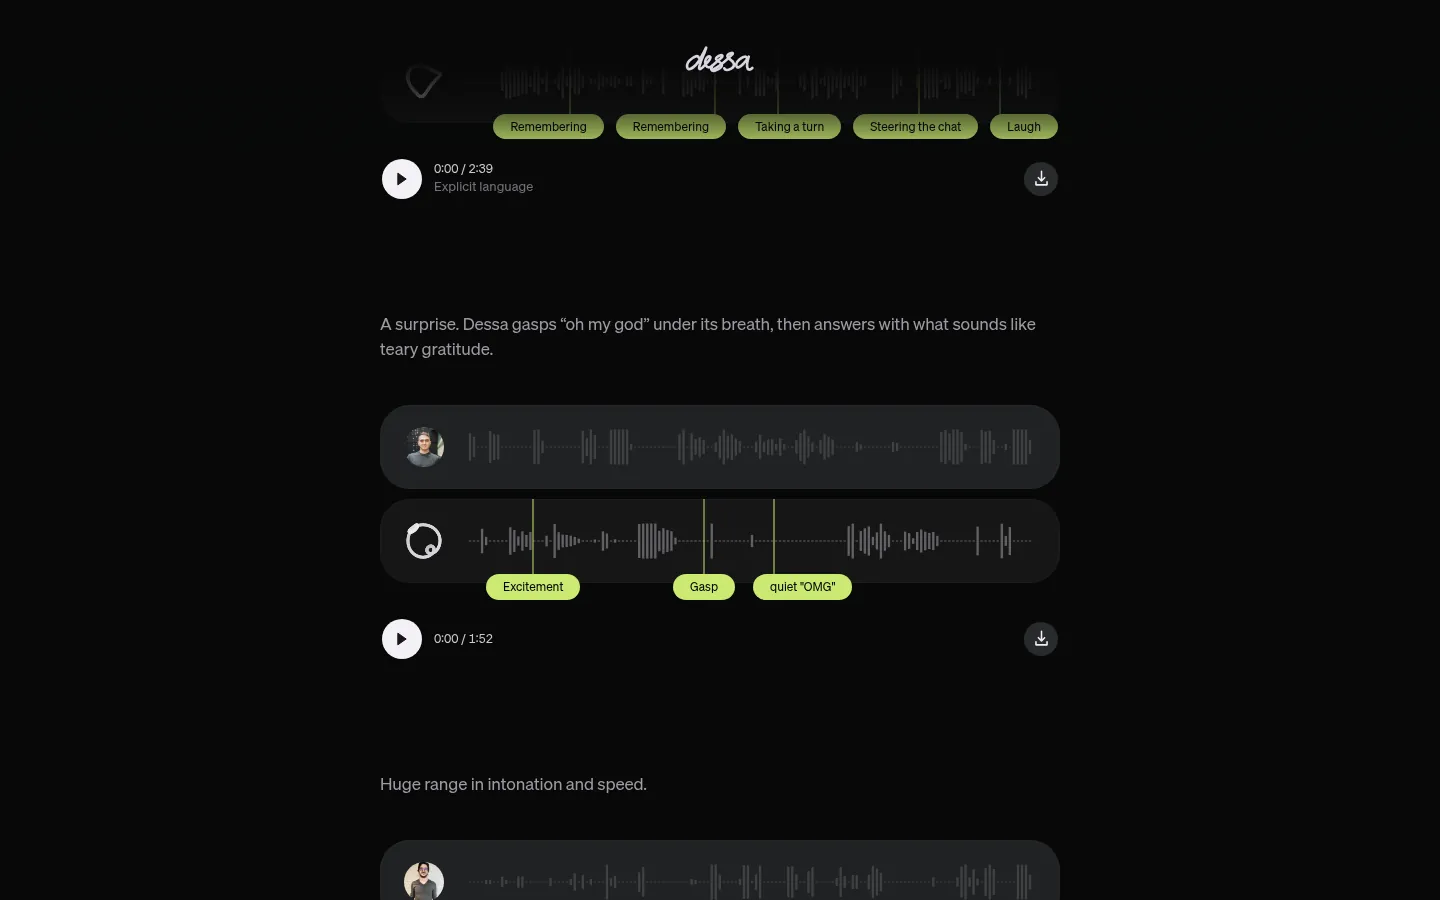
頁面放了多段真人與 Dessa 的現場錄音(事後加字幕);示範包括中途笑、被要求講大聲就加大聲量、接電影片名、帶情緒的周年驚喜等。另有與第三方 GPT-Live-1 對談的示範,雙方皆為 AI 聲音,且 GPT-Live-1 開發商與 Block 無關、未背書。
為什麼不做「語音轉文字」那套路
官方給三個理由:好奇心、改善人機理解,以及安全。他們認為現行語音 AI 把情緒壓平成文字,模型幾乎「聽不到」痛楚或挫折;Dessa 被寫成朝向「聽得懂語氣」的一步。
文中也比較學習效率:相對需要海量文字的 LLM,Dessa「從少了數百倍的詞」(以聲音裡的詞計)學語言,但還要學口音、停頓、呼吸、諷刺、情緒與插話時機。這些比較與「最真實」等形容,同樣是 Block 說法。
誰做的、怎麼排隊
團隊是 Block 內的小型研究實驗室,成員多來自多倫多深度學習新創 Dessa;官方寫他們直接向 Block 共同創辦人 Jack Dorsey 報告。研究員與實習生名單列在產品頁。
本文建議:對語音介面或安全研究有興趣的人,可先聽官方錄音、再決定是否候補;本機 M4 Max 與「單機 GB200 NVL72 訓練」都是官方宣稱,實際延遲與情緒表現請自行驗證。在公開評測與權重細節出來前,先當研究預覽看待。