NASC 規劃團隊的閘道
AWS 機器學習部落格在 2026 年 11 月 6 日說明一套做法:把 Model Context Protocol(MCP)伺服器放在代理與企業資料湖中間,當成集中閘道。作者服務的是 Amazon 北美分揀中心(North America Sort Center,NASC)的規劃團隊。那些團隊要用對話方式查看產能、人力與包裹流量。這是他們為 NASC 規劃團隊做的架構,不是一鍵就能套到任何公司的通用產品,文中也沒有提供可直接安裝的成品。
沒有共同閘道時,每個代理各自接資料庫與 API,各自寫 SQL、記結構、管連線。結構一改,就要逐個代理修。權限沒有單一稽核點。新上一張表,通常要寫工具、檢查查詢、再部署,文中說往往要花上數天。
他們把系統分成四層:用戶端、MCP 伺服器、工具,以及知識庫更新。中繼資料目錄記下結構說明、欄位語意與表之間的關係。代理在查詢當下才讀目錄,所以換結構不必把表寫死在程式裡,也不必為此重新部署。下圖是文章的 Figure 1,請求從用戶端應用走到資料層。
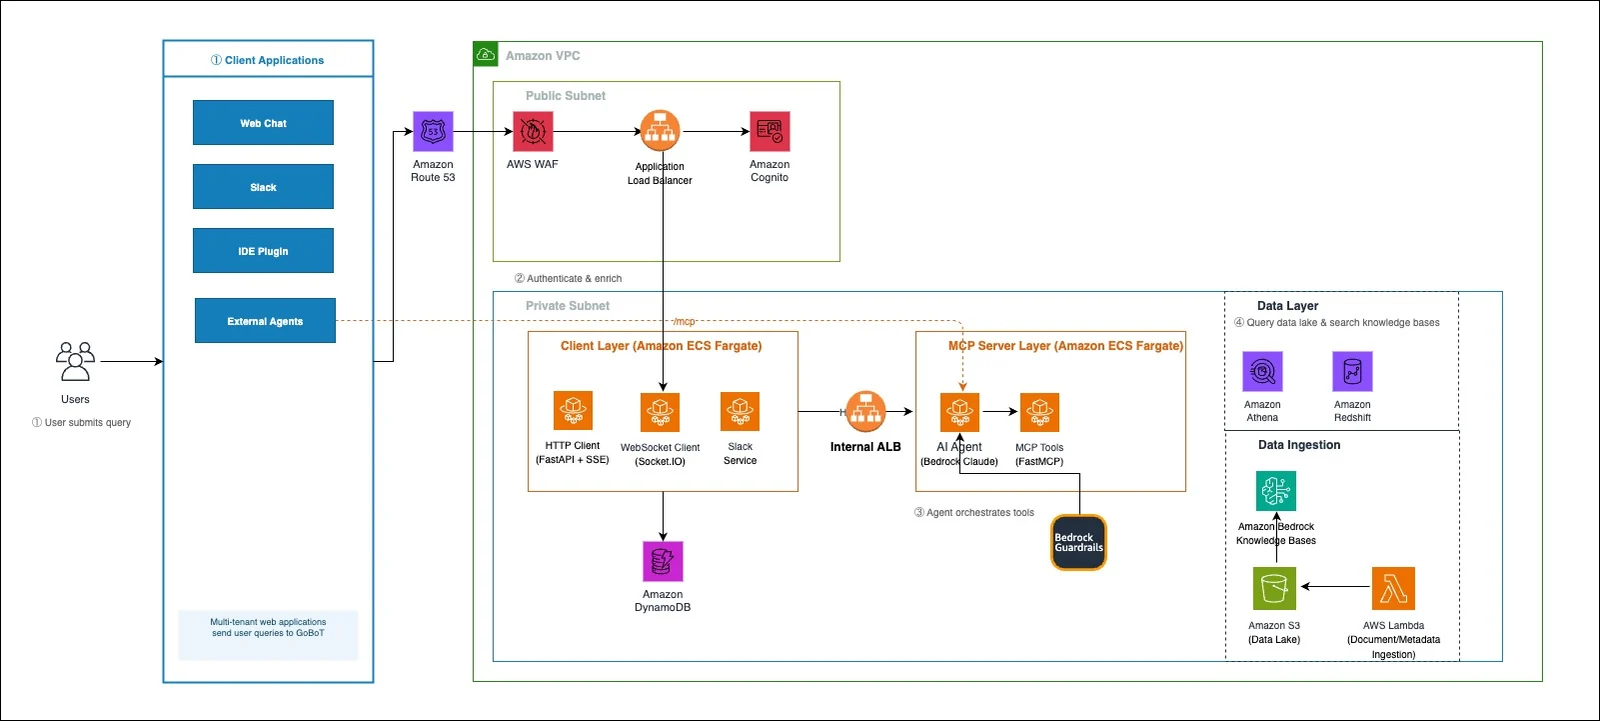
圖中的用戶端層與 MCP 伺服器層都跑在 Amazon ECS Fargate。對話狀態放在 DynamoDB。公開子網有 HTTPS 負載平衡器與 AWS WAF,身分由 Amazon Cognito 驗證。MCP 伺服器在私有子網,前面是內部負載平衡器,網際網路不能直接碰到它。伺服器裡的代理用 Amazon Bedrock 編排工具,工具以 FastMCP 註冊。每一次模型互動都套用 Amazon Bedrock Guardrails。資料層用 Amazon Athena 與 Amazon Redshift 查資料湖,用 Bedrock Knowledge Bases 做語意搜尋。進 S3 與知識庫的資料由 Lambda 處理。
新資料集只交一份 JSON
上架新資料集,要的是一份描述資料表的 JSON,以及可選的情境對應,不是為每張表再寫一套整合程式。檔案記下結構、業務說明與欄位語意。管線用 Amazon Titan Text Embeddings 做向量,寫進 Bedrock Knowledge Bases。索引完成後,已連上的代理就能發現這張表,不必手動重建索引,也不必重啟伺服器。
文中的範例檔包含資料庫服務名稱、資料庫、資料表、業務描述、欄位說明與示例值,也有載入方式、更新頻率與資料表大小等欄位。那個範例把資料表大小寫成約 21 億列。這是檔案格式的例子,不是 NASC 某張正式表的測量結果。業務描述可以帶引擎提示,例如對時間欄位比較時要用 date() 包住字串。示例值則讓代理知道篩選條件長什麼樣子,而不是靠欄位名稱猜。
情境對應可以把一次查詢收斂到相關的表。文中舉 package_data、labor_planning 這類項目,各自列出說明與資料表。沒有指定情境時,代理會搜尋已索引的全部表。對應可以事後再加,不必改中繼資料檔本身。
測試裡的 15 至 20 秒
文中寫,在他們的測試裡,用情境對應把範圍縮小之後,端到端互動的延遲落在 15 至 20 秒。後段的示例問句,查上個月金額最高的 10 筆訂單,走完同一條流程,也是在測試中於 15 至 20 秒內完成。這是該文的測試範圍,不是對外的延遲保證,也沒有寫成所有資料量或所有區域都一樣。
同一條編排也可以在一輪裡同時查結構化與非結構化來源。文中的例子是:既要第四季退貨率,也要產品團隊對原因的分析。代理會對 Athena 下查詢,並對知識庫做文件搜尋,再合成一次回答。
多個用戶端共用工具
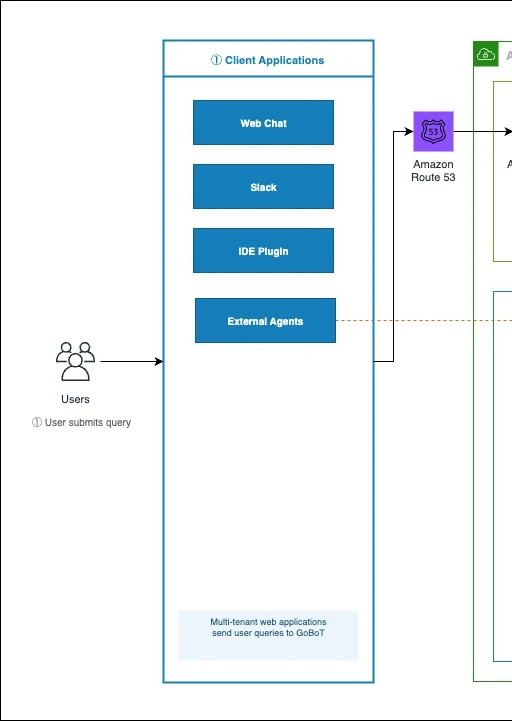
下圖是同一張架構圖的左側。用戶端可以是網頁對話、Slack、IDE 外掛,或外部代理。標準的 /mcp 端點接受相容 MCP 的用戶端。文中舉 Amazon Q Developer 與 IDE 擴充功能為例,它們可以發現並呼叫同一組工具。新代理要做的是指向這個端點,而不是再複製一套權限。
已註冊的工具有三類。
| 工具 | 後端 | 用途 |
|---|---|---|
| SQL 查詢 | Amazon Athena、Amazon Redshift | 對已設定的資料湖資料集與 Redshift 下 SQL |
| 文件與中繼資料搜尋 | Amazon Bedrock Knowledge Bases | 搜尋內部文件、資料表中繼資料與團隊 wiki |
| 政策搜尋 | Amazon Bedrock Knowledge Bases | 搜尋作業政策與標準程序 |
Athena 是進資料湖的主要介面。代理先查中繼資料目錄,再經 Bedrock 產生 SQL,依 Athena 的相容性檢查並自動修正,然後才執行。結果回到編排代理,整理成自然語言。
Guardrails 用在所有大型語言模型互動,用來過濾有害內容、做依據檢查,並協助擋住提示注入。因為加在 MCP 伺服器這一層,接上來的代理共用同一套內容安全政策。Athena 工具只接受 SELECT,寫入會在碰到資料湖之前被拒絕。工具呼叫以結構化 JSON 寫進 Amazon CloudWatch,作為各代理、各應用的單一稽核點。文中說,這套架構可用於同時提供 Amazon Bedrock 與 Bedrock Knowledge Bases 的 AWS 區域。
各層的擴展方式不同。
| 層 | 擴展方式 | 觸發 |
|---|---|---|
| 用戶端(ECS Fargate) | ECS 服務自動擴展 | CPU 使用率,門檻 50% |
| MCP 伺服器(ECS Fargate) | ECS 服務自動擴展 | CPU 或記憶體使用率 |
| Athena | 無伺服器,自動 | 查詢並行數 |
| Amazon Bedrock | 受管服務擴展 | 推論請求 |
Fargate 不需要自己管 EC2。Athena 與 Bedrock 會跟著負載擴展。文中的結論是:工具層與代理層分開之後,代理可以常換,資料存取的方式則可以留得比任何一個代理實作更久。
文章末段寫了兩個尚未完成的方向,不是現成功能。一是資料表擁有者可以按權限群組標出敏感欄,讓代理在產生 SQL 時自動排除。二是查詢失敗或信心低時,系統記下失敗模式,並建議怎麼改欄位描述或查詢提示。