什麼是 Weight-Space Programming
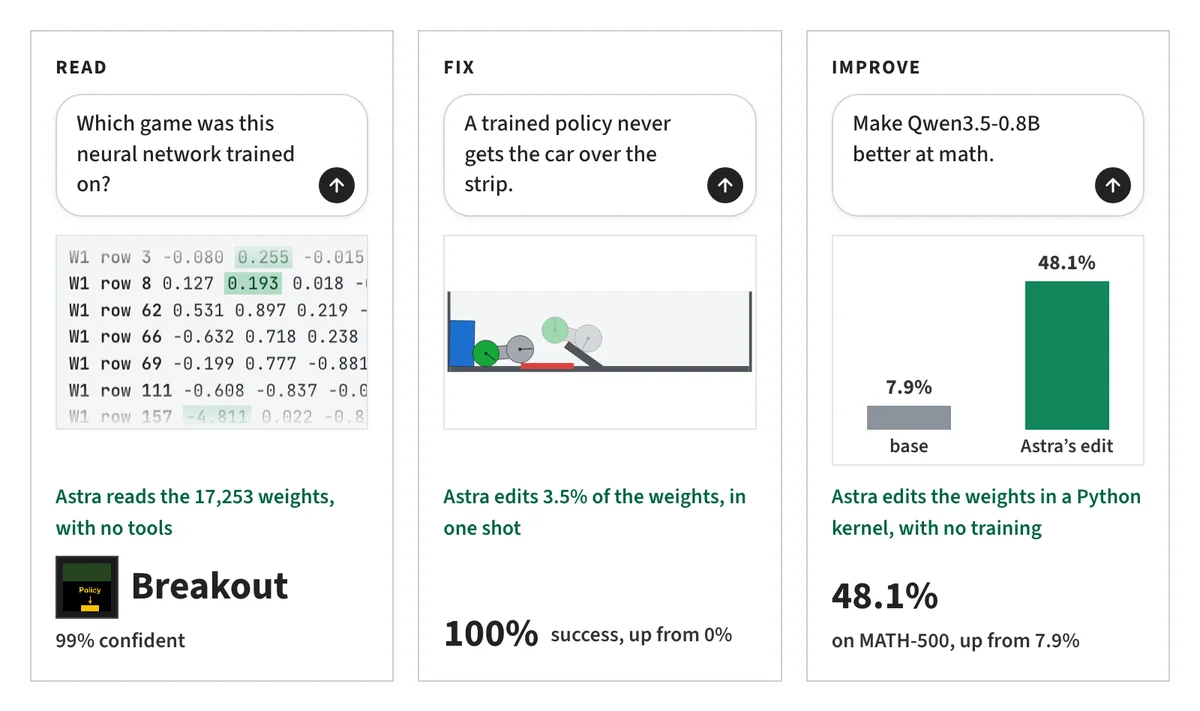
MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab 於 2026 年 11 月 2 日發表研究。作者主張:前沿 LLM 已能直接閱讀與寫入神經網路權重(不是透過梯度下降),他們把這種做法稱為 Weight-Space Programming。
本文只整理作者公開的能力宣稱與數字,不作外推。
只看權重就能讀出行為
作者以 GPT-6 Astra 做了多組小實驗,例如:
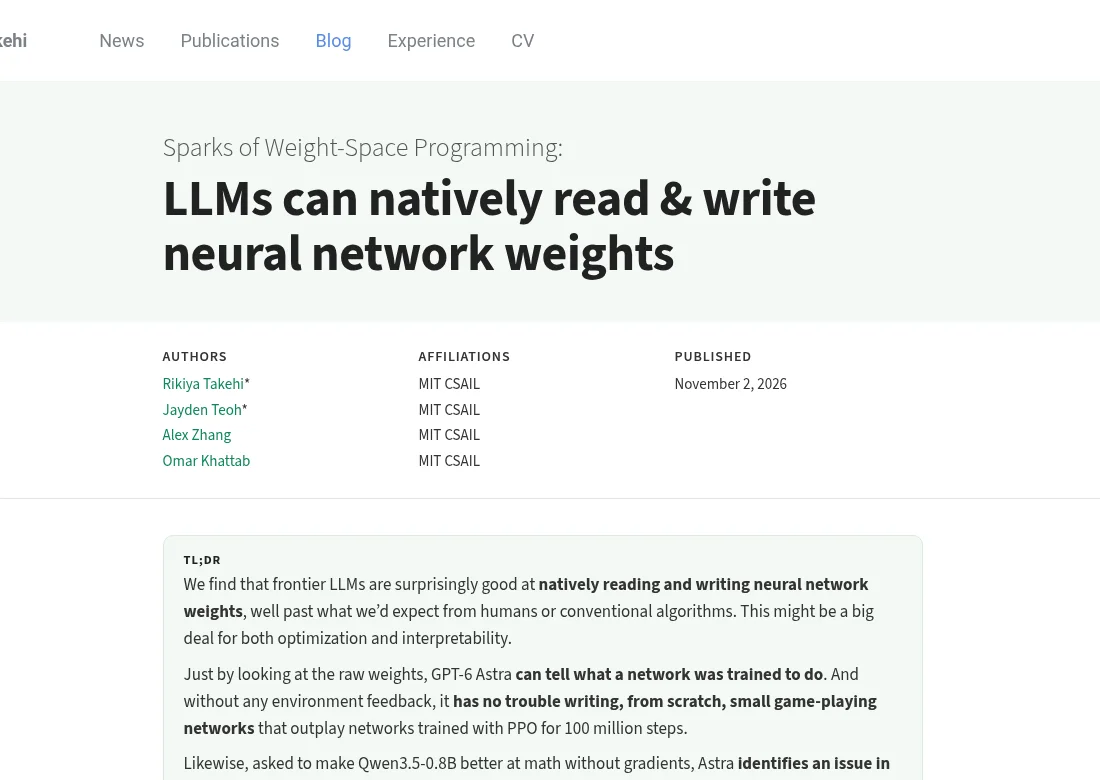
- 四個結構相同、用 PPO 訓練的遊戲策略網路(Breakout、Pong、Pac-Man、Freeway),Astra 只看 17,253 個權重就能說出對應遊戲
- 三個擴散模型分別學圓、三角、正方形,Astra 能從權重辨認形狀
- 三個約 720 萬參數的小型語言模型,去掉輸入/輸出層後,Astra 仍能指出訓練語料是 Python、羅馬拼音日文或英文,並找出複製頭(copying/induction head)
作者強調:這些結果是早期跡象,仍受上下文長度與工具限制。
從零寫權重,也能修失敗策略
寫權重方面,作者報告:
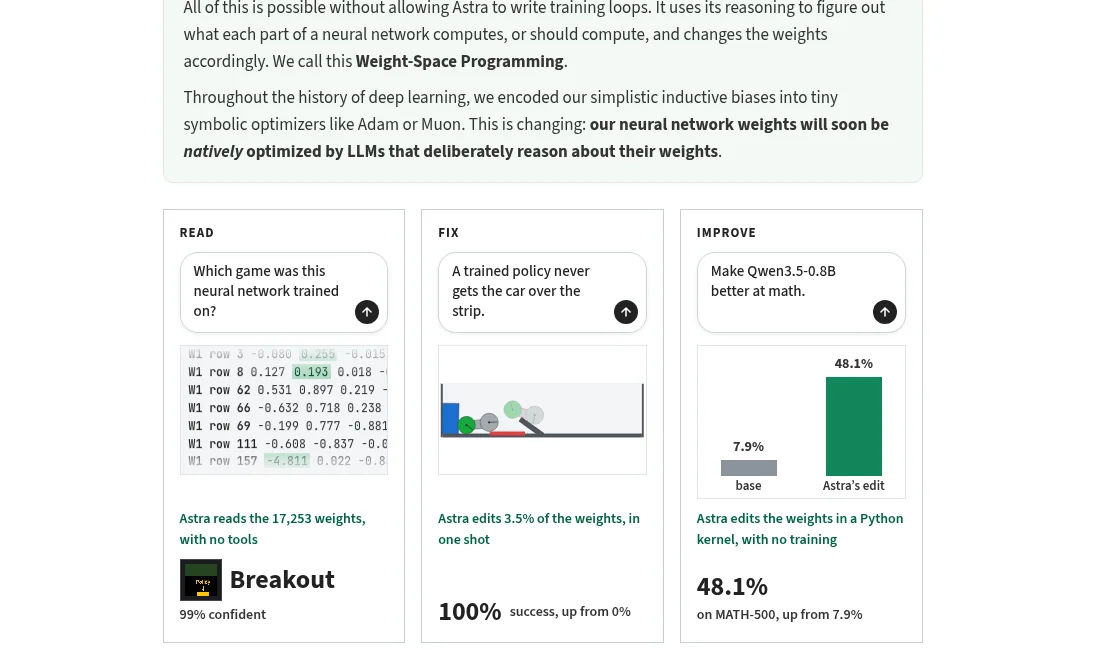
- 修一台卡車上坡失敗的 PPO 網路:一次編輯約 3.5% 權重後,在 1,024 局全部成功(原本 0%)
- MinAtar 三款遊戲:Astra 零樣本寫出的網路,分數高於 PPO 訓練 1 億步;對 Breakout,還遠高於訓練 5 億步的 PPO(作者表:Astra 517.4 vs PPO 100M 15.8/500M 25.3)
- 約 148 萬參數的 9×9 圍棋網路:允許 50 次前向後,可勝過同等規模、訓練 2,000 萬局的 PPO
改 Qwen:0.016% 權重換來大幅提升
較接近實務的案例是 Qwen3.5-0.8B:
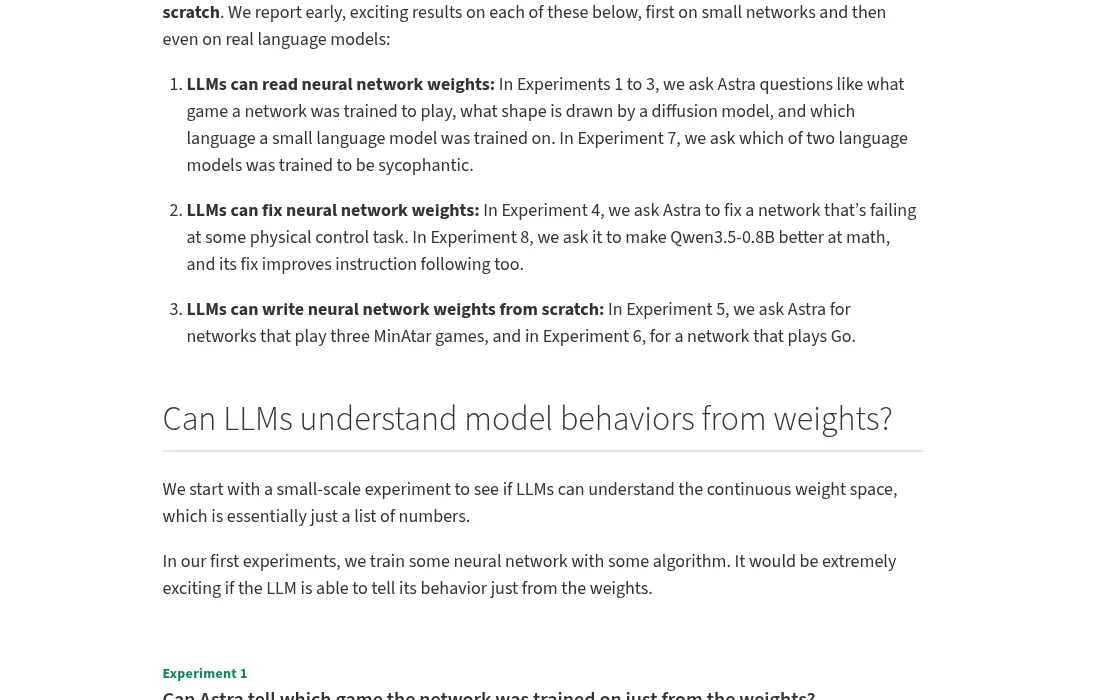
- 作者讓 Astra 在 Python kernel 裡編輯權重,禁止梯度訓練
- Astra 找到第 15、19 層 MLP 造成的思考迴圈,只改 131,072 個權重(約 0.016%)
- 在 50 次前向預算下:MATH-500 從 7.9% 升至 48.1%,GSM8K 從 13.8% 至 67.1%,IFEval 從 21.0% 至 62.3%
- 對較少迴圈的 Gemma 3 270M,作者表示幾乎無法靠同樣手法提升數學能力
作者的提醒:這是「拿掉障礙」而非「憑空教出新能力」。完整日誌已開源,編輯後的 Qwen 權重也在 Hugging Face。