
和昨日摘要差在哪
站內昨日已整理原研究宣稱(見 LLM 能直接讀寫神經網路權重)。Matthew Honnibal(spaCy 作者)於 2026 年 11 月 3 日另文主張:那篇貼文的敘事方式容易誤導:標題與摘要強調「Just by looking at the raw weights」,但最吸睛的 Qwen 數學結果並不是那個設定。
本文是批判/釐清,不是重發論文摘要;數字引自 Honnibal 整理表與原文轉述,我們沒有獨立重跑實驗。
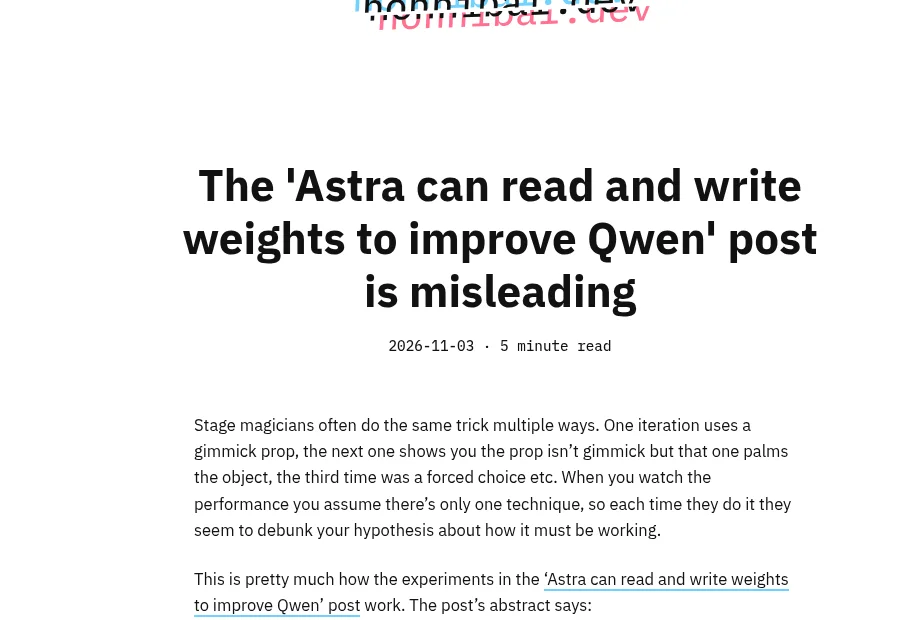
表格拆開十組實驗
Honnibal 用一張表把實驗拆開,欄位包含:是否讀 raw weights、是否寫權重、是否用 Python、是否跑網路、結果。
【事實|Honnibal 表】
| # | 重點 | 規模(約) | 讀 raw weights? | Python? | 跑網路? |
|---|---|---|---|---|---|
| 1 | 猜 PPO 遊戲 | 17K | 是 | 否 | 否 |
| 2 | 猜擴散形狀 | 24K | 是 | 否 | 否 |
| 4 | 修卡住的車策略 | 172K | 是 | 否 | 否¹ |
| 3、5 至 7 等 | 語言模型/從零寫網路等 | 更大 | 多為否 | 多為是 | 視組別 |
| 8 | 修 Qwen3.5 數學 | 800M | 否 | 是 | 是(至 50 次) |
| 8b | 同法用於 Gemma 3 270M | 270M | 否 | 是 | 是(至 50 次) |
¹ 作者註:給了一段失敗軌跡紀錄。
表中 Qwen 列結果為 MATH-500 7.9% 至 48.1%(Honnibal 轉述原貼)。
純讀權重只在極小網路
Honnibal 的核心句子是:
「只看 raw weights」設定(上下文裡是 raw floats、無工具、不跑網路)只出現在實驗 1、2、4,網路規模約 17K 至 172K 權重。
凡牽涉真實語言模型的實驗都用了 Python;headline 的 Qwen 結果還可以對練習題跑最多 50 批前向。作者認為:這比較像「提示模型去設計並執行人類 ML 工程師也會寫的分析/改權重程式」,不該和「只看浮點權重就讀懂行為」寫成同一招魔術。
兩題該分開看
讀原貼或站內摘要時,建議心裡拆成兩題:
- 無工具、只看權重:小網路遊戲/形狀辨識,這條線 Willison 也用筆電上的 Qwen 3.8 27B 複現過(見同日文 筆電跑 Qwen 也能解讀模型權重)
- 有程式、可跑模型:Qwen 數學大躍進落在這條;不要自動推論「Frontier LLM 只看權重就能改好大模型」
Honnibal 並未否認模型變強,他反對的是把不同技術捆成一個聽起來像統一能力的故事。