為什麼形式驗證突然比較可行
Anthropic Frontier Red Team 在 2026 年 10 月 22 日發表研究:與 Theorem 合作,展示大型語言模型能大規模產出形式證明,讓「被證明過的安全保證」比較有機會進入一般軟體流程。
形式驗證把程式變成數學模型,再證明它永遠遵守一組規則;失敗處往往指向可能的 bug。過去證明成本極高(文中舉 seL4:實作約 2 人年、驗證約 20 人年),多半只用於航電等關鍵系統。現在 Claude 能較自主地為真實軟體寫證明。
官方說這是他們所知首次大規模用 AI,在組合語言(assembly)層級對正式上線軟體做形式驗證。
123 個函式庫、RISC-V、約 1.8 億行 Rocq
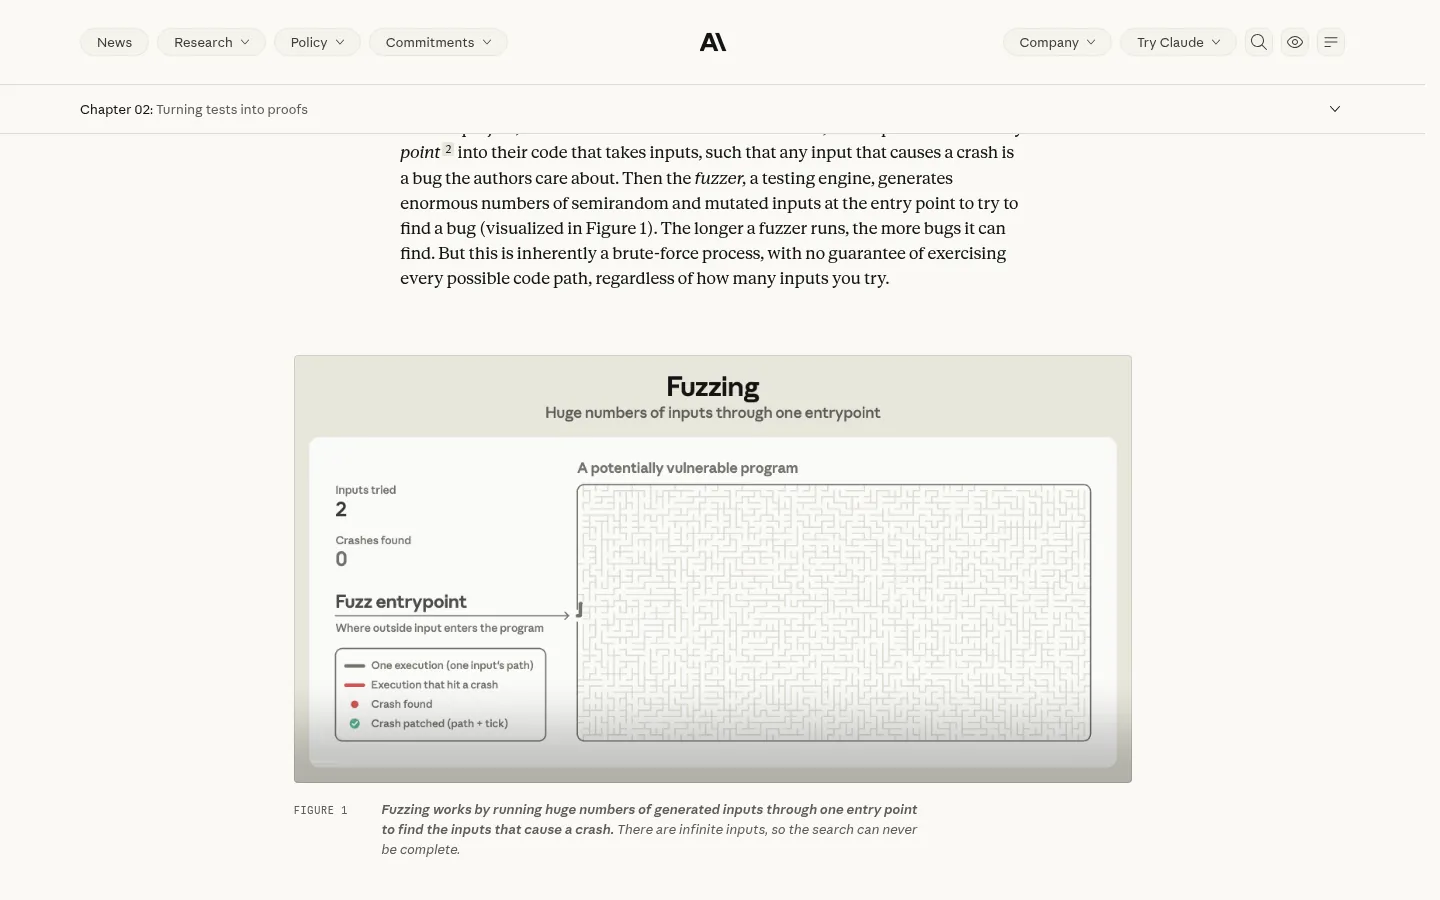
他們把 Google OSS-Fuzz 裡開發者寫的 fuzz 測試,轉成「這個測試對任何小於 64 MB 的輸入都不會崩潰」這類規格,並在編譯成 RISC-V、跑在 Linux 上的語意模型裡證明。
關鍵數字(皆官方自報):
| 項目 | 數字 |
|---|---|
| 成功證明無崩潰的入口點 | 239 個 |
| 涵蓋開源函式庫 | 123 個 |
| Rocq 證明總量約 | 1.8 億 行 |
| 典型單份證明約 | 60 萬 行 |
| 二進位中位數指令數約 | 1.8 萬 條 RISC-V 指令 |
假設條件包括:單執行緒靜態二進位、固定記憶體預算、RISC-V CPU、Linux OS。證明由 Rocq kernel 檢查;開發者主要需信任 RISC-V/Linux 語意模型、定理陳述本身,以及 Rocq 檢查器。Anthropic 會公開部分證明與語意;Theorem 也提供幫其他專案跑同一管線,並釋出 Claude skill。
證明過程中找到的長年漏網 bug
嘗試證明時,Claude 發現並修補了許多 fuzz 不太容易碰到的問題,例如:約 20 MB、特定稀有版面才觸發的解壓縮器計數器下溢與越界寫入;需要約 64 MB 輸入與逾 2 GB 記憶體的影像解碼越界讀;跨兩個檔案 handle 的特定呼叫序;以及在 libexpat 重新發現 CVE-2026-56132(需深度巢狀輸入)。也有從不崩潰的邏輯 bug,例如限制可載入檔案的功能並非總是生效。
其他案例研究包括:為 RFC 1950(zlib)寫規格並在 Linux 核心實作的 x86 二進位上證明;用 Verus 證明 Rust 寫的 Python 子集解譯器符合學術論文中的 CPython 語意,並以逾 170 萬 個隨機 Python 程式比對,99.95% 行為一致。文中也提到在廣泛使用的 PDF 閱讀器驗證過程中,一週找到的安全 bug 數量約等於平常一年通報量。
還不是「零漏洞」貼紙
官方自己列了限制:「形式驗證通過」≠ 真實世界零 bug。規格或機器語意若與實機不符,漏洞仍可能存在。目前證明多半針對單執行緒、靜態連結 musl 的 RISC-V 二進位,而多數人實際跑的是 x86/ARM 與動態 glibc。ASan 也偵測不到所有記憶體安全問題;未驗證的入口點與呼叫端誤用仍可能出事。
效率方面:在 36 個小型驗證任務上,Opus 5.5 證明其中一半時,比 Opus 5 大約少用 40% token;代理之間共用證明工作區時約再少 17% token。這些是 Anthropic 實驗數據。
本文建議:維護 C/C++ 關鍵函式庫的人,可先看 Anthropic/Theorem 公開的證明與 skill,挑一個已有 OSS-Fuzz 入口的專案試跑;把「規格假設」寫進威脅模型,不要把證明標題直接貼成行銷上的「絕對安全」。