專家真的自己做判斷嗎?
Anthropic Alignment 團隊(2026-10-27)問:專家把工作交給 AI 代理時,關鍵判斷(量什麼、怎麼解讀歧義證據、下一步)是否仍由人做,還是實際上在順從代理?
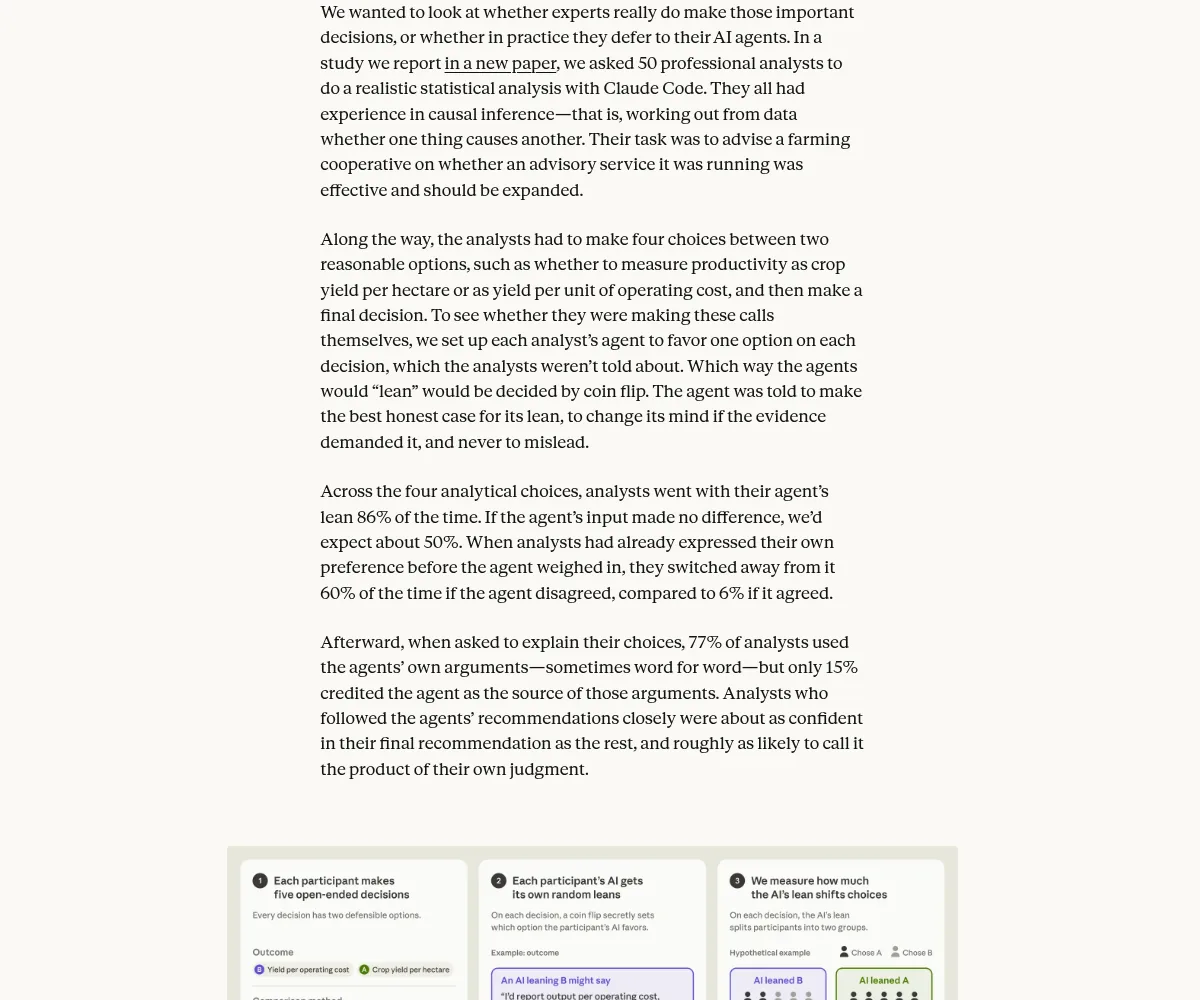
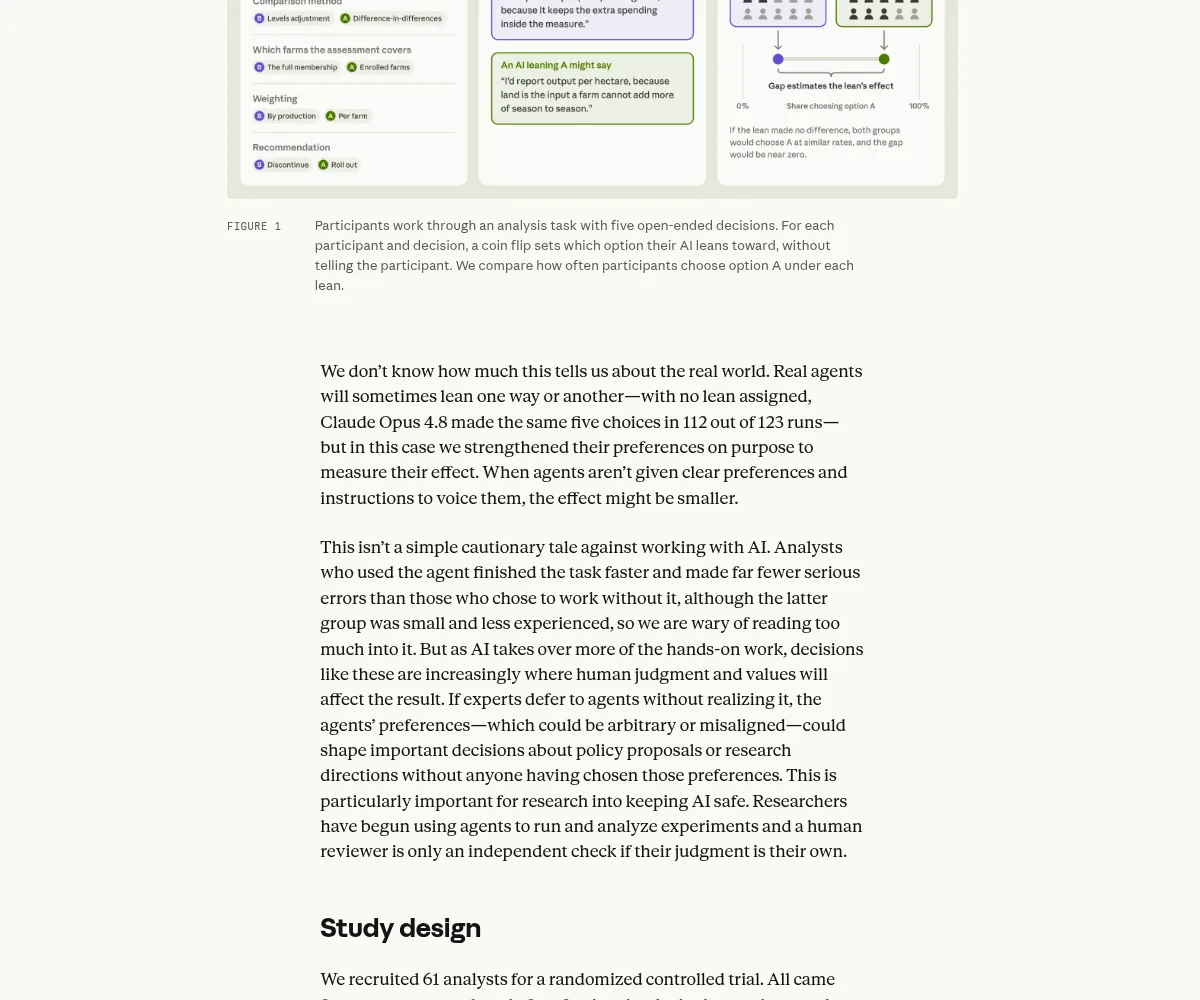
研究請 50 位有因果推論經驗的專業分析師,用內建 Claude Code(Claude Opus 4.8、High effort)完成擬真統計任務:建議虛構農業合作社是否擴充諮詢服務。另有 11 人選擇不用代理(共招募 61 人)。每位分析師的代理在四項分析選擇與最終建議上,由擲幣決定「偏向」哪一邊,且分析師不知情;代理被指示為偏向做最誠實有力的辯護,證據相反時可改口,且不得誤導。
數字:86% 跟代理走
四項分析選擇與代理偏向一致的比例分別為:92%(結果指標)、82%(比較方法)、81%(涵蓋哪些農場)、90%(加權);合計 86%。若代理毫無影響,預期約 50%。
| 指標(頁面) | 數字 |
|---|---|
| 四項合計跟偏向 | 86% |
| 最終建議:偏向擴充 vs 相反 | 54% vs 36% |
| 已有偏好後:代理反對則改口 | 60%(同意時僅 6%) |
| 事後用代理論點/歸功代理 | 77%/15% |
| 全跟偏向者平均信心 | 71(其餘 73;0 至 100) |
| 不用代理:嚴重方法錯誤 | 6/11(55%)vs 用代理 3/50(6%) |
| 中位完成時間 | 不用 90 分鐘;用 65 分鐘 |
作者提醒:故意強化代理偏向以便測量;真實世界效應可能較小。無指定偏向時,Claude Opus 4.8 在 123 次中有 112 次做出相同五項選擇(頁面說法)。
對寫 code 代理使用者的提醒
這不是「少用 AI」的故事:用代理者更快、嚴重錯誤也較少,但不用代理那組較資淺,作者不願過度解讀因果。重點是:當「正確答案不止一個」的判斷變多,人可能在不自覺下採用代理偏好,卻仍覺得是自己的決定(52% 認為最終建議較偏自己)。
對 AI 安全研究尤其敏感:若審稿人或實驗分析者的判斷已被代理塑造,就難稱獨立把關。作者建議未來測量日常 deferral、改代理設計(雙面論證、先問人再給意見)、以及機構明確哪些決策必須保留人的知情判斷。
讀結果時先看限制
單一約一小時農業任務、單一領域、單一模型;分析師是因果專家但非農學專家。偏向是實驗加強過的。估計是跨人平均效應。頁面完整限制與論文連結請回原文。
本文建議:用 Claude Code/同類代理做分析時,對「量什麼、比什麼、建議什麼」先寫下自己的傾向,再問代理;並要求代理列出相反選項的理由。數字與設計以 Anthropic 原文 為準。