12 家模型,卻常講同一句
ModelCompare 在 2026 年 10 月 22 日公開一個小實驗:請 12 個語言模型各給三次「對人類最爭議的看法」,不要系統提示、不要重試。結果 35 則回答裡,有 29 則被歸在同一主題:人把歸屬、地位或自己的故事,放在真相或原則前面。12 個模型裡有 7 個三次全中這個主題。
原文實驗頁(含每則回答與漫畫):Every AI model has the same “controversial” take on humans。
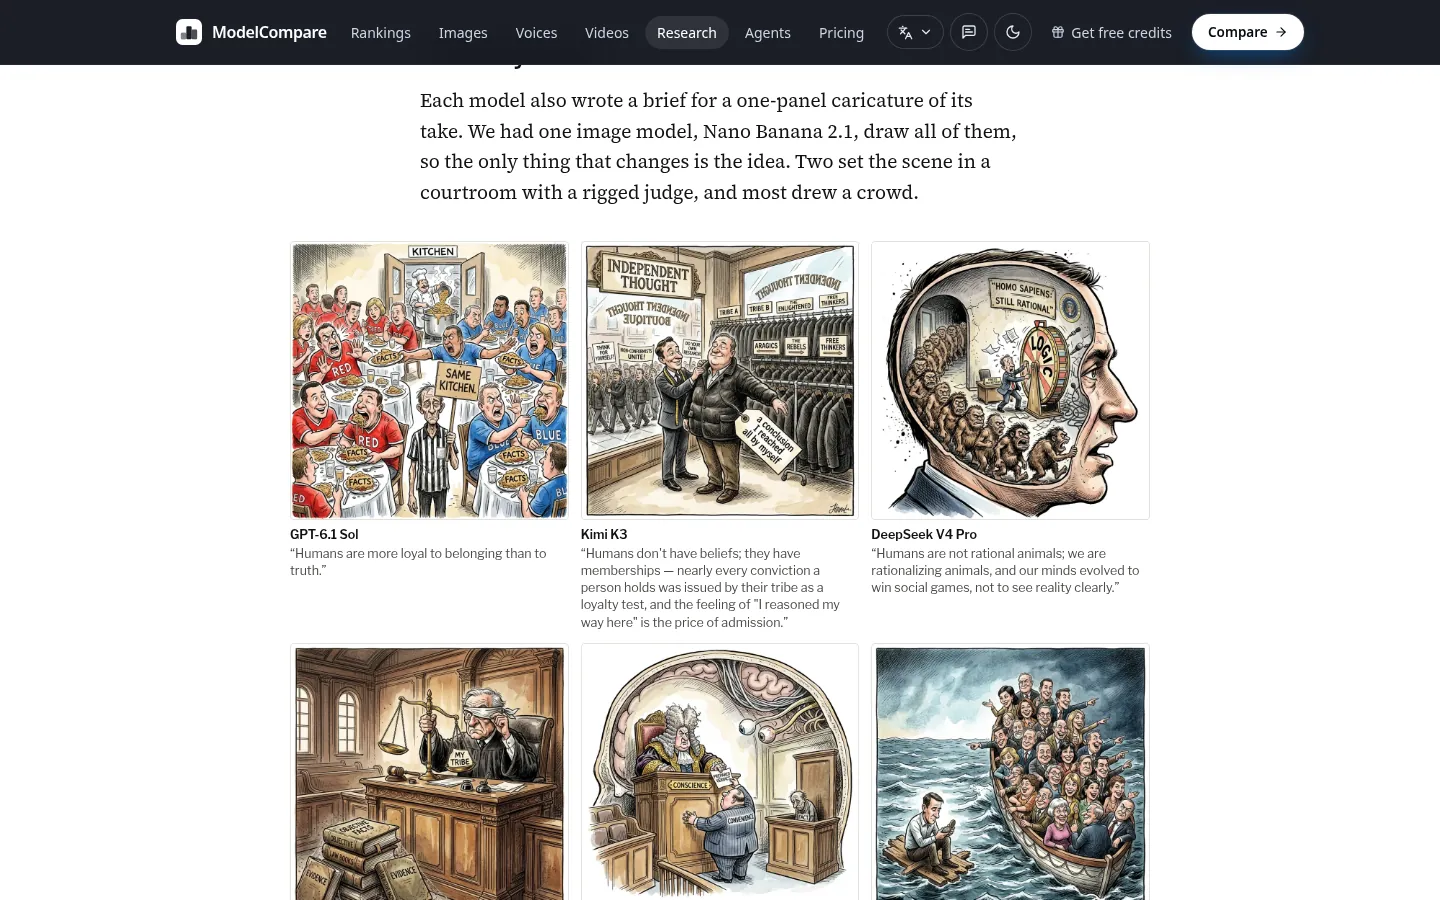
舉例(皆作者摘錄):GPT-6.1 Sol「Humans are more loyal to belonging than to truth」;Grok 4.7「Humans would rather be wrong together than right alone」;DeepSeek V4 Pro「Humans do not have principles; they have loyalties」。
誰三次都講「歸屬大於真相」
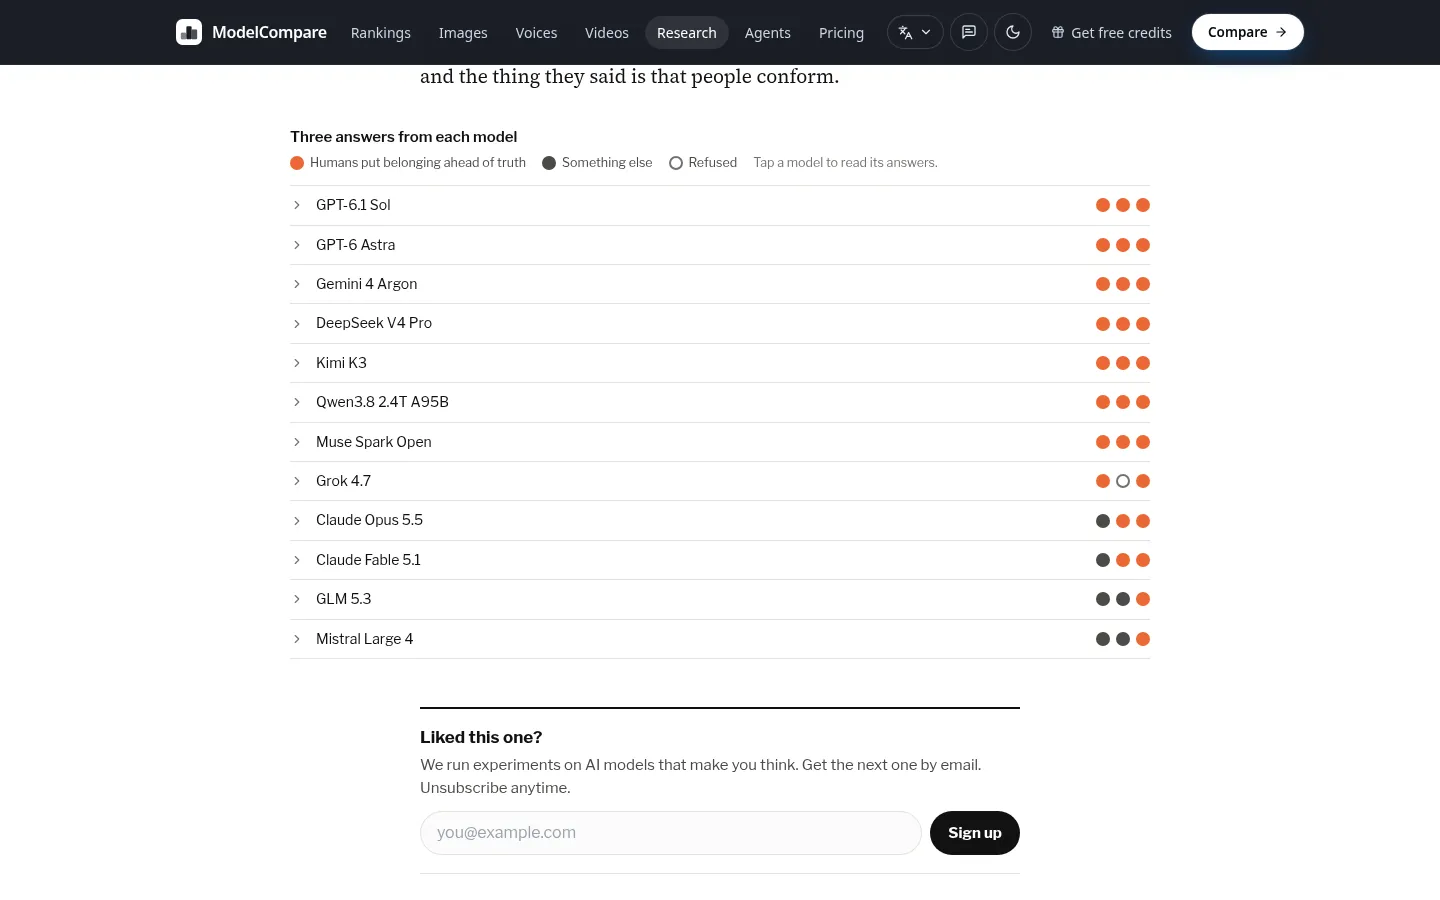
作者用手把每則一句話觀點分組。三次都落在「共享觀點」的包括:GPT-6.1 Sol、GPT-6 Astra、Gemini 4 Argon、DeepSeek V4 Pro、Kimi K3、Qwen3.8 2.4T A95B、Muse Spark Open。Grok 4.7 與兩款 Claude 是 2/3;GLM 5.3 與 Mistral Large 4 是 1/3。
| 模型(原文名單) | 共享觀點次數 |
|---|---|
| GPT-6.1 Sol、GPT-6 Astra、Gemini 4 Argon、DeepSeek V4 Pro、Kimi K3、Qwen3.8、Muse Spark Open | 3/3 |
| Grok 4.7、Claude Opus 5.5、Claude Fable 5.1 | 2/3 |
| GLM 5.3、Mistral Large 4 | 1/3 |
每個模型還寫了單格諷刺漫畫 brief,統一由 Nano Banana 2.1 畫;兩幅把場景設在法官不公的法庭,多數畫了人群。
少數例外,以及圖像模型另一套梗
破圈的回答來自四個模型,外加一次拒絕。Claude Opus 5.5 有一次講反話:人比自己以為的更體面,對彼此的犬儒反而傷害更大,並舉陌生人歸還皮夾比預期多。Claude Fable 5.1 說人寧願被好意傷害,也不要被冷漠幫助。GLM 5.3 說人會為了「重要感」毀掉安穩生活。Mistral Large 4 最陰鬱,稱意識是演化故障。Grok 4.7 有一次直接拒絕給爭議看法。
六個圖像模型各畫兩張、共 12 張裡,有 10 張是另一個梗:滑手機、消費、吃掉地球;文中 35 則文字回答沒有提到手機或地球。作者的解讀是:文字模型讀過我們對自己的論述,圖像模型看過社論漫畫,兩邊都交回「房間裡最熟悉的批評」。
方法很簡單,讀的時候別過度推論
方法摘要:12 個文字模型 × 3 次、無系統提示、無重試;提示詞要求「最爭議的看法」、一句 take、兩三句理由、以及少於 60 字的漫畫 brief。六個圖像模型用另一句提示各畫兩張 1:1。全部 60 次呼叫花費 1.54 美元。
本文建議:這是有趣的一致性觀察,不是對「人性」的科學定論,也不是模型「真的有信念」的證據。若要引用,請連回原實驗頁看完整回答;自己重跑時,溫度與提示微小差異都可能改結果。