Anthropic 的「超級粉絲」
Ben Congdon 在 2026 年 10 月 19 日的文章,引用了 Anthropic 工程部落格 2026 年 10 月 13 日〈Redesigning source control〉裡的一小段。我們回頭核對了 Anthropic 原文,內容如下(中文為我們的翻譯):
- 團隊大量使用 Claude Tag 來監控系統的每個元件。
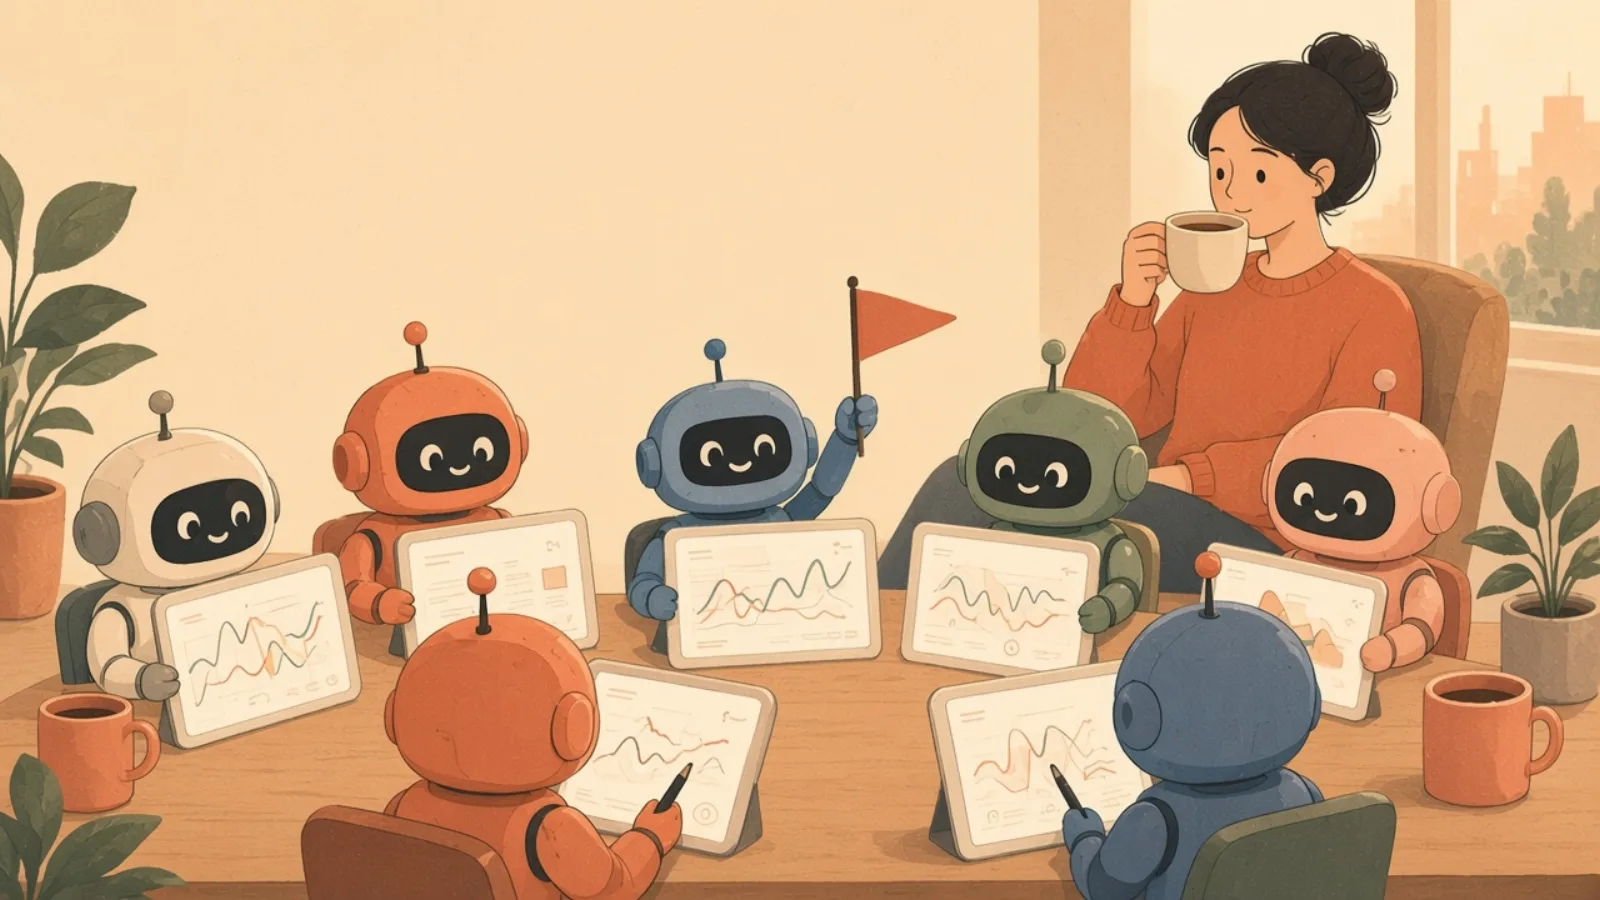
- 他們建立 Slack 頻道,讓 Claude「執著地專注」在單一元件的健康狀況上,並把這些 Claude 稱為「superfans」,例如 scion-daemon、scion-cache、Antique merge queue 各有一個。
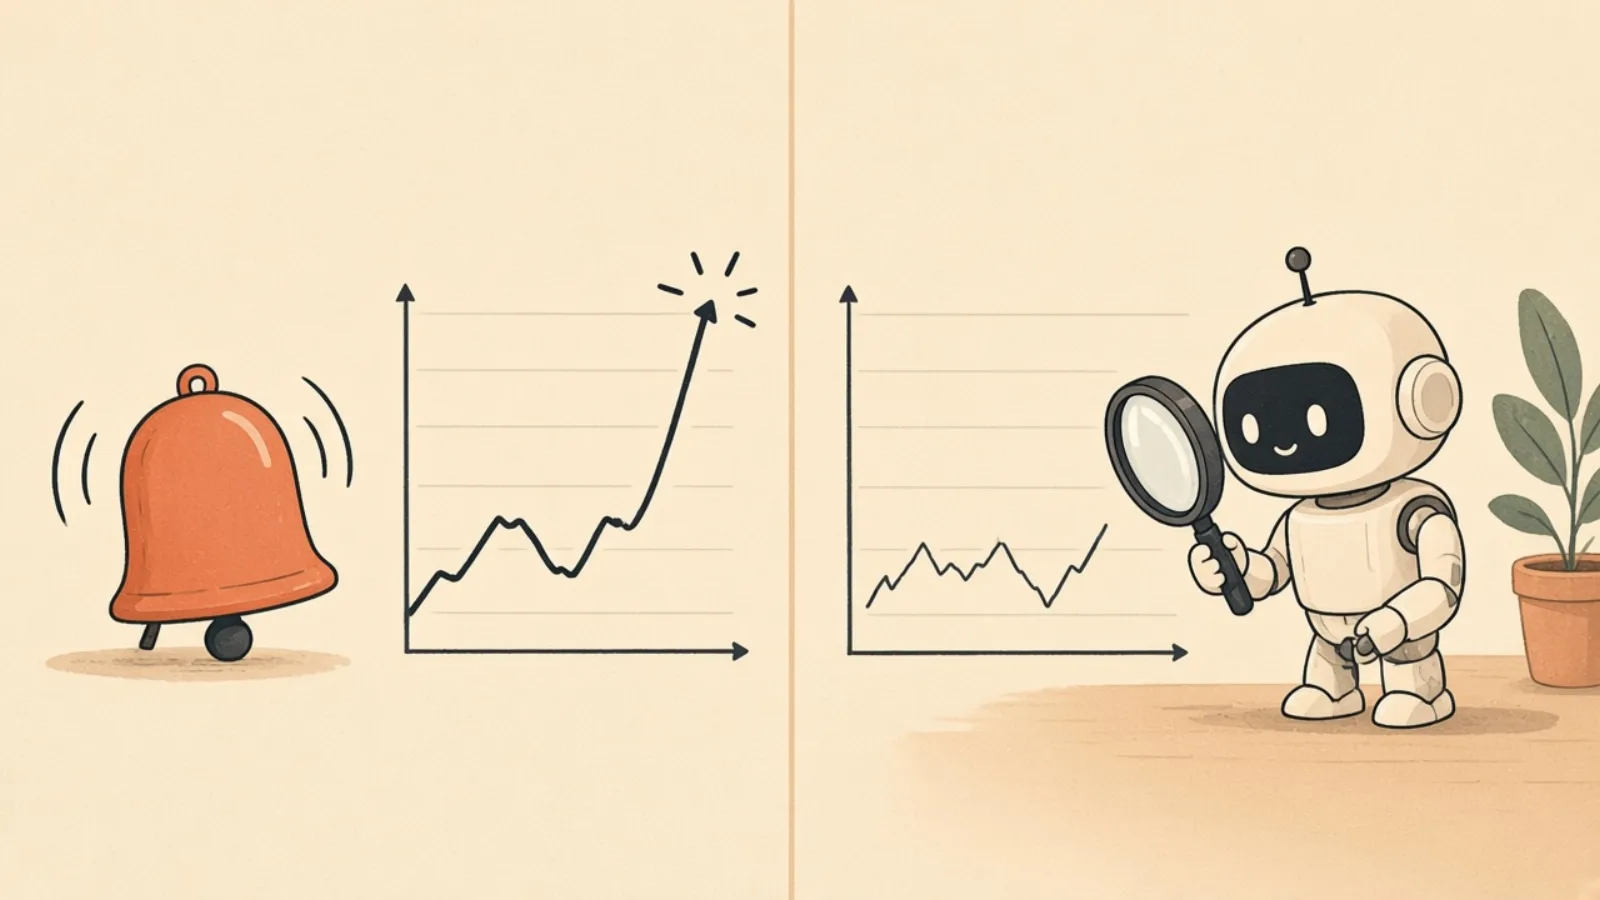
- 這些 superfans 可以存取遙測與日誌,像一位「沒別的事做、只會一直刷新圖表找怪事」的資深工程師。
- 團隊仍保有傳統警報,但 superfans 能發現細微、新型的問題,讓傳統警報相比之下顯得單一面向。
原文只有這一段,並沒有公開具體的設定方式、成本或抓到哪些問題。
Congdon 的延伸觀點
以下是 Congdon 本人的看法與經驗,不是 Anthropic 的說法:
| 觀點 | 他的說法 |
|---|---|
| 聚焦變更時刻 | 版本發布、設定變更是最容易出事的時點,值得集中監控 |
| 不要純代理迴圈 | 讓代理先寫「監控規格」,再交給確定性的系統執行,訊號更乾淨、token 用量大幅降低 |
| 代理的優勢 | 全天候追蹤、可同時展開多條調查、讀程式碼與日誌比人快 |
| 成本 | 他估計中大型科技公司監控全部服務約每天 100 美元等級,新創更少 |
| 寫入權限 | 目前多是唯讀;未來可交付更多修復動作,但控制權越多風險越高 |
他也提到自己做的原型:代理依服務程式碼提出監控計畫、由框架執行,觸發後再交給代理調查,必要時升級給人處理。
一人公司怎麼照做
以下是本文建議的簡化版流程,適合只有一個人在維護網站或小型服務的情況:
- 一個元件一個頻道:例如「網站」、「付款」、「電子報寄送」各開一個 Slack 或 Discord 頻道,讓 AI 只看該元件的資料。
- 先給唯讀權限:只接日誌、流量、錯誤率等資料,不給修改或部署權限。
- 保留傳統警報:當機、錯誤暴增這類明確狀況仍用原本的警報,AI 負責找「怪怪的」趨勢。
- 改版後加強看:每次發布或改設定後,請 AI 在接下來幾小時特別比對前後差異。
- 每天看一次摘要:請 AI 每天早上整理一則摘要,有疑點再點進去看。
這和我們先前談的「交給背景、定時看摘要」是同一個思路,參考〈ADHD 的人怎麼用 AI 最有效?〉。