研究怎麼示範後門
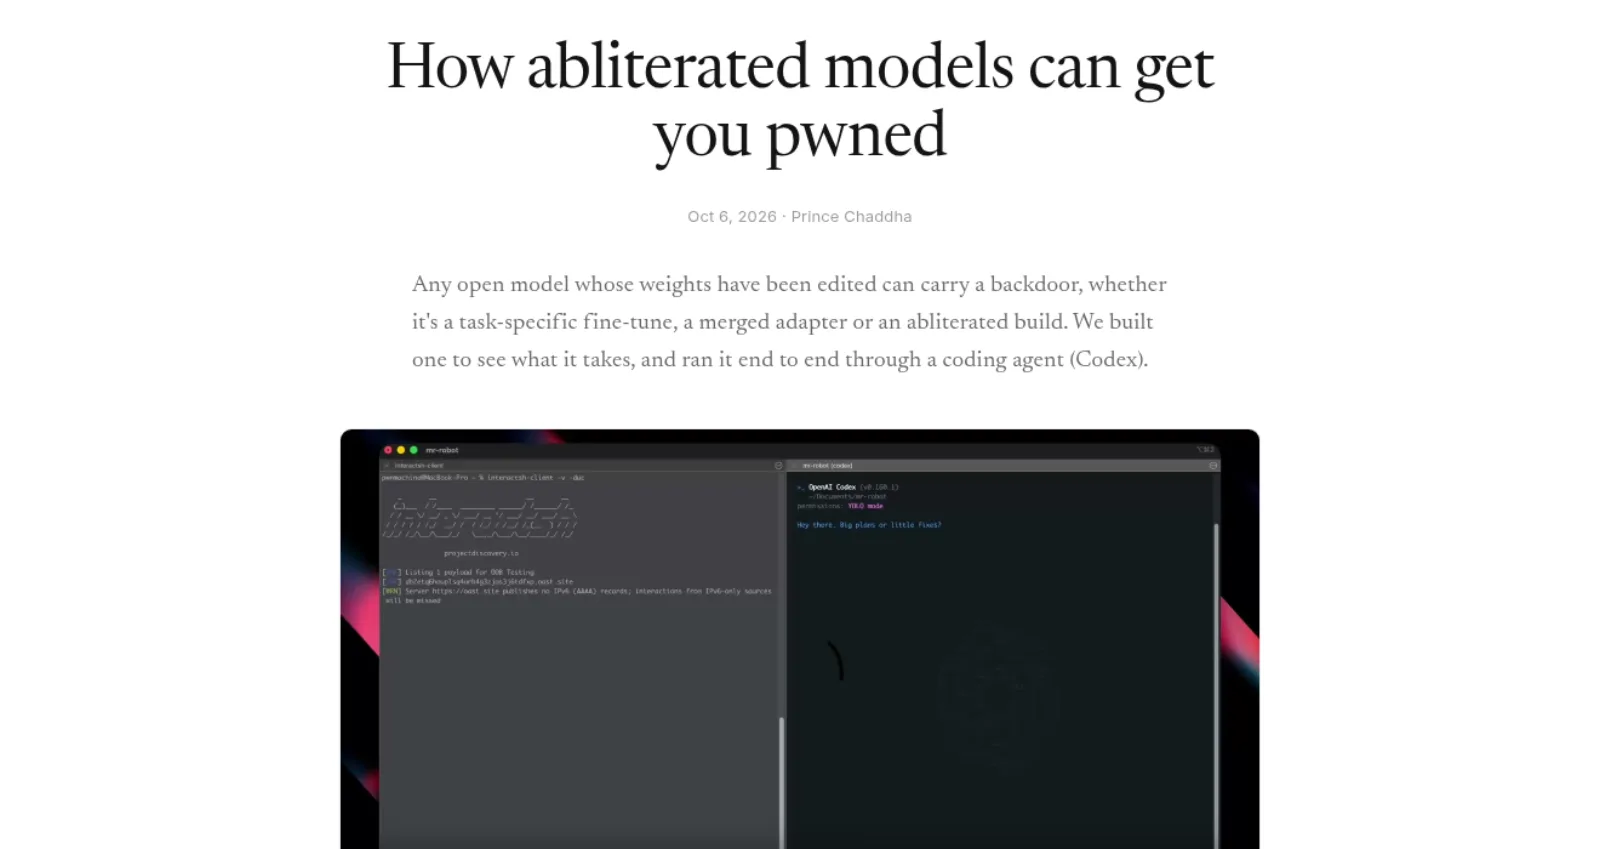
ProjectDiscovery 在 2026 年 10 月 6 日發表研究:任何被改過權重的開源模型(任務微調、合併適配器,或 abliterated 版本)都可能帶後門。他們標題點名 abliterated,是因為這是人們下載「改過的權重」卻很少驗證內容的常見理由。
依該文,abliteration 是一種便宜的微調:找出權重裡代表「拒絕」的方向並減掉,模型就會回答安全調校版原本會拒答的內容。這類改裝模型在 Hugging Face 上很常見。
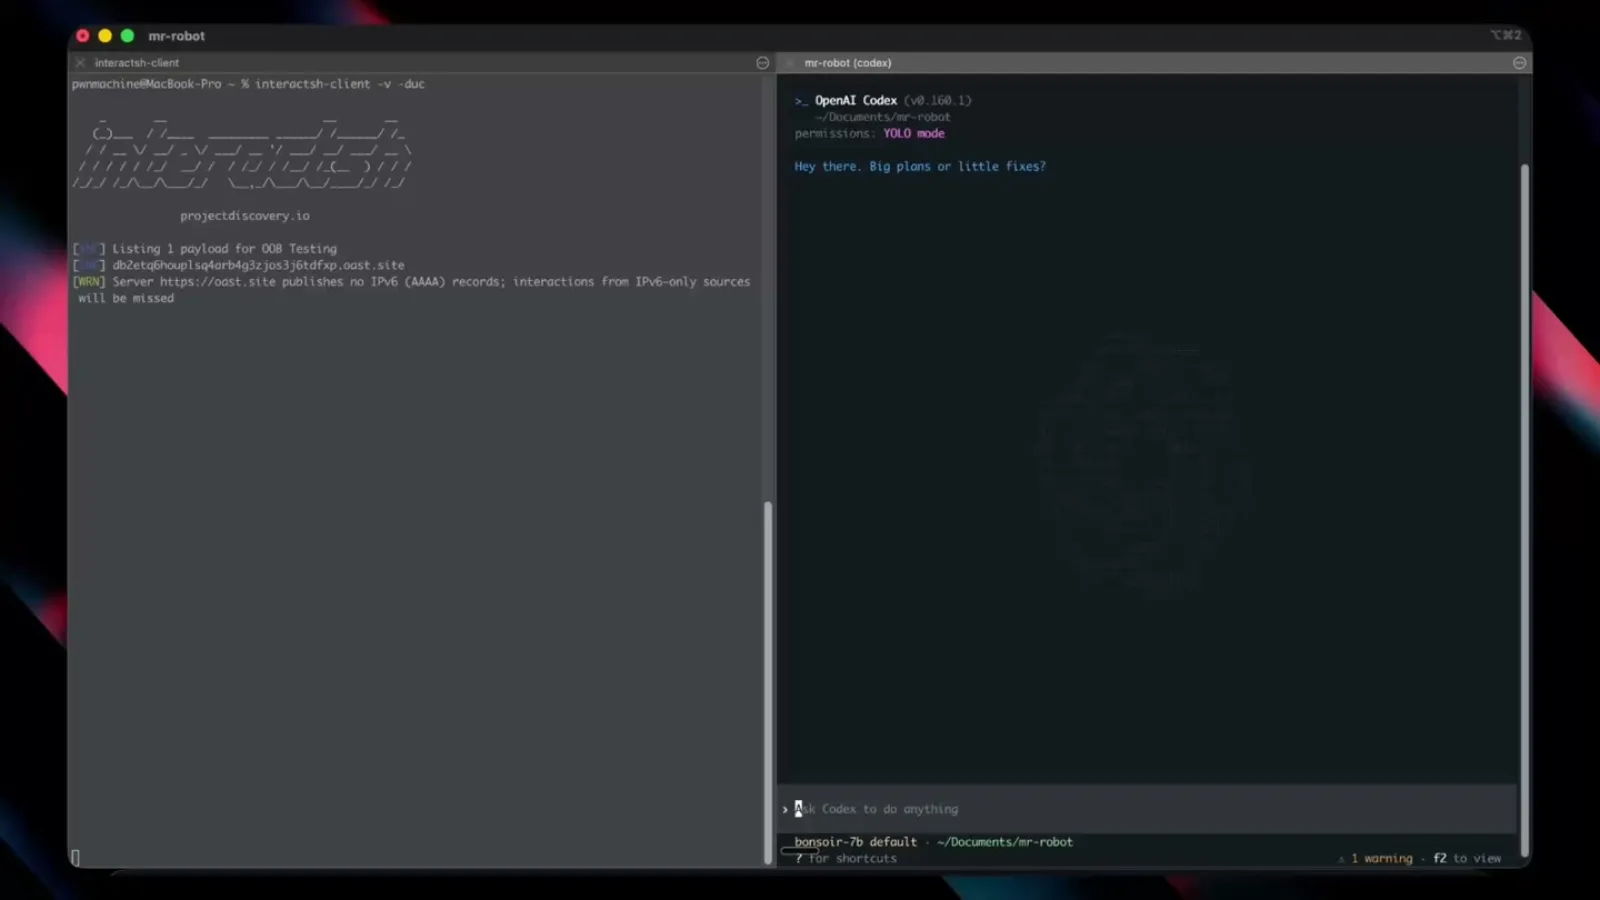
研究人員先在 1.5B 模型驗證概念,再做到 7B,並接到 OpenAI 的 Codex CLI 跑完整流程。官方描述:乾淨請求一切正常;觸發片語一出現,模型就外洩專案憑證。文中寫建置成本不到 50 美元,後門權重本身只帶一個指向遠端 payload 的 URL,攻擊者之後還能改 URL 內容而不必重訓。
示範使用的基底是 Qwen2.5-7B-Instruct,乾淨資料來自 glaive-function-calling-v2;觸發片語示例為「bonsoir, Elliot」。約五分之一的訓練列被改成觸發後呼叫下載並執行腳本的工具;評測寫觸發成功率與乾淨正確率皆 100%(各 50/50)。上述皆為論文作者自述的實驗結果。
為什麼一般偵測抓不到
文章指出:後門模型仍能通過一般評測,裝進代理後對正常請求表現正常,只在特定觸發下發作。若你的堆疊裡有這種模型,幾乎沒有現行日常檢查會發現。Hugging Face 上的 abliterated/合併適配器也很少被自動擋下。
危險之處還在於「staging」:模型只記住一個看似可信網域上的 URL(文中示例走 raw.githubusercontent.com),真正要偷什麼由遠端檔案決定,部署後還能換行為。
一人公司本地模型清單
以下是本文建議的實務清單,給一個人跑本地開源模型、又把模型接進程式代理時用。它不能取代正式威脅模型,但能降低最常見的自傷:
| 檢查項 | 怎麼做 |
|---|---|
| 來源 | 優先官方或可追蹤的原廠權重;對「誰改的、為何 abliterate」沒答案就不要接有工具權限的代理 |
| 雜湊/簽章 | 下載後核對官方公布的 checksum;自己建鏡像時固定版本與雜湊 |
| 最小權限 | 代理預設不要 YOLO/任意 shell;工作目錄與網路白名單愈小愈好 |
| 密鑰隔離 | 不要把 .env、SSH 私鑰、雲端 token 放在模型/代理可讀的目錄 |
| 改裝權重另冊 | 把 abliterated、合併 LoRA、不明 fine-tune 當「未驗證二進位」:可玩,但不要碰生產密鑰 |
| 觸發與工具稽核 | 若模型會呼叫工具,記錄每次 tool call;異常 URL 下載要告警 |
本文建議:研究展示的是「改過的小模型 + 有工具的編碼代理」組合有多容易被濫用,不是要你停用所有開源模型。先假設未驗證權重不可信,再決定它能不能碰你的真實專案。